Localement veut dire quelque chose d’inhabituel pour LongCat-2.5. Meituan a mis les poids sur Hugging Face le 9 novembre 2026, sous licence MIT, et la fiche du modèle donne une seule route de déploiement : les plateformes NPU, par un projet nommé SGLang-FluentLLM. Il n’y a aucun guide Nvidia dans la fiche, aucun fichier GGUF, et aucune version pour portable qui attendrait d’être trouvée. Notre reportage sur Meituan qui publie LongCat-2.5 sans Nvidia couvre la façon dont le modèle a été entraîné. Ce tutoriel couvre ce que demande son exécution sur votre propre matériel.
L’échelle est le sujet. LongCat-2.5 compte 1,6 billion de paramètres au total, avec environ 48 milliards actifs pour chaque jeton. Actif ne veut pas dire résident. Chaque expert doit rester en mémoire, prêt à être appelé par le routeur. Le guide que suit ce tutoriel charge les vrais poids sur un cluster de 194 cartes Ascend, et il le dit dans sa deuxième section, avant toute commande. Lisez ce tableau en premier. Si le matériel n’est pas là, le geste honnête est de s’arrêter à l’étape 1 et d’utiliser plutôt le clavardage ou l’API hébergés.
Ce que vous allez construire ou apprendre
Vous finirez avec LongCat-2.5 qui sert des requêtes d’images et de texte depuis votre propre cluster Atlas A2, derrière un seul point de terminaison HTTP qui parle le format de clavardage OpenAI. Le déploiement divise le travail en trois, dans un arrangement que le guide appelle EPD. Un service Encoder autonome transforme les images en jetons. Les nœuds Prefill lisent l’invite. Les nœuds Decode écrivent la réponse. Un petit répartiteur, MiniLB, se place devant et prend les requêtes.
Vous apprendrez aussi où se situent les limites. Le guide NPU couvre la version W4A4 seulement. W4A4 veut dire que les poids des experts et les activations roulent en entiers de 4 bits, un format que la fiche décrit comme natif pour les accélérateurs domestiques. Meituan rapporte que cette version garde une précision proche du modèle complet sur ses propres bancs évalués, et ces chiffres sont des chiffres de l’entreprise. Notre examen de recherche du modèle agent LongCat-2.5 sur Ascend pèse ces affirmations au complet.
Avant de commencer
Trois faits façonnent tout ce qui suit. D’abord, le guide déploie la version W4A4, depuis le dépôt Hugging Face distinct nommé LongCat-2.5-W4A4. Il ne donne aucune route NPU pour les poids BF16. Ensuite, le code de service vit sur une branche, pas sur la ligne principale. La branche se nomme longcat-2.5-npu dans le dépôt SGLang-FluentLLM, et le démarrage rapide de la branche principale vise plutôt les cartes Nvidia H20 et H800. Du code de la mauvaise branche ne roulera pas ce modèle sur un NPU. Enfin, les nœuds ont besoin d’un accès SSH sans mot de passe depuis un nœud de distribution, de rsync sur chaque nœud, et des fichiers réseau du cluster que le guide nomme, dont /etc/hccn.conf sur chaque nœud NPU. Préparez tout cela avant que les scripts de démarrage roulent, pas pendant qu’ils échouent.
Ce tutoriel suit le guide tel que publié et ne prétend pas à une exécution réelle. Aucun cluster Ascend ne se trouve dans ce bureau, et un tutoriel qui prétendrait le contraire mentirait sur la seule chose qui compte ici. Chaque commande ci dessous vient de la fiche du modèle ou du guide NPU, vérifiés le 15 novembre 2026.
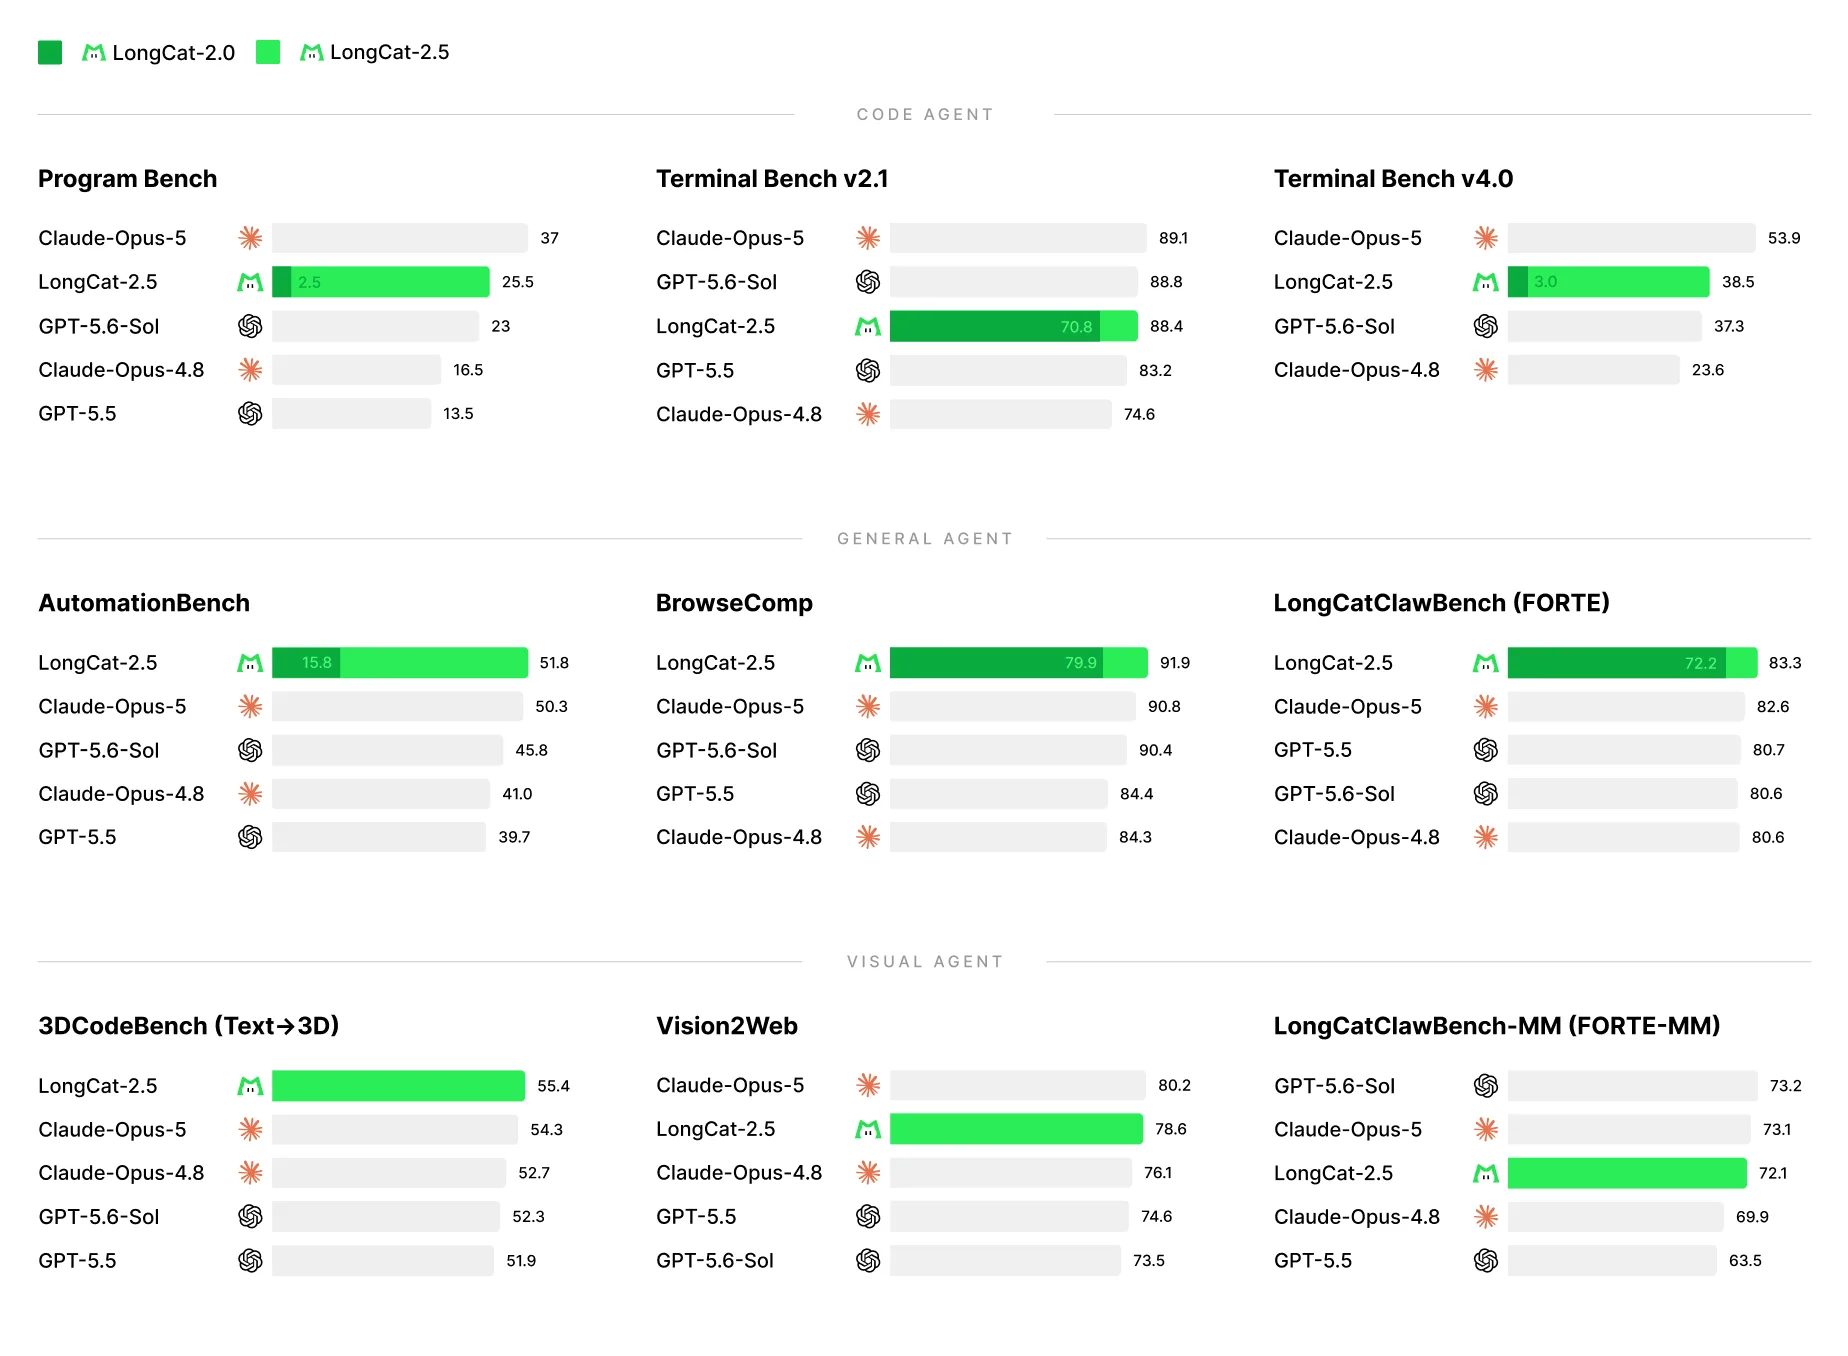 Les graphiques de la fiche du modèle, de Meituan. Les scores sans astérisque sont des chiffres de Meituan mesurés à l’interne, et la fiche les dit indicatifs seulement. Image : Meituan
Étape 1 : Auditer le matériel contre l’échelle documentée
Action : comptez vos cartes et comparez les au tableau de déploiement du guide NPU avant de toucher à tout logiciel. Le guide charge les vrais poids, pas un sous ensemble de test, et son tableau se lit comme suit.
| Rôle | Cartes | Ce qu’il fait |
|---|---|---|
| Encoder | 2 | Transforme l’entrée image en jetons que le modèle de langue peut lire |
| Prefill | 64 | Lit l’invite et construit le premier état |
| Decode | 128 | Écrit la réponse, jeton par jeton |
| Total | 194 | Cartes Atlas A2, dans des nœuds de 16 cartes chacun |
La liste de nœuds à l’étape 6 dit la même chose sous une deuxième forme. Le script de démarrage attend 8 nœuds Decode d’abord, puis 4 nœuds Prefill. À 16 cartes par nœud, cela donne les mêmes 128 et 64. L’Encoder roule à part, sur ses 2 cartes.
Résultat attendu : votre cluster correspond à la série Atlas A2 et au nombre de cartes, ou vous vous arrêtez ici. Un plus petit ensemble Atlas A2 n’a aucune voie documentée dans ce guide. Le guide ne donne aucune option à échelle réduite, aucune option à un seul nœud, et aucune option à poids partiels. Les équipes sans le matériel gardent la route hébergée à longcat.ai, que la fiche du modèle lie comme son site de clavardage.
Étape 2 : Installer le pilote et la pile CANN
Action : installez les logiciels de plateforme dans l’ordre que donne le guide. Commencez par le pilote Ascend HDK, version 25.0.RC1.1, ou le pilote que le document de compatibilité CANN apparie à CANN 9.0.0. Installez ensuite trois paquets CANN en versions appariées : le paquet de la trousse, le paquet d’opérateurs 910b, et le paquet NNAL qui porte la bibliothèque d’accélération ATB. Le guide nomme les formes de fichiers directement : Ascend-cann-toolkit_${version}_linux-${arch}.run, Ascend-cann-910b-ops_${version}_linux-${arch}.run, et Ascend-cann-nnal_${version}_linux-${arch}.run. Il pointe vers le document d’installation CANN pour la méthode elle même, alors suivez ce document plutôt que de deviner des options.
Installez ensuite Ascend Extension for PyTorch. Le guide exige les versions torch_npu et torchair appariées à PyTorch 2.9.0 et CANN 9.0.0. La dérive de version à cette couche est l’échec classique d’Ascend. Une version torch_npu faite pour une autre version de CANN va importer, puis échouer plus tard de façons qui pointent vers votre code de modèle plutôt que vers le mauvais appariement.
Résultat attendu : chaque nœud porte le même pilote, la même version de CANN, et la même paire PyTorch. Vérifiez un nœud, puis vérifiez que les autres correspondent exactement. Le guide énonce la règle clairement pour ses constructions de noyaux, et elle tient pour toute la pile : même version source, appariée à la puce, à l’architecture du processeur, et à la configuration Python et PyTorch de chaque nœud.
Étape 3 : Cloner la branche NPU et installer ses dépendances Python
Action : téléchargez le code de service et passez à la branche NPU avant d’installer quoi que ce soit depuis celui ci. Le guide donne cet ordre.
git clone https://github.com/meituan-longcat/SGLang-FluentLLM.git
cd SGLang-FluentLLM
git checkout longcat-2.5-npu
pip3 install -r ./npu_test/requirements.txt --no-deps
L’option --no-deps est dans le guide, et elle compte. Elle installe les paquets listés sans laisser pip tirer un deuxième ensemble de bibliothèques de plateforme non apparié par dessus la pile que vous avez construite à l’étape 2.
Résultat attendu : l’arbre de travail se trouve sur la branche longcat-2.5-npu, et l’installation des exigences se termine sans remplacer torch ni torch_npu. Si pip rapporte qu’il a changé l’un ou l’autre, reconstruisez ce nœud depuis l’étape 2. Le nom de la branche est aussi votre reçu. Le soutien EPD multimodal pour ce modèle existe sur cette branche, selon ses notes, et pas dans le moteur de la ligne principale.
Étape 4 : Construire et installer les noyaux personnalisés
Action : construisez le paquet flash-npu-kernel depuis la racine du projet. C’est l’étape la plus longue, et le guide la divise en trois constructions qui doivent toutes aboutir : un paquet d’opérateurs CANN, puis deux roues Python. Chargez d’abord la configuration de construction.
source "${ASCEND_TOOLKIT_ENV:-/usr/local/Ascend/ascend-toolkit/set_env.sh}"
source "${ATB_ENV:-/usr/local/Ascend/nnal/atb/set_env.sh}"
: "${ASCEND_HOME_PATH:?Load the CANN setup first and set ASCEND_HOME_PATH}"
python3 -m pip install setuptools wheel ninja
Si votre script de configuration CANN vit à /usr/local/Ascend/cann/set_env.sh, réglez d’abord ASCEND_TOOLKIT_ENV à ce chemin, comme le note le guide. Construisez et installez ensuite le paquet d’opérateurs CANN pour la puce Atlas A2, nommée ascend910b dans la commande de construction.
cd flash-npu-kernel/cann-flash-ops
bash build.sh -c ascend910b
bash "output/CANN-flash-ops-linux.$(uname -m).run" --quiet --install-path="${ASCEND_HOME_PATH}"
source "${ASCEND_HOME_PATH}/vendors/flash_ops/bin/set_env.bash"
Construisez ensuite les deux paquets Python. Le guide avertit que flash_ops et flash_npu_kernel sont deux paquets différents et que chacun a besoin de sa propre installation. Il avertit aussi que le premier script de construction construit seulement sa roue, avec la ligne d’installation commentée, alors la ligne pip explicite ci dessous est ce qui l’installe vraiment.
cd flash-npu-kernel/cann-flash-ops/torch_ops_extension
bash build_and_install.sh
python3 -m pip install --force-reinstall --no-deps dist/flash_ops-*.whl
cd flash-npu-kernel/flash_ops
bash build.sh
python3 -m pip install --force-reinstall --no-deps dist/flash_npu_kernel-*.whl
Lancez ces constructions depuis les bons dossiers, en revenant à la racine du projet entre elles selon ce que votre propre discipline de terminal exige. Lancez ensuite la vérification que donne le guide.
python3 -c "import torch, torch_npu, flash_ops, flash_npu_kernel; print('NPU available:', torch.npu.is_available())"
Résultat attendu : la ligne d’import roule et rapporte qu’un NPU est disponible. Répétez toute l’étape sur chaque nœud d’inférence, avec la même version source sur chacun. Chaque nœud qui servira le modèle plus tard a aussi besoin de la configuration CANN, de la configuration ATB, et du fichier de configuration flash_ops chargés dans sa configuration de démarrage. Le guide le souligne pour les démarrages SSH par lot en particulier, où le terminal distant démarre sans aucun d’eux chargé.
 L’Encoder, le Prefill et le Decode roulent comme des services distincts dans ce déploiement, liés à travers le réseau du cluster. Illustration : Dirty Static
Étape 5 : Télécharger les poids W4A4
Action : téléchargez les poids W4A4 vers un chemin local que chaque nœud de service peut atteindre, avec la méthode que donne le guide. Elle utilise l’outil de ligne de commande Hugging Face et le dépôt W4A4, pas le dépôt BF16.
pip install -U huggingface_hub
mkdir -p /data/meituan-longcat
hf download meituan-longcat/LongCat-2.5-W4A4 --local-dir /data/meituan-longcat/LongCat-2.5-W4A4
L’Encoder a aussi besoin de ses propres poids assortis. L’étape 7 pointe le service Encoder vers un chemin de poids Encoder, alors récupérez les poids Encoder que nomme l’exemple du guide et placez les au chemin que vous utiliserez là.
Résultat attendu : le dossier W4A4 se trouve complet au chemin que vous nommerez MODEL_PATH à l’étape 6. Le guide exige que ce chemin soit absolu, sans espaces et sans caractères génériques. Vérifiez la taille du dossier contre la liste du dépôt avant d’aller plus loin. Un téléchargement partiel qui passe un coup d’œil rapide va échouer des heures plus tard, au chargement du modèle, sur 194 cartes à la fois.
Étape 6 : Régler les variables du cluster
Action : sur le nœud de distribution, réglez les quatre valeurs que lit le script de démarrage. Le guide fixe les noms et les règles d’ordre, et la règle d’ordre est la partie que les gens se trompent.
export MODEL_PATH=/data/meituan-longcat/LongCat-2.5-W4A4
export ENCODER_URLS=http://encoder-node0:9101
export iplist="decode-node0 decode-node1 decode-node2 decode-node3
decode-node4 decode-node5 decode-node6 decode-node7
prefill-node0 prefill-node1 prefill-node2 prefill-node3"
export testpath=/data/longcat25
export time=longcat25
L’ordre de iplist est fixe : les 8 premiers hôtes sont les nœuds Decode, les 4 derniers sont les nœuds Prefill. Les noms doivent se résoudre et se joindre à travers le cluster. ENCODER_URLS prend des adresses HTTP séparées par des virgules, sans espaces. Le guide ajoute trois règles pratiques ici. Réglez SSH_USER et SSH_PORT si les valeurs par défaut de votre utilisateur actuel et du port 22 ne conviennent pas. Gardez testpath à part du dossier source, et utilisez un dossier cible neuf pour chaque nouvelle version, pour que les fichiers d’une construction plus vieille ne restent pas dans une nouvelle. Assurez vous que les réglages réseau HCCL, Gloo et Mooncake correspondent à votre réseau de cluster, et que le chemin HTTP de l’Encoder, le chemin de retour des résultats encodés, et le chemin de transfert KV du Prefill au Decode peuvent tous se joindre.
Résultat attendu : les actions start, startp et startd ont MODEL_PATH et ENCODER_URLS réglés, ce que le guide exige, et les actions status et log ont la liste de nœuds dont elles ont besoin.
Étape 7 : Démarrer l’Encoder
Action : sur le nœud Encoder, depuis la racine du projet, pointez MODEL_PATH vers les poids Encoder et démarrez le service Encoder.
export MODEL_PATH=/data/meituan-longcat/LongCat-2.5-Encoder
export ENCODER_NPU_DEVICES=0,1
bash npu_test/flash26b/run_encoder_epd.sh
Le guide donne les valeurs par défaut qu’il vaut de connaître avant d’en changer une. L’Encoder utilise une taille de parallélisme de tenseur de 2, sert HTTP sur le port 9101, et produit un format qu’il nomme rvq_indices. Le port peut bouger par ENCODER_HTTP_PORT si 9101 entre en conflit sur votre réseau.
Résultat attendu : l’Encoder répond sur son chemin de santé, que la section Vérification contrôle. Ne démarrez rien d’autre avant qu’il le fasse. Le Prefill et le Decode prennent l’adresse de l’Encoder comme un réglage, et un Encoder manquant se transforme en échecs d’invite qui ressemblent à des échecs de modèle.
Étape 8 : Distribuer le code et démarrer le Prefill, le Decode et MiniLB
Action : retournez au nœud de distribution, réglez les variables de l’étape 6 encore, avec MODEL_PATH qui pointe vers les poids W4A4, et prévisualisez le démarrage avant de le lancer. Le guide intègre un mode d’essai à blanc au script, et sur un cluster de cette taille la prévisualisation n’est pas une prudence optionnelle. C’est la révision la moins chère que les commandes auront jamais.
DRY_RUN=1 bash npu_test/flash26b/run_pro_w4a4kv8_mm_epd.sh start
bash npu_test/flash26b/run_pro_w4a4kv8_mm_epd.sh code
bash npu_test/flash26b/run_pro_w4a4kv8_mm_epd.sh start
L’action code copie le code vers chaque nœud Prefill et Decode, dans le dossier testpath, avec rsync. L’action start lance ensuite le Prefill, le Decode et MiniLB. MiniLB démarre sur le dernier nœud Prefill de votre liste, sur le port 8081 par défaut. Le script prend aussi startp pour démarrer seulement les 4 nœuds Prefill plus MiniLB, startd pour démarrer seulement les 8 nœuds Decode, et une deuxième valeur optionnelle comme étiquette de journal, que les actions de journal doivent ensuite assortir.
Le guide nomme les réglages de démarrage pour que vous puissiez les repérer dans les journaux. Le Prefill et le Decode démarrent avec les poids W4A4, le cache KV en INT8, le décodage spéculatif MTP de style NEXTN, et les options --enable-multimodal --language-only. Cette dernière option embrouille les gens à la première lecture. Elle veut dire que les nœuds Prefill et Decode roulent la partie langue seulement, parce que l’Encoder distinct de l’étape 7 fait le travail visuel. Le service entier répond quand même aux requêtes d’images. Le Prefill roule avec un parallélisme de pipeline de 8 et un parallélisme de tenseur d’attention de 8. Le Decode roule avec un parallélisme KV de 8, un parallélisme de données de 16, et un parallélisme d’experts de 128.
Résultat attendu : le démarrage se termine sur les 12 nœuds de service. Si le code se trouve déjà au même chemin sur chaque nœud depuis un passage antérieur, le guide dit que vous pouvez lancer start directement et sauter l’action code.
Vérification
Contrôlez le résultat dans l’ordre que donne le guide, de l’extérieur vers l’intérieur.
D’abord, demandez le statut au script, et lisez les journaux de nœuds qu’il pointe. Les journaux se trouvent sur chaque nœud dans le dossier testpath, dans un fichier nommé pour votre étiquette time.
bash npu_test/flash26b/run_pro_w4a4kv8_mm_epd.sh status
Ensuite, cherchez la ligne de succès que nomme le guide. Sur les nœuds de rang 0 du Decode et du Prefill, un bon démarrage se termine par cette ligne dans le journal.
INFO - The server is fired up and ready to roll!
Puis, vérifiez les trois chemins de santé. L’Encoder a son propre port, et le Prefill et le Decode en partagent un autre.
curl --fail http://encoder-node0:9101/health
curl --fail http://prefill-node0:6080/health
curl --fail http://decode-node0:6080/health
Enfin, envoyez une vraie requête d’image à MiniLB, à l’adresse du dernier nœud Prefill, sur le port 8081. Remplacez l’adresse de l’image par une que votre cluster peut joindre. Le nom de modèle servi par défaut est LongCat-2.5.
export service_ip=prefill-node3
curl -X POST http://${service_ip}:8081/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "LongCat-2.5",
    "messages": [
      {"role": "user", "content": [
        {"type": "text", "text": "Describe this image."},
        {"type": "image_url", "image_url": {"url": "https://example.com/image.jpg"}}
      ]}
    ],
    "max_tokens": 1024,
    "temperature": 0.7,
    "stream": false
  }'
Une réponse JSON qui décrit l’image, depuis votre propre point de terminaison, est le résultat que toute la construction vise. Pour le travail en texte seulement après cela, la fiche du modèle montre les contrôles de réflexion qui valent d’être connus. LongCat-2.5 est un modèle hybride. Il prend enable_thinking réglé à True ou False par les réglages du gabarit de clavardage dans la requête, et save_history_reasoning_content réglé à True garde le texte de raisonnement dans l’historique, ce que la fiche recommande pour de meilleurs résultats avec la réflexion activée. Les réglages d’évaluation de la fiche elle même utilisent la réflexion activée, une température de 1,0 et un top_p de 0,95.
Dépannage
| Problème | Cause probable | Correction |
|---|---|---|
| Le contrôle d’import des noyaux échoue sur flash_ops ou flash_npu_kernel | Les deux roues sont des paquets distincts, et le premier script de construction construit sa roue sans l’installer | Lancez les lignes pip explicites de l’étape 4 pour les deux roues, sur le nœud qui échoue |
| La construction s’arrête sur une erreur ASCEND_HOME_PATH | Les scripts de configuration CANN n’ont pas été chargés dans ce terminal | Chargez d’abord les fichiers de configuration de la trousse et de ATB, exactement comme l’étape 4 ouvre, puis relancez |
| Le Prefill démarre où le Decode devrait être, ou l’inverse | L’ordre de iplist est mauvais | Placez les 8 nœuds Decode en premier et les 4 nœuds Prefill en dernier, comme l’énonce l’étape 6, puis redémarrez |
| Le contrôle de santé de l’Encoder échoue | Le service Encoder n’a jamais démarré, ou son port a bougé | Démarrez l’Encoder depuis l’étape 7 d’abord, et vérifiez ENCODER_HTTP_PORT si vous l’avez changé de 9101 |
| L’action code échoue sur certains nœuds | SSH ou rsync n’est pas prêt entre le nœud de distribution et ces nœuds | Configurez SSH sans mot de passe, confirmez les empreintes d’hôte, et installez rsync sur chaque nœud, comme l’exige le guide |
| Un nœud charge du code d’une construction plus vieille | testpath garde encore des fichiers d’une version antérieure | Utilisez un testpath neuf pour la nouvelle version, à part du dossier source, comme le guide conseille |
| Les requêtes atteignent MiniLB mais les invites d’images échouent | Le chemin de retour de l’Encoder vers le Prefill et le Decode est bloqué, ou ENCODER_URLS nomme la mauvaise adresse | Vérifiez ENCODER_URLS contre l’adresse et le port réels de l’Encoder, et confirmez que le chemin des résultats encodés peut traverser le réseau du cluster |
| Un outil comme vLLM ou llama.cpp ne charge pas les poids | La fiche du modèle ne documente aucune route par eux | Utilisez la branche NPU de SGLang-FluentLLM dans ce tutoriel. Aucune autre route de service n’est documentée dans la fiche |
Prochaines étapes
Placez une passerelle que vous contrôlez devant MiniLB avant que quiconque hors de l’équipe d’exploitation touche le point de terminaison. Le point de terminaison du guide prend des requêtes de clavardage brutes, et il n’a aucune couche de compte propre. Les limites de débit, les journaux de requêtes et les règles d’accès appartiennent à cette passerelle, réglés par vous.
Notez ensuite la construction exacte que vous avez lancée : la version de CANN, la version du pilote, le commit de la branche, et la version source des noyaux, par groupe de nœuds. Sur un cluster de cette taille, la prochaine mise à niveau est une reconstruction, et l’équipe qui la fera aura besoin de savoir quel ensemble apparié a produit un service qui marche. Quand une branche plus neuve arrive, traitez la comme un nouveau déploiement. Un testpath neuf, un essai à blanc neuf, les mêmes contrôles de santé dans le même ordre.
Faits vérifiés le 15 novembre 2026, contre la fiche du modèle LongCat-2.5 sur Hugging Face et le guide de déploiement NPU dans le dépôt SGLang-FluentLLM, branche longcat-2.5-npu. Ce tutoriel suit ces documents et ne prétend pas à une exécution de bout en bout sur notre propre matériel.
Sources
- Taille du modèle, paramètres actifs, quantification W4A4, réglages du mode de réflexion, réglages d’évaluation, et le pointeur de déploiement NPU : Fiche du modèle LongCat-2.5, Meituan sur Hugging Face
- Échelle de déploiement, exigences de matériel et de logiciels, constructions CANN et de noyaux, téléchargement des poids, variables du cluster, scripts de démarrage de l’Encoder et du Prefill et du Decode, contrôles de santé, et l’exemple de requête d’image : Guide de déploiement NPU LongCat 2.5 W4A4, SGLang-FluentLLM
- Le moteur de service, sa base SGLang, et la note de branche pour l’inférence multimodale W4A4 sur Ascend A2 : Dépôt SGLang-FluentLLM, Meituan
- Poids W4A4 : LongCat-2.5-W4A4, Meituan sur Hugging Face
- Graphique de bancs dans le corps : Meituan, depuis la fiche du modèle ci dessus. Illustrations du héros et de EPD : Dirty Static.
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.