Dirty Static // Le verdict
Un modèle agent sérieux sur papier et une API peu coûteuse à essayer, mais chaque score est un score du fournisseur et la voie documentée pour un hébergement autonome exige un groupe de 194 puces Ascend.
Idéal pourLes équipes qui veulent tester un modèle agent à bas prix par une API en premier, et les ateliers Ascend qui peuvent vraiment faire tourner le groupe documenté
Ce qui fonctionne
- Les scores agent du fournisseur sont proches de Claude Opus 5 et de GPT-5.6 Sol sur Terminal Bench v2.1, à 88,4 contre 89,1 et 88,8
- Les poids sont publiés sous la licence MIT, donc un usage commercial et des tests externes sont permis
- API aux formats OpenAI et Anthropic, qui se branche dans Claude Code, Codex et Hermes
- Le prix de lancement est bas, à environ 0,30 dollar par million de jetons en entrée et 1,20 dollar par million de jetons en sortie
- Les images entrent comme jetons natifs à côté du texte, ce qui convient au codage visuel et au travail de conception
Ce qui ne fonctionne pas
- Aucun test indépendant publié dans la couverture consultée le 15 novembre, donc chaque score ici est un score de Meituan
- Le guide exemple pour un hébergement autonome utilise 194 puces Huawei Ascend Atlas A2, ce qui place cette voie en territoire de centre de données
- Le guide ne donne aucune voie pour les GPU Nvidia, donc la plupart des ateliers occidentaux n ont aucune route documentée pour faire tourner les poids
- Les limites de sortie diffèrent selon les documents de Meituan, avec 128 000 jetons dans la couverture de lancement et 256 000 jetons dans les documents de paramètres
- Sur les tests plus durs, écart se creuse, avec 38,5 sur Terminal Bench v4.0 contre 53,9 pour Claude Opus 5 dans le même tableau du fournisseur
Test fondé sur la recherche : basé sur des essais publiés, des spécifications et de la documentation, et non sur des essais pratiques.
LongCat-2.5 est arrivé avec une affirmation sur le matériel en premier et une affirmation sur le modèle en second. Meituan dit que le modèle a été entraîné sur des accélérateurs chinois seulement, et les poids sont arrivés le 10 novembre sous la licence MIT. La question pour un acheteur est plus simple que la politique autour du sujet. Ce modèle fait il assez bien le travail agent pour gagner une place dans une pile, et que coûte son usage là où vous travaillez vraiment?
Ce test répond à partir de documents publiés seulement. Dirty Static n a pas fait tourner le modèle. Chaque score ci dessous vient du tableau de Meituan, rapporté par The Decoder le 15 novembre, et aucun test indépendant n avait été publié dans la couverture consultée ce jour là. Traitez les scores comme des affirmations avec des chiffres, pas comme des résultats réglés.
Ce que c est
LongCat-2.5 est un modèle à mélange d experts construit par équipe LongCat chez Meituan, entreprise chinoise de livraison de repas qui dirige maintenant un laboratoire de modèles sérieux. Un modèle à mélange d experts divise son travail entre plusieurs petits sous réseaux et n en réveille que certains pour chaque jeton. Voilà pourquoi la taille totale et le coût de fonctionnement peuvent raconter des histoires différentes. Le total est de 1,6 billion de paramètres. Le nombre actif par jeton est d environ 48 milliards.
Le modèle a été construit pour des agents qui travaillent sur de longues tâches en plusieurs étapes, avec le codage comme cas principal. Il prend du texte, des images et de la vidéo en entrée et retourne du texte. Les utilisateurs peuvent activer ou couper son mode de raisonnement. Il repose sur LongCat-2.0 et ajoute la compréhension des images comme compétence nouvelle principale.
Pour entraînement, Meituan a utilisé de vraies tâches logicielles tirées de demandes de fusion GitHub, plus des échecs d agents reconstruits comme tâches d entraînement. Dans ces cadres, équipe a bloqué accès à internet, retiré historique Git et les fichiers en cache, et utilisé un autre modèle de langue pour vérifier les solutions à la recherche de trucs. Ce détail compte pour un test. Il suggère que équipe a essayé d empêcher le modèle de tricher sur ses propres devoirs, même si les scores finaux ont encore besoin de vérifications externes.
Fonctions et spécifications
| Domaine | LongCat-2.5 |
|---|---|
| Fabricant | Équipe LongCat chez Meituan |
| Annoncé | 2 novembre 2026 |
| Poids publiés | 10 novembre 2026, sous la licence MIT |
| Paramètres au total | 1,6 billion |
| Actifs par jeton | Environ 48 milliards |
| Notes d architecture | 768 experts routés avec un routage des 12 premiers, selon la configuration du modèle |
| Contexte par API | Jusqu à 1 million de jetons |
| Sortie maximale | 128 000 jetons dans la couverture de lancement; 256 000 jetons dans les documents de paramètres |
| Entrées | Texte, images et vidéo |
| Sortie | Texte |
| Raisonnement | Peut être activé ou coupé |
| Version quantifiée | Poids et activations des experts à 4 bits pour un travail natif sur les accélérateurs nationaux |
| Déploiement exemple | 194 puces Huawei Ascend Atlas A2 |
| Formats API | OpenAI et Anthropic |
| Harnais agent nommés | Claude Code, Codex et Hermes |
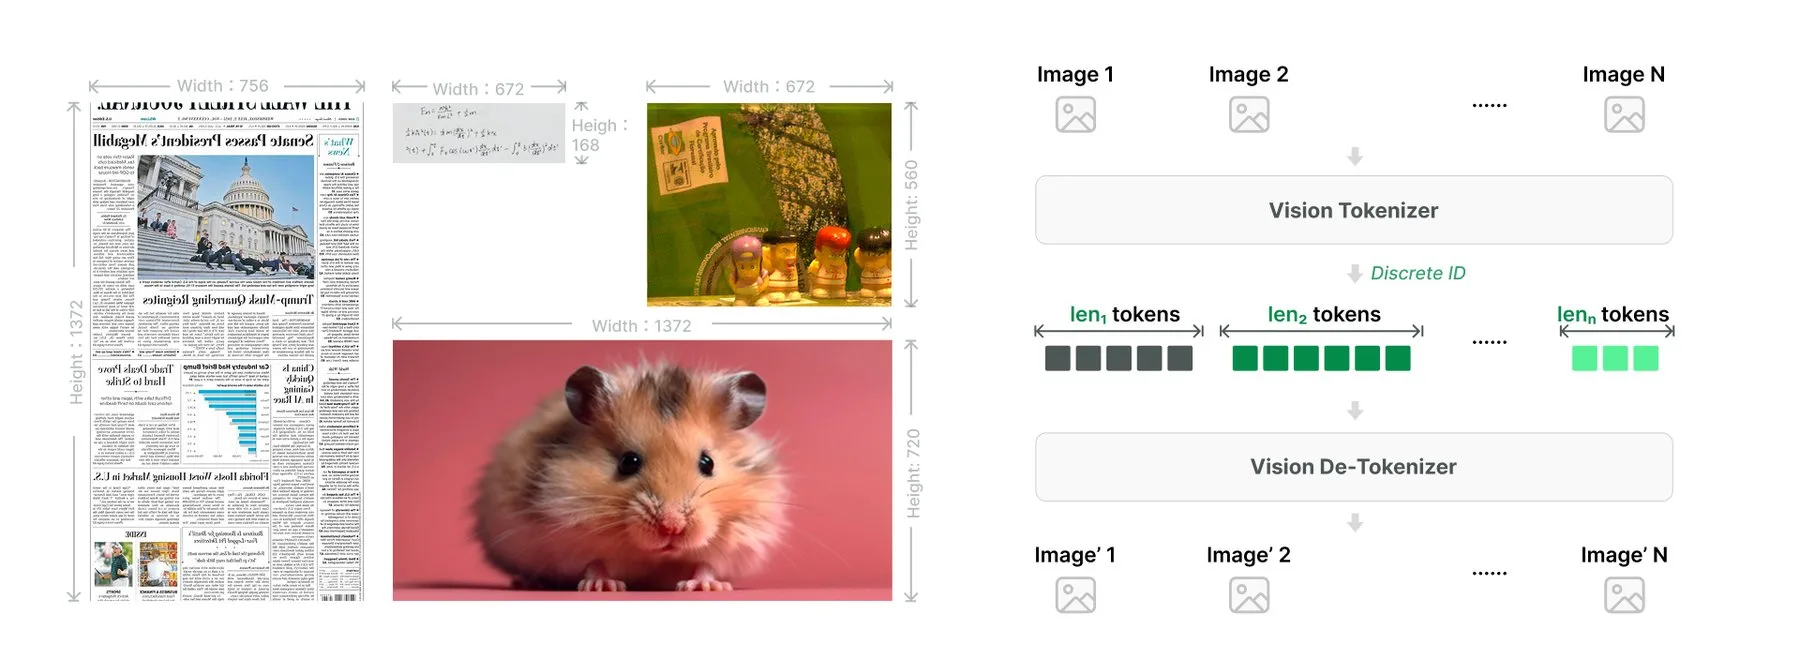
La voie des images mérite un regard plus proche. Plusieurs modèles attachent un encodeur d images séparé à un modèle de texte après coup. LongCat-2.5 découpe plutôt une image à sa taille native en jetons discrets et lit ces jetons dans le même flux que le texte. Meituan dit que cela devrait aider le codage visuel, le travail de conception et les tâches 3D. C est une affirmation sur intention de conception. Les scores visuels dans le tableau du fournisseur lui donnent un certain appui, et des tests visuels externes lui en donneront plus ou lui en retireront.
La différence sur la limite de sortie est une petite chose qui raconte une plus grande histoire. La couverture de lancement a placé le plafond à 128 000 jetons. Des documents de paramètres consultés par d autres critiques le placent à 262 144 jetons, ce qui arrondit à 256 000. Les deux chiffres viennent de documents de Meituan. Une équipe qui planifie de longues courses d agent devrait confirmer le plafond sur son propre compte avant de concevoir autour de un ou de autre chiffre. Notre rapport de nouvelles sur la publication des poids de LongCat-2.5 couvre annonce sur le matériel au complet.
Expérience dans le monde réel
Cette section est une discussion fondée sur la recherche, pas un journal de test. Elle repose sur la carte du modèle, le guide de déploiement tel que rapporté par The Decoder, les documents de prix, et le petit ensemble de critiques externes qui ont vérifié ces documents en novembre.
Commencez par la route que la plupart des équipes prendront vraiment, soit API. Le prix est attrait. Les documents de prix donnent environ 0,30 dollar par million de jetons en entrée, 0,006 dollar pour entrée en cache, et 1,20 dollar par million de jetons en sortie, sous une étiquette de durée limitée sans date de fin donnée. The Decoder a placé le même prix de lancement à environ 0,27 euro en entrée et 1,07 euro en sortie. À ces taux, une équipe peut mener un vrai essai agent pour le coût d un repas d équipe et apprendre plus que tout tableau de scores peut lui enseigner.
Accès aide aussi. API parle le format OpenAI et le format Anthropic. Cela veut dire que des outils construits pour une pile peuvent souvent pointer vers LongCat-2.5 avec un changement d adresse de base et une nouvelle clé. Meituan nomme Claude Code, Codex et Hermes comme harnais qui fonctionnent avec le modèle. Pour un modèle agent, cet ajustement compte autant que les scores bruts, car les agents vivent dans des harnais, pas dans des boîtes de clavardage.
Terminal Bench v2.1 scores, vendor table
Scores from Meituan evaluation table as reported by The Decoder, November 15, 2026. All figures are vendor reported. No independent run had been published in the coverage checked.
Les scores du fournisseur se divisent en deux histoires. Sur Terminal Bench v2.1, qui teste le travail agent en ligne de commande, LongCat-2.5 se place à 88,4 dans un groupe serré près du sommet. Sur BrowseComp, un test de recherche web, Meituan rapporte 91,9, le score le plus élevé de son tableau, même si entreprise a mené ce test dans son propre cadre. Sur DeepSWE, qui teste la correction de bogues dans du vrai code, le modèle saute de 9,7 pour LongCat-2.0 à 64,6, un gain important qui le laisse quand même derrière la plupart des rivaux du tableau.
Le test plus dur raconte histoire plus froide. Sur Terminal Bench v4.0, LongCat-2.5 obtient 38,5. Cela dépasse GPT-5.6 Sol à 37,3 dans le même tableau et reste bien sous Claude Opus 5 à 53,9. Une lecture juste est que le modèle gère le travail agent courant à un niveau proche des meneurs, et que les meneurs s éloignent quand les tâches deviennent longues et confuses. C est aussi le motif que les acheteurs d agents voient dans la plupart des nouveaux modèles, donc le résultat est plausible. Plausible n est pas la même chose que prouvé.
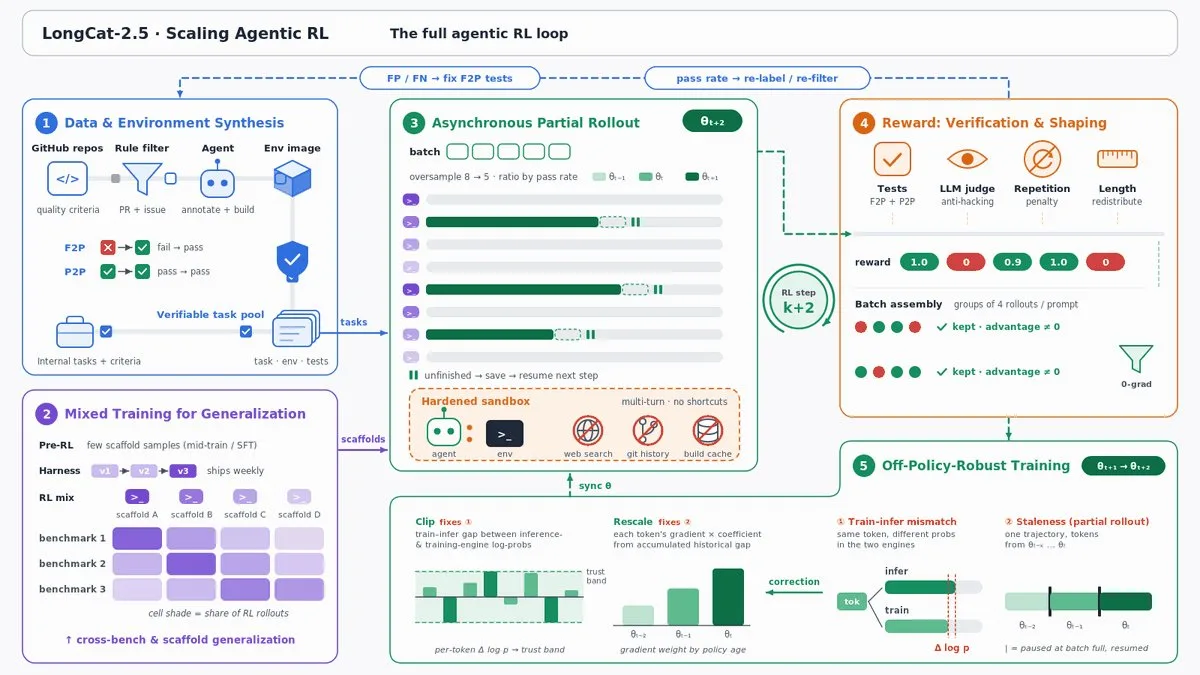
Hébergement autonome est là où le test devient dur. Le guide documenté quantifie les poids et les activations des experts à 4 bits, un format que les puces chinoises gèrent de façon native. Meituan dit que cette version a haussé le débit des invites de 43,3 pour cent et le débit des réponses de 42,77 pour cent face à une version 8 bits dans ses propres tests de charge, avec une précision égale. Ce sont des tests de charge du fournisseur. Le groupe dans le guide est la partie concrète. Il utilise 194 puces Huawei Ascend Atlas A2, avec 2 pour le travail des images, 64 pour entrée des invites et 128 pour la génération des réponses. Il n y a aucun conseil Nvidia dans le guide.
Cette forme décide à qui cette publication s adresse. Un atelier qui fait déjà tourner du matériel Ascend reçoit un grand modèle agent réglé pour ses bâtis dès le premier jour. Un atelier sur du matériel Nvidia reçoit une API et une page de clavardage, plus des poids qu il n a aucune voie documentée pour servir. Les deux groupes peuvent utiliser le modèle. Un seul groupe peut posséder son fonctionnement.
Ce qui fonctionne
Le accent sur les agents est réel dans la conception, pas seulement dans le marketing. Les tâches d entraînement venaient de vraies demandes de fusion. Les cas d échec ont été reconstruits comme leçons. Le bac à sable a bloqué les triches faciles. Les modèles entraînés ainsi tendent à mieux se comporter dans les harnais que les modèles entraînés sur des données de clavardage seulement, et le saut sur DeepSWE de 9,7 à 64,6, même comme chiffre du fournisseur, pointe dans cette direction.
La licence et le prix fonctionnent ensemble. Les termes MIT laissent une entreprise utiliser les poids dans un produit sans négociation de licence. Le prix API laisse une équipe tester le modèle cette semaine sans combat d approvisionnement. Ajoutez API à double format et le soutien nommé des harnais, et le chemin d essai est à peu près aussi court que cette classe le permet. À titre de comparaison, la question de contrôle dans notre rapport sur les agents gérés Claude hébergés de façon autonome est la même que LongCat soulève de autre côté du monde. Qui fait tourner agent, et sur les puces de qui?
Ce qui ne fonctionne pas
Le problème de preuve vient en premier. Tech Times a noté le 3 novembre que chaque affirmation de performance à ce moment venait des propres tests de Meituan. La couverture de la publication des poids deux semaines plus tard ne citait toujours aucun test indépendant. Tant qu un laboratoire sans intérêt dans le résultat ne publie pas ses propres chiffres, un acheteur note les devoirs de Meituan avec un corrigé de Meituan.
La taille est le second problème. Seulement 48 milliards de paramètres se réveillent par jeton, mais le total complet de 1,6 billion doit quand même vivre quelque part et se charger de quelque part. La carte du modèle donne 208 fichiers de poids et environ 3,56 billions d octets de stockage. Personne ne fait tourner cela sur un poste de travail. La version 4 bits coupe le coût de service, et elle exige quand même un groupe que la plupart des entreprises loueront plutôt que posséder, si elles peuvent louer de la capacité Ascend du tout.
La dérive de la documentation est le troisième problème, et le plus facile à corriger. Les plafonds de sortie diffèrent selon les propres documents de Meituan. Les chiffres de contexte diffèrent entre la configuration du modèle et le discours API. Rien de cela n est fatal, et tout cela coûte du temps à un nouvel utilisateur qu un ensemble de documents plus serré économiserait.
Concurrence
| Modèle | Accès | Score agent dans le tableau du fournisseur | Voie d hébergement autonome |
|---|---|---|---|
| LongCat-2.5 | Poids MIT plus API hébergée | Terminal Bench v2.1 à 88,4, rapporté par le fournisseur | Documentée sur 194 puces Ascend Atlas A2 seulement |
| Claude Opus 5 | API hébergée seulement | Terminal Bench v2.1 à 89,1 et v4.0 à 53,9, tels que donnés par Meituan | Aucune |
| GPT-5.6 Sol | API hébergée seulement | Terminal Bench v2.1 à 88,8 et v4.0 à 37,3, tels que donnés par Meituan | Aucune |
| DeepSeek V4.1 Flash | Ligne de poids ouverts de DeepSeek | Terminal Bench v2.1 à 90,6, tel que donné par Meituan | Service communautaire large sur des piles GPU courantes |
Le tableau utilise les chiffres de Meituan pour les rivaux aussi, donc lisez le comme une carte d affirmations, pas comme un classement. La forme aide quand même une décision. Claude et GPT restent les choix hébergés sûrs, avec le score le plus fort sur le test dur dans ce tableau qui appartient à Opus 5. DeepSeek offre la route ouverte que la plupart des ateliers GPU peuvent vraiment servir aujourd hui. LongCat-2.5 offre la route ouverte construite pour Ascend, à un prix API qui bat la salle tant que la promotion dure.
Verdict final
Essayez LongCat-2.5 par son API si vous menez du travail agent et que votre harnais parle le format OpenAI ou Anthropic. Essai est peu coûteux, installation est courte, et vos propres tâches vous en diront plus en un jour que le tableau du fournisseur peut le faire. C est la façon honnête de tester un modèle dont les scores viennent tous de son fabricant.
Choisissez le pour un hébergement autonome seulement si votre monde tourne déjà sur Ascend. Pour cet atelier, c est une chose rare, un modèle agent à échelle de frontière réglé pour son matériel dès le départ, avec une version quantifiée et un guide de groupe complet. Pour tout autre atelier, attendez. Attendez des tests indépendants, attendez un soutien de service communautaire sur des GPU courants, ou attendez un petit frère qui tient sur de vrais bâtis. Le modèle peut bien gagner ses scores. Le 15 novembre, la preuve qu il avait fait cela était encore la parole de Meituan, et un acheteur prudent tarife une affirmation comme une affirmation.
Ce test est fondé sur la recherche. Il repose sur la carte du modèle et les documents de prix de Meituan, le rapport de The Decoder du 15 novembre 2026, et des vérifications de documents externes de novembre 2026. Aucun test pratique n a été fait. Faits vérifiés le 15 novembre 2026.
Sources
- The Decoder, Meituan releases a 1.6 trillion parameter agent model that never touched an Nvidia GPU, 15 novembre 2026. Tableau de scores, méthode des jetons d image, tâches d entraînement, tests de charge 4 bits, déploiement à 194 puces et prix de lancement en euros.
- Équipe LongCat de Meituan, carte du modèle pour LongCat-2.5 sur Hugging Face, consultée le 15 novembre 2026. Licence MIT, configuration d architecture, fichiers de poids, taille de stockage et notes sur la version quantifiée.
- Documents de prix et de paramètres de la plateforme LongCat, consultés dans la couverture de novembre 2026. Prix de durée limitée d environ 0,30 dollar par million de jetons en entrée et 1,20 dollar par million de jetons en sortie, et le chiffre de sortie de 256 000 jetons dans les documents de paramètres.
- Tech Times, rapport du 3 novembre 2026, notant que toutes les affirmations de scores à cette date venaient des propres tests de Meituan sans évaluateur indépendant.
- Images de produit: Meituan via The Decoder, créditées à chaque figure. Image principale et autres illustrations: Dirty Static.
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.