Localmente significa algo inusual para LongCat-2.5. Meituan puso los pesos en Hugging Face el 9 de noviembre de 2026, bajo la licencia MIT, y la ficha del modelo da una sola ruta de despliegue: plataformas NPU, por medio de un proyecto llamado SGLang-FluentLLM. No hay ninguna guía Nvidia en la ficha, ningún archivo GGUF, y ninguna versión para portátil esperando ser encontrada. Nuestro reportaje sobre Meituan publicando LongCat-2.5 sin Nvidia cubre cómo se entrenó el modelo. Este tutorial cubre lo que pide ejecutarlo en tu propio hardware.
La escala es el tema. LongCat-2.5 guarda 1,6 billones de parámetros en total, con unos 48 mil millones activos por cada token. Activo no es lo mismo que residente. Cada experto tiene que estar en memoria, listo para que el enrutador lo llame. La guía que sigue este tutorial carga los pesos reales en un clúster de 194 tarjetas Ascend, y lo dice en su segunda sección, antes de que aparezca cualquier comando. Lee esa tabla primero. Si el hardware no está ahí, el gesto honesto es parar en el Paso 1 y usar en cambio el chat o la API alojados.
Lo que vas a construir o aprender
Terminarás con LongCat-2.5 sirviendo pedidos de imagen y texto desde tu propio clúster Atlas A2, detrás de un solo punto de conexión HTTP que habla el formato de chat de OpenAI. El despliegue divide el trabajo en tres, en un arreglo que la guía llama EPD. Un servicio Encoder independiente convierte las imágenes en tokens. Los nodos Prefill leen la instrucción. Los nodos Decode escriben la respuesta. Un balanceador pequeño, MiniLB, se pone al frente y toma los pedidos.
También aprenderás dónde están los límites. La guía NPU cubre la versión W4A4 solamente. W4A4 significa que los pesos de los expertos y las activaciones corren como enteros de 4 bits, un formato que la ficha describe como nativo para los aceleradores domésticos. Meituan reporta que esta versión mantiene una precisión cercana al modelo completo en sus propios bancos evaluados, y esas cifras son cifras de la empresa. Nuestro examen de investigación del modelo agente LongCat-2.5 en Ascend pesa esas afirmaciones por completo.
Antes de empezar
Tres hechos dan forma a todo lo que sigue. Primero, la guía despliega la versión W4A4, desde el repositorio de Hugging Face separado llamado LongCat-2.5-W4A4. No da ninguna ruta NPU para los pesos BF16. Segundo, el código de servicio vive en una rama, no en la línea principal. La rama se llama longcat-2.5-npu en el repositorio SGLang-FluentLLM, y el inicio rápido de la rama principal apunta en cambio a tarjetas Nvidia H20 y H800. Código de la rama equivocada no correrá este modelo en un NPU. Tercero, los nodos necesitan acceso SSH sin contraseña desde un nodo de distribución, rsync en cada nodo, y los archivos de red del clúster que nombra la guía, incluido /etc/hccn.conf en cada nodo NPU. Prepara todo eso antes de que corran los scripts de inicio, no mientras fallan.
Este tutorial sigue la guía tal como se publicó y no afirma una ejecución real. Ningún clúster Ascend está en esta oficina, y un tutorial que fingiera lo contrario mentiría sobre lo único que importa aquí. Cada comando siguiente viene de la ficha del modelo o de la guía NPU, verificados el 15 de noviembre de 2026.
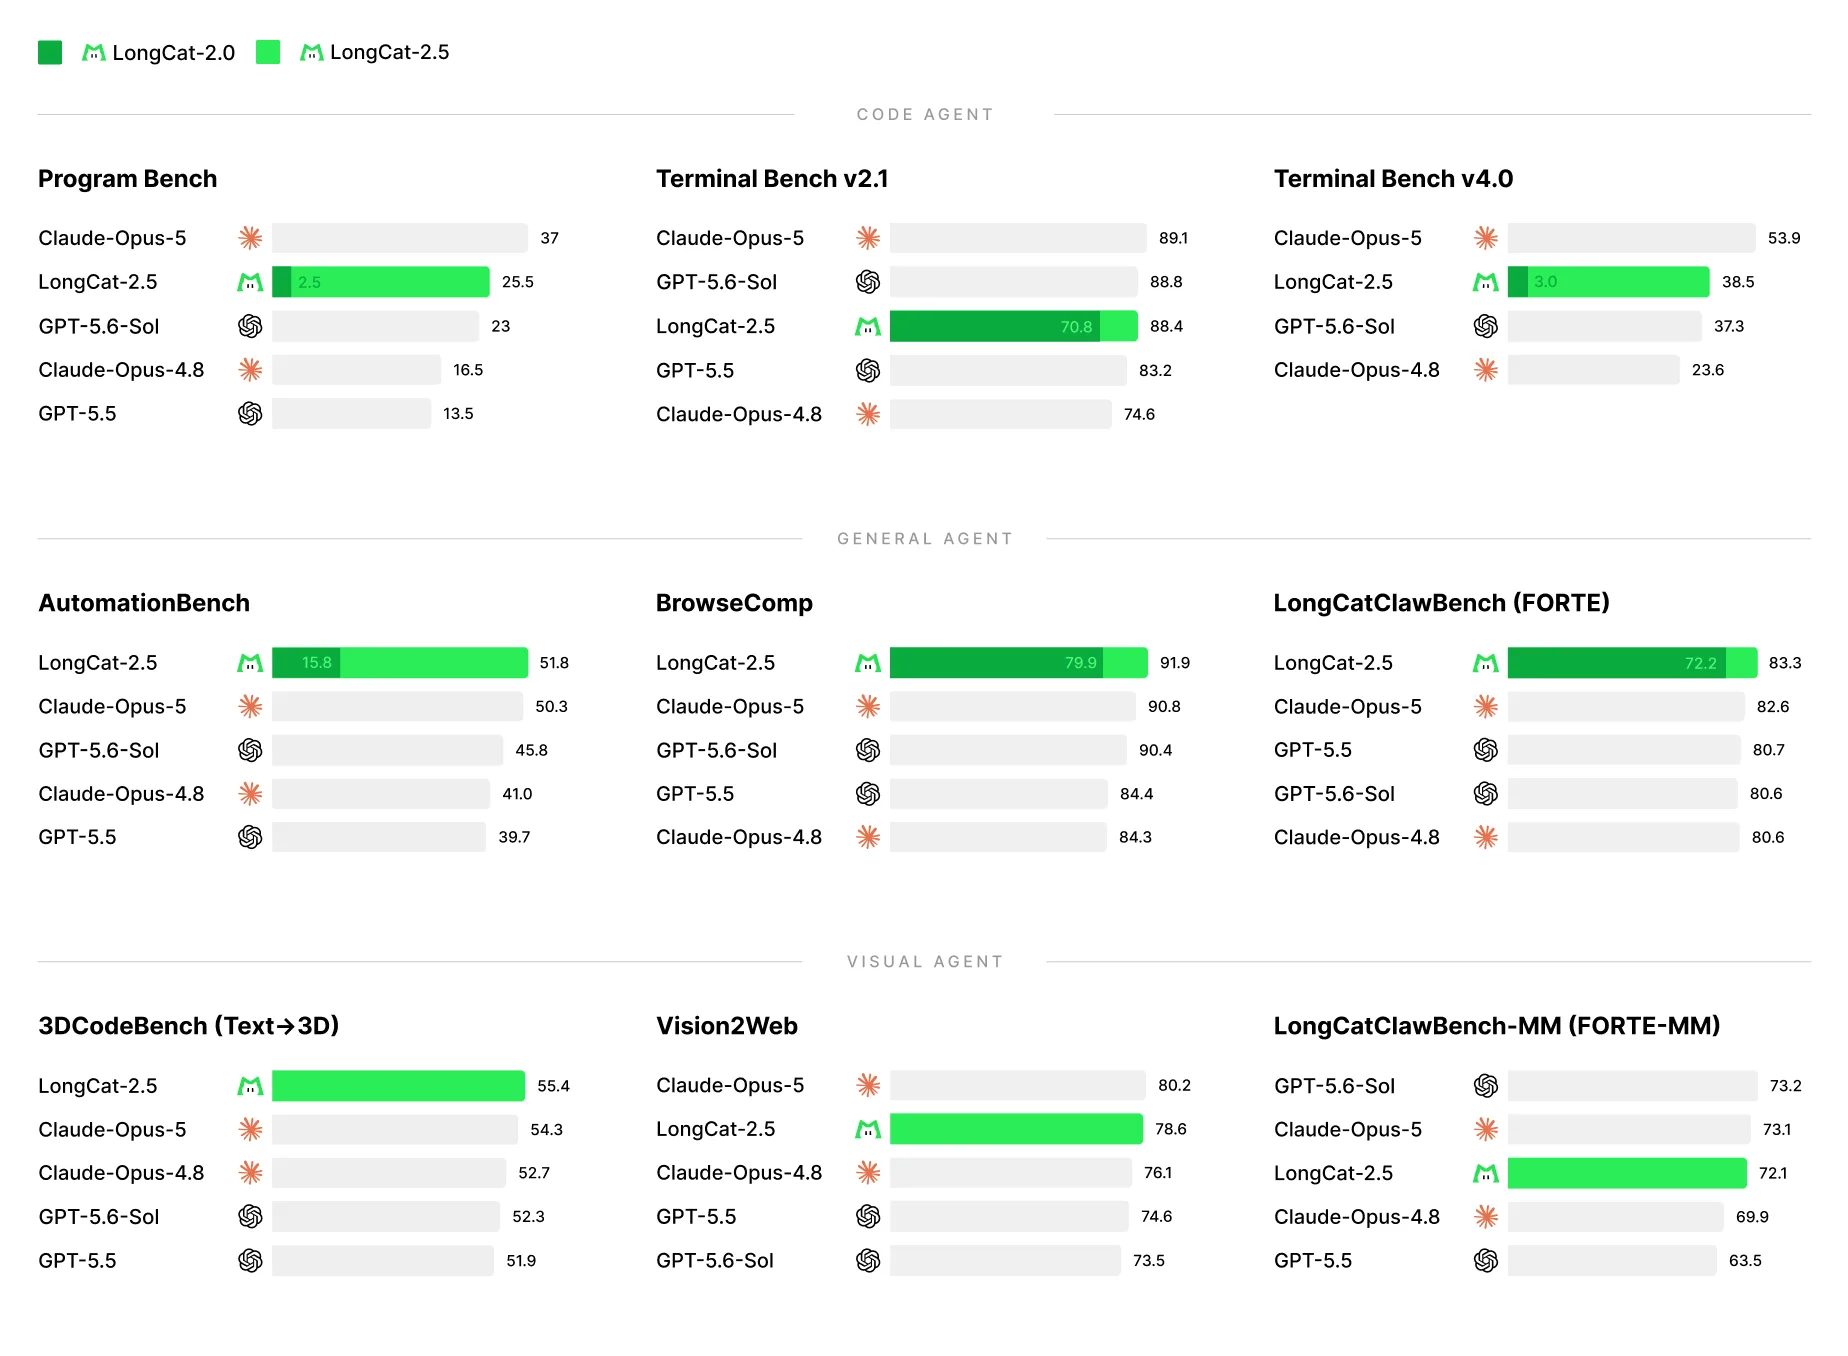 Los gráficos de la ficha del modelo, de Meituan. Los puntajes sin asterisco son cifras de Meituan medidas en casa, y la ficha los llama indicativos solamente. Imagen: Meituan
Paso 1: Audita el hardware contra la escala documentada
Acción: cuenta tus tarjetas y compáralas con la tabla de despliegue de la guía NPU antes de tocar cualquier software. La guía carga los pesos reales, no un subconjunto de prueba, y su tabla se lee así.
| Rol | Tarjetas | Lo que hace |
|---|---|---|
| Encoder | 2 | Convierte la entrada de imagen en tokens que el modelo de lenguaje puede leer |
| Prefill | 64 | Lee la instrucción y construye el primer estado |
| Decode | 128 | Escribe la respuesta, token por token |
| Total | 194 | Tarjetas Atlas A2, en nodos de 16 tarjetas cada uno |
La lista de nodos del Paso 6 dice lo mismo en una segunda forma. El script de inicio espera 8 nodos Decode primero, luego 4 nodos Prefill. A 16 tarjetas por nodo, eso da los mismos 128 y 64. El Encoder corre aparte, en sus 2 tarjetas.
Resultado esperado: tu clúster coincide con la serie Atlas A2 y el conteo de tarjetas, o paras aquí. Un conjunto Atlas A2 más pequeño no tiene ninguna ruta documentada en esta guía. La guía no da ninguna opción de escala reducida, ninguna opción de un solo nodo, y ninguna opción de pesos parciales. Los equipos sin el hardware conservan la ruta alojada en longcat.ai, que la ficha del modelo enlaza como su sitio de chat.
Paso 2: Instala el controlador y la pila CANN
Acción: instala el software de plataforma en el orden que da la guía. Empieza con el controlador Ascend HDK, versión 25.0.RC1.1, o el controlador que el documento de compatibilidad de CANN empareja con CANN 9.0.0. Luego instala tres paquetes CANN en versiones emparejadas: el paquete de herramientas, el paquete de operadores 910b, y el paquete NNAL que lleva la biblioteca de aceleración ATB. La guía nombra las formas de archivo directamente: Ascend-cann-toolkit_${version}_linux-${arch}.run, Ascend-cann-910b-ops_${version}_linux-${arch}.run, y Ascend-cann-nnal_${version}_linux-${arch}.run. Apunta al documento de instalación de CANN para el método en sí, así que sigue ese documento en vez de adivinar opciones.
Luego instala Ascend Extension for PyTorch. La guía exige las versiones torch_npu y torchair emparejadas con PyTorch 2.9.0 y CANN 9.0.0. La deriva de versiones en esta capa es el fallo clásico de Ascend. Una versión de torch_npu hecha para otra versión de CANN va a importar, y luego fallar más tarde de formas que apuntan a tu código de modelo en vez de al emparejamiento equivocado.
Resultado esperado: cada nodo lleva el mismo controlador, la misma versión de CANN, y la misma pareja PyTorch. Revisa un nodo, luego revisa que los demás coincidan con exactitud. La guía enuncia la regla con claridad para sus construcciones de núcleos, y vale para toda la pila: misma versión de fuente, emparejada con el chip, la arquitectura de CPU, y la configuración de Python y PyTorch de cada nodo.
Paso 3: Clona la rama NPU e instala sus dependencias de Python
Acción: descarga el código de servicio y cambia a la rama NPU antes de instalar nada desde él. La guía da este orden.
git clone https://github.com/meituan-longcat/SGLang-FluentLLM.git
cd SGLang-FluentLLM
git checkout longcat-2.5-npu
pip3 install -r ./npu_test/requirements.txt --no-deps
La opción --no-deps está en la guía, y importa. Instala los paquetes listados sin dejar que pip tire un segundo conjunto de bibliotecas de plataforma sin emparejar sobre la pila que construiste en el Paso 2.
Resultado esperado: el árbol de trabajo está en la rama longcat-2.5-npu, y la instalación de requisitos termina sin reemplazar torch ni torch_npu. Si pip reporta que cambió alguno de los dos, reconstruye ese nodo desde el Paso 2. El nombre de la rama también es tu recibo. El soporte EPD multimodal para este modelo existe en esta rama, según sus notas, y no en el motor de la línea principal.
Paso 4: Construye e instala los núcleos personalizados
Acción: construye el paquete flash-npu-kernel desde la raíz del proyecto. Es el paso más largo, y la guía lo divide en tres construcciones que tienen que llegar todas: un paquete de operadores CANN, luego dos ruedas de Python. Carga primero la configuración de construcción.
source "${ASCEND_TOOLKIT_ENV:-/usr/local/Ascend/ascend-toolkit/set_env.sh}"
source "${ATB_ENV:-/usr/local/Ascend/nnal/atb/set_env.sh}"
: "${ASCEND_HOME_PATH:?Load the CANN setup first and set ASCEND_HOME_PATH}"
python3 -m pip install setuptools wheel ninja
Si tu script de configuración de CANN vive en /usr/local/Ascend/cann/set_env.sh, ajusta primero ASCEND_TOOLKIT_ENV a esa ruta, como nota la guía. Luego construye e instala el paquete de operadores CANN para el chip Atlas A2, llamado ascend910b en el comando de construcción.
cd flash-npu-kernel/cann-flash-ops
bash build.sh -c ascend910b
bash "output/CANN-flash-ops-linux.$(uname -m).run" --quiet --install-path="${ASCEND_HOME_PATH}"
source "${ASCEND_HOME_PATH}/vendors/flash_ops/bin/set_env.bash"
Luego construye los dos paquetes de Python. La guía advierte que flash_ops y flash_npu_kernel son dos paquetes distintos y que cada uno necesita su propia instalación. También advierte que el primer script de construcción solo construye su rueda, con la línea de instalación comentada, así que la línea pip explícita siguiente es lo que en verdad lo instala.
cd flash-npu-kernel/cann-flash-ops/torch_ops_extension
bash build_and_install.sh
python3 -m pip install --force-reinstall --no-deps dist/flash_ops-*.whl
cd flash-npu-kernel/flash_ops
bash build.sh
python3 -m pip install --force-reinstall --no-deps dist/flash_npu_kernel-*.whl
Corre esas construcciones desde las carpetas correctas, volviendo a la raíz del proyecto entre ellas según lo que pida tu propia disciplina de terminal. Luego corre la revisión que da la guía.
python3 -c "import torch, torch_npu, flash_ops, flash_npu_kernel; print('NPU available:', torch.npu.is_available())"
Resultado esperado: la línea de importación corre y reporta que un NPU está disponible. Repite todo el paso en cada nodo de inferencia, con la misma versión de fuente en cada uno. Cada nodo que sirva el modelo después también necesita la configuración de CANN, la configuración de ATB, y el archivo de configuración de flash_ops cargados en su configuración de inicio. La guía lo señala para los inicios SSH por lote en particular, donde la terminal remota arranca sin ninguno de ellos cargado.
 El Encoder, el Prefill y el Decode corren como servicios distintos en este despliegue, enlazados por la red del clúster. Ilustración: Dirty Static
Paso 5: Descarga los pesos W4A4
Acción: descarga los pesos W4A4 a una ruta local que cada nodo de servicio pueda alcanzar, con el método que da la guía. Usa la herramienta de línea de comandos de Hugging Face y el repositorio W4A4, no el repositorio BF16.
pip install -U huggingface_hub
mkdir -p /data/meituan-longcat
hf download meituan-longcat/LongCat-2.5-W4A4 --local-dir /data/meituan-longcat/LongCat-2.5-W4A4
El Encoder también necesita sus propios pesos que le corresponden. El Paso 7 apunta el servicio Encoder a una ruta de pesos Encoder, así que busca los pesos Encoder que nombra el ejemplo de la guía y ponlos en la ruta que usarás ahí.
Resultado esperado: la carpeta W4A4 está completa en la ruta que nombrarás como MODEL_PATH en el Paso 6. La guía exige que esa ruta sea absoluta, sin espacios y sin caracteres comodín. Revisa el tamaño de la carpeta contra el listado del repositorio antes de seguir. Una descarga parcial que pasa una mirada rápida fallará horas después, en la carga del modelo, en 194 tarjetas a la vez.
Paso 6: Ajusta las variables del clúster
Acción: en el nodo de distribución, ajusta los cuatro valores que lee el script de inicio. La guía fija los nombres y las reglas de orden, y la regla de orden es la parte en que la gente se equivoca.
export MODEL_PATH=/data/meituan-longcat/LongCat-2.5-W4A4
export ENCODER_URLS=http://encoder-node0:9101
export iplist="decode-node0 decode-node1 decode-node2 decode-node3
decode-node4 decode-node5 decode-node6 decode-node7
prefill-node0 prefill-node1 prefill-node2 prefill-node3"
export testpath=/data/longcat25
export time=longcat25
El orden de iplist es fijo: los primeros 8 anfitriones son nodos Decode, los últimos 4 son nodos Prefill. Los nombres tienen que resolverse y alcanzarse por todo el clúster. ENCODER_URLS toma direcciones HTTP separadas por comas y sin espacios. La guía agrega tres reglas prácticas aquí. Ajusta SSH_USER y SSH_PORT si los valores por defecto de tu usuario actual y el puerto 22 no sirven. Mantén testpath aparte de la carpeta de fuente, y usa una carpeta destino nueva para cada versión nueva, para que los archivos de una construcción más vieja no se queden dentro de una nueva. Asegúrate de que los ajustes de red de HCCL, Gloo y Mooncake coincidan con tu red de clúster, y de que la ruta HTTP del Encoder, la ruta de vuelta de los resultados codificados, y la ruta de transferencia KV del Prefill al Decode puedan alcanzarse entre sí.
Resultado esperado: las acciones start, startp y startd tienen MODEL_PATH y ENCODER_URLS ajustados, lo que la guía exige, y las acciones status y log tienen la lista de nodos que necesitan.
Paso 7: Inicia el Encoder
Acción: en el nodo Encoder, desde la raíz del proyecto, apunta MODEL_PATH a los pesos Encoder e inicia el servicio Encoder.
export MODEL_PATH=/data/meituan-longcat/LongCat-2.5-Encoder
export ENCODER_NPU_DEVICES=0,1
bash npu_test/flash26b/run_encoder_epd.sh
La guía da los valores por defecto que vale conocer antes de cambiar cualquiera. El Encoder usa un tamaño de paralelismo de tensor de 2, sirve HTTP en el puerto 9101, y produce un formato que nombra rvq_indices. El puerto puede moverse por ENCODER_HTTP_PORT si 9101 choca en tu red.
Resultado esperado: el Encoder responde en su ruta de salud, que la sección Verificación revisa. No inicies nada más hasta que lo haga. El Prefill y el Decode toman la dirección del Encoder como un ajuste, y un Encoder ausente se convierte en fallos de instrucción que parecen fallos de modelo.
Paso 8: Distribuye el código e inicia el Prefill, el Decode y MiniLB
Acción: vuelve al nodo de distribución, ajusta las variables del Paso 6 de nuevo, con MODEL_PATH apuntando a los pesos W4A4, y previsualiza el inicio antes de correrlo. La guía integra un modo de ensayo en el script, y en un clúster de este tamaño la previsualización no es una cautela opcional. Es la revisión más barata que los comandos tendrán jamás.
DRY_RUN=1 bash npu_test/flash26b/run_pro_w4a4kv8_mm_epd.sh start
bash npu_test/flash26b/run_pro_w4a4kv8_mm_epd.sh code
bash npu_test/flash26b/run_pro_w4a4kv8_mm_epd.sh start
La acción code copia el código a cada nodo Prefill y Decode, dentro de la carpeta testpath, usando rsync. La acción start luego lanza el Prefill, el Decode y MiniLB. MiniLB inicia en el último nodo Prefill de tu lista, en el puerto 8081 por defecto. El script también toma startp para iniciar solo los 4 nodos Prefill más MiniLB, startd para iniciar solo los 8 nodos Decode, y un segundo valor opcional como etiqueta de registro, que las acciones de registro luego tienen que emparejar.
La guía nombra los ajustes de inicio para que puedas ubicarlos en los registros. El Prefill y el Decode inician con pesos W4A4, caché KV en INT8, decodificación especulativa MTP de estilo NEXTN, y las opciones --enable-multimodal --language-only. Esa última opción confunde a la gente en la primera lectura. Significa que los nodos Prefill y Decode corren solo la parte de lenguaje, porque el Encoder separado del Paso 7 hace el trabajo visual. El servicio completo sigue respondiendo pedidos de imagen. El Prefill corre con paralelismo de pipeline de 8 y paralelismo de tensor de atención de 8. El Decode corre con paralelismo KV de 8, paralelismo de datos de 16, y paralelismo de expertos de 128.
Resultado esperado: el inicio termina en los 12 nodos de servicio. Si el código ya está en la misma ruta en cada nodo por una corrida anterior, la guía dice que puedes correr start directamente y saltar la acción code.
Verificación
Revisa el resultado en el orden que da la guía, de fuera hacia dentro.
Primero, pide el estado al script, y lee los registros de nodo que apunta. Los registros están en cada nodo en la carpeta testpath, en un archivo nombrado por tu etiqueta time.
bash npu_test/flash26b/run_pro_w4a4kv8_mm_epd.sh status
Segundo, busca la línea de éxito que nombra la guía. En los nodos de rango 0 del Decode y del Prefill, un buen inicio termina con esta línea en el registro.
INFO - The server is fired up and ready to roll!
Tercero, revisa las tres rutas de salud. El Encoder tiene su propio puerto, y el Prefill y el Decode comparten otro.
curl --fail http://encoder-node0:9101/health
curl --fail http://prefill-node0:6080/health
curl --fail http://decode-node0:6080/health
Por último, envía un pedido de imagen real a MiniLB, a la dirección del último nodo Prefill, en el puerto 8081. Reemplaza la dirección de la imagen por una que tu clúster pueda alcanzar. El nombre de modelo servido por defecto es LongCat-2.5.
export service_ip=prefill-node3
curl -X POST http://${service_ip}:8081/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "LongCat-2.5",
    "messages": [
      {"role": "user", "content": [
        {"type": "text", "text": "Describe this image."},
        {"type": "image_url", "image_url": {"url": "https://example.com/image.jpg"}}
      ]}
    ],
    "max_tokens": 1024,
    "temperature": 0.7,
    "stream": false
  }'
Una respuesta JSON que describe la imagen, desde tu propio punto de conexión, es el resultado que toda la construcción busca. Para el trabajo solo de texto después de eso, la ficha del modelo muestra los controles de reflexión que vale conocer. LongCat-2.5 es un modelo híbrido. Toma enable_thinking ajustado a True o False por los ajustes de la plantilla de chat en el pedido, y save_history_reasoning_content ajustado a True guarda el texto de razonamiento en el historial, lo que la ficha recomienda para mejores resultados con la reflexión activada. Los ajustes de evaluación de la propia ficha usan reflexión activada, una temperatura de 1,0 y un top_p de 0,95.
Solución de problemas
| Problema | Causa probable | Corrección |
|---|---|---|
| La revisión de importación de núcleos falla en flash_ops o flash_npu_kernel | Las dos ruedas son paquetes distintos, y el primer script de construcción construye su rueda sin instalarla | Corre las líneas pip explícitas del Paso 4 para las dos ruedas, en el nodo que falla |
| La construcción para en un error de ASCEND_HOME_PATH | Los scripts de configuración de CANN no se cargaron en esa terminal | Carga primero los archivos de configuración de herramientas y de ATB, exactamente como abre el Paso 4, y vuelve a correr |
| El Prefill inicia donde debería estar el Decode, o al revés | El orden de iplist está mal | Pon los 8 nodos Decode primero y los 4 nodos Prefill al final, como enuncia el Paso 6, y reinicia |
| La revisión de salud del Encoder falla | El servicio Encoder nunca inició, o su puerto se movió | Inicia el Encoder desde el Paso 7 primero, y revisa ENCODER_HTTP_PORT si lo cambiaste de 9101 |
| La acción code falla en algunos nodos | SSH o rsync no está listo entre el nodo de distribución y esos nodos | Configura SSH sin contraseña, confirma las huellas de anfitrión, e instala rsync en cada nodo, como exige la guía |
| Un nodo carga código de una construcción más vieja | testpath todavía guarda archivos de una versión anterior | Usa un testpath nuevo para la versión nueva, aparte de la carpeta de fuente, como aconseja la guía |
| Los pedidos llegan a MiniLB pero las instrucciones de imagen fallan | La ruta de vuelta del Encoder al Prefill y al Decode está bloqueada, o ENCODER_URLS nombra la dirección equivocada | Revisa ENCODER_URLS contra la dirección y el puerto reales del Encoder, y confirma que la ruta de resultados codificados puede cruzar la red del clúster |
| Una herramienta como vLLM o llama.cpp no carga los pesos | La ficha del modelo no documenta ninguna ruta por medio de ellas | Usa la rama NPU de SGLang-FluentLLM en este tutorial. Ninguna otra ruta de servicio está documentada en la ficha |
Próximos pasos
Pon una pasarela que controles frente a MiniLB antes de que alguien fuera del equipo de operación toque el punto de conexión. El punto de conexión de la guía toma pedidos de chat en bruto, y no tiene ninguna capa de cuentas propia. Los límites de ritmo, los registros de pedidos y las reglas de acceso pertenecen a esa pasarela, ajustados por ti.
Luego anota la construcción exacta que corriste: la versión de CANN, la versión del controlador, el commit de la rama, y la versión de fuente de los núcleos, por grupo de nodos. En un clúster de este tamaño, la próxima actualización es una reconstrucción, y el equipo que la haga necesitará saber qué conjunto emparejado produjo un servicio que funciona. Cuando llegue una rama más nueva, trátala como un despliegue nuevo. Un testpath nuevo, un ensayo nuevo, las mismas revisiones de salud en el mismo orden.
Hechos verificados el 15 de noviembre de 2026, contra la ficha del modelo LongCat-2.5 en Hugging Face y la guía de despliegue NPU en el repositorio SGLang-FluentLLM, rama longcat-2.5-npu. Este tutorial sigue esos documentos y no afirma una ejecución de principio a fin en nuestro propio hardware.
Fuentes
- Tamaño del modelo, parámetros activos, cuantización W4A4, ajustes del modo de reflexión, ajustes de evaluación, y el puntero de despliegue NPU: Ficha del modelo LongCat-2.5, Meituan en Hugging Face
- Escala de despliegue, requisitos de hardware y software, construcciones de CANN y de núcleos, descarga de pesos, variables del clúster, scripts de inicio del Encoder y del Prefill y el Decode, revisiones de salud, y el ejemplo de pedido de imagen: Guía de despliegue NPU LongCat 2.5 W4A4, SGLang-FluentLLM
- El motor de servicio, su base SGLang, y la nota de rama para la inferencia multimodal W4A4 en Ascend A2: Repositorio SGLang-FluentLLM, Meituan
- Pesos W4A4: LongCat-2.5-W4A4, Meituan en Hugging Face
- Gráfico de bancos en el cuerpo: Meituan, desde la ficha del modelo de arriba. Ilustraciones del héroe y de EPD: Dirty Static.
FIN DE LA TRANSMISIÓN
Mantén la curiosidad. Cuestiónalo todo.