Meituan a publié les poids de LongCat-2.5, et l’histoire du matériel est le point central. Le modèle a été entraîné entièrement sur des accélérateurs chinois, sans GPU Nvidia dans le cycle d’entraînement décrit par l’entreprise. Les poids sont arrivés le 10 novembre, environ une semaine après la première présentation du modèle le 2 novembre.
Ce calendrier compte. L’annonce est d’abord venue comme un produit d’API. La publication ouverte est la nouvelle de cette semaine, car les développeurs peuvent maintenant télécharger le modèle, l’exécuter sur le matériel documenté par Meituan, et mettre les affirmations à l’épreuve eux mêmes.
L’annonce
The Decoder a rapporté la publication des poids le 15 novembre, une semaine après la présentation officielle. Meituan est une entreprise de livraison de nourriture devenue un labo de modèles sérieux, et son équipe LongCat a conçu cette version pour des agents qui planifient, écrivent du code, l’exécutent, vérifient le résultat, et continuent sur de nombreuses étapes.
LongCat-2.5 est un modèle de mélange d’experts. Cela signifie que seule une partie du modèle complet travaille sur chaque jeton. Le compte total est de 1,6 billion de paramètres, mais environ 48 milliards sont actifs à la fois, et ce plus petit nombre est ce qui détermine le coût d’exécution. Par l’API, il traite jusqu’à un million de jetons à la fois et peut générer des réponses jusqu’à 128 000 jetons, selon Meituan. Il accepte le texte, les images et la vidéo, retourne du texte, et permet d’activer ou de désactiver le raisonnement.
La nouveauté par rapport à LongCat-2.0 est la compréhension des images. Au lieu d’ajouter un système d’image séparé après coup, le modèle transforme les images à leur taille d’origine en jetons et les lit dans le même flux que le texte. Meituan dit que cette approche devrait aider le codage visuel, le travail de conception et les tâches en 3D. C’est une affirmation de l’entreprise sur son intention, et non un résultat mesuré, et des tests externes devront montrer dans quelle mesure cela fonctionne en pratique.
Pour l’entraînement, l’équipe a utilisé de vraies tâches logicielles tirées de demandes de tirage GitHub, ainsi que des échecs d’agents recréés comme tâches d’entraînement. Dans les salles d’entraînement, l’accès à internet était bloqué, l’historique Git et les fichiers en cache étaient retirés, et un modèle de langage séparé vérifiait les solutions pour déceler les astuces. Le but était d’empêcher le modèle de trouver un raccourci et de le forcer à résoudre la tâche devant lui.
Détails importants
| Élément | Où en sont les choses |
|---|---|
| Annonce | 2 novembre 2026 |
| Publication des poids | 10 novembre 2026, sous la licence MIT |
| Paramètres au total | 1,6 billion |
| Actifs par jeton | Environ 48 milliards |
| Contexte par l’API | Jusqu’à 1 million de jetons |
| Sortie maximale | Jusqu’à 128 000 jetons |
| Entrées | Texte, images et vidéo |
| Déploiement exemple | 194 accélérateurs Huawei Ascend Atlas A2 |
| Références indépendantes | Aucune publiée dans la couverture vérifiée le 15 novembre |
Le guide de déploiement est l’endroit où l’affirmation sur le matériel devient concrète. Meituan quantifie les poids et les activations des experts à 4 bits, un format que les puces chinoises peuvent traiter de façon native. Dans ses propres tests de charge, l’entreprise dit que le débit du traitement des invites a augmenté de 43,3 pour cent et que la génération de réponses a augmenté de 42,77 pour cent par rapport à une version à 8 bits, avec une précision comparable au modèle non compressé. Ces chiffres sont des chiffres de Meituan, rapportés par The Decoder, et ils n’ont pas été reproduits par un labo externe dans la couverture vérifiée ici.
La configuration exemple pour cette version quantifiée utilise 194 accélérateurs Huawei Ascend de la série Atlas A2. Deux traitent le traitement des images, 64 traitent l’admission des invites, et 128 traitent la génération des réponses. Il n’y a aucun guide pour les GPU Nvidia dans ce guide. Les publications de Meituan elles mêmes ne nomment aucun fournisseur de puces pour le cycle d’entraînement lui même. Elles décrivent des accélérateurs domestiques ou fabriqués en Chine, et le nom du fournisseur apparaît dans le guide de déploiement, et non dans l’affirmation sur l’entraînement.
Cette distinction mérite d’être gardée. Pour le LongCat-2.0 précédent, Meituan a dit que l’entraînement avait eu lieu fin juin sur un groupe de plus de 50 000 puces chinoises. Aucun nombre de cartes pour le cycle d’entraînement de LongCat-2.5 n’a été donné dans les publications examinées pour ce reportage, et cet article n’attribue pas l’ancien nombre au nouveau modèle.
Sur le prix, Meituan offre une promotion de lancement. The Decoder a situé le prix à environ 0,27 euro par million de jetons en entrée et 1,07 euro par million de jetons en sortie. Les utilisateurs peuvent aussi essayer le modèle dans un service de clavardage à longcat.ai, et son API prend en charge les formats OpenAI et Anthropic, de sorte qu’il peut se brancher à des outils agents comme Claude Code, Codex et Hermes. Cette facilité d’échange fait partie de l’argument, et elle se rapproche du travail de notre reportage sur les Claude Managed Agents auto hébergés, où le contrôle de l’endroit où un agent s’exécute est toute la question.
Ce que disent les références, et ce qu’elles ne disent pas
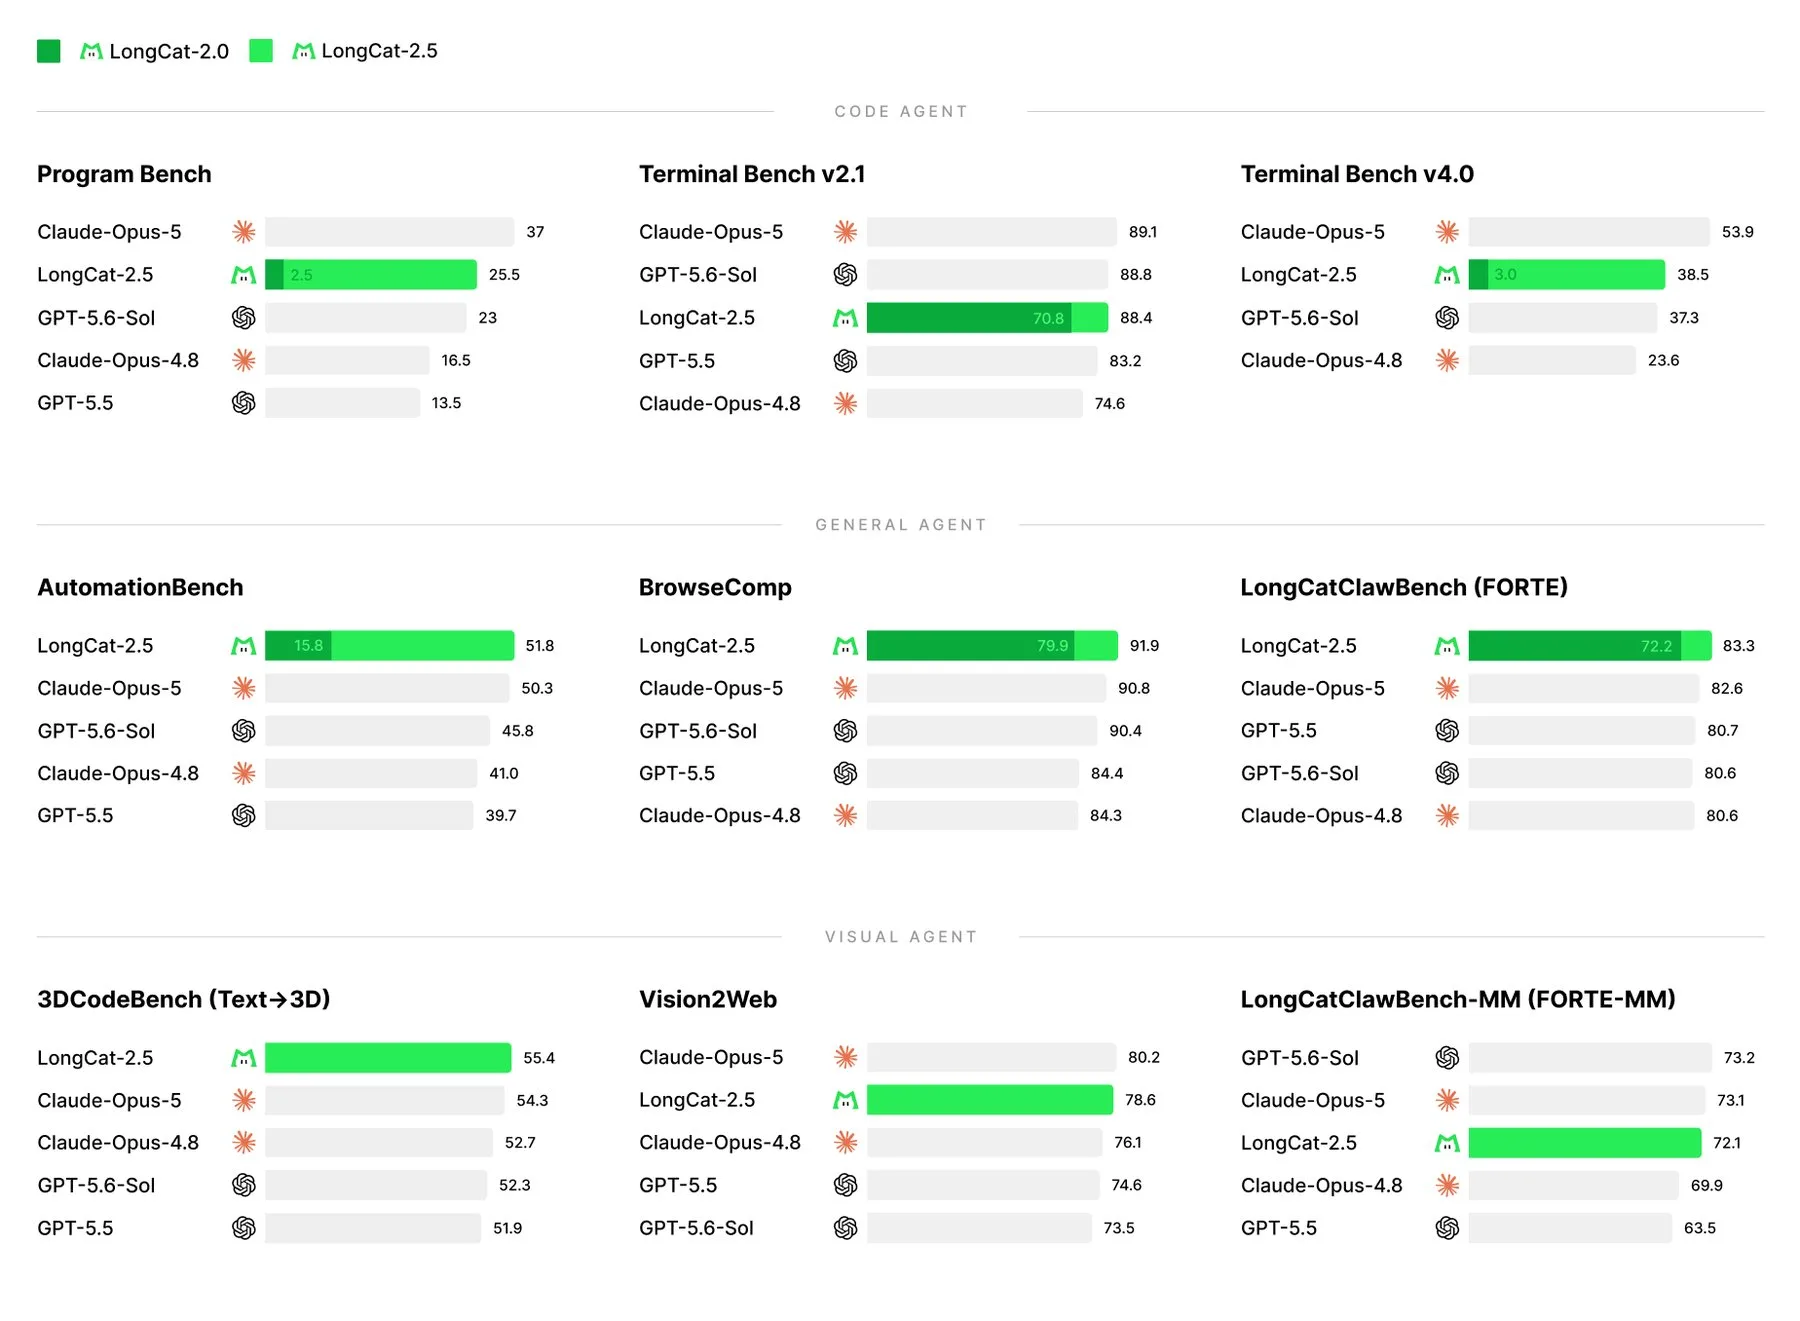
Meituan rapporte 88,4 points sur Terminal Bench v2.1, un test de la façon dont les agents résolvent des tâches dans une ligne de commande. Dans le même tableau, l’entreprise inscrit Claude Opus 5 à 89,1, GPT-5.6 Sol à 88,8, et DeepSeek V4.1 Flash en tête avec 90,6. Sur DeepSWE, un test de correction de bogues dans du vrai code, LongCat-2.5 passe de 9,7 pour le modèle précédent à 64,6, toujours derrière la plupart des rivaux de ce tableau.
D’autres chiffres suivent le même schéma. Terminal Bench v4.0, la variante plus difficile, place LongCat-2.5 à 38,5, légèrement au dessus de GPT-5.6 Sol à 37,3 mais bien en dessous d’Opus 5 à 53,9. Sur BrowseComp, un test de recherche sur le web, Meituan rapporte 91,9, le score le plus élevé de son tableau, même si l’entreprise a mené ce test dans son propre cadre.
Rien de tout cela ne règle la comparaison. Tech Times a rapporté le 3 novembre que chaque affirmation de performance pour LongCat-2.5 à ce moment venait des tests internes de Meituan, sans aucun évaluateur indépendant publiant un résultat. La couverture de The Decoder sur la publication des poids ne cite aucun essai indépendant non plus. Jusqu’à ce que des groupes externes publient leur propre travail, la lecture juste est étroite : le modèle semble proche des meilleurs modèles occidentaux sur plusieurs tests d’agents dans le propre tableau de Meituan, et cette proximité reste non vérifiée.
- Nov. 2, 2026Meituan présente LongCat-2.5 comme un modèle agent multimodal
- Nov. 3, 2026Tech Times note que toutes les affirmations de référence viennent jusqu'ici de Meituan
- Nov. 10, 2026Poids publiés sous la licence MIT pour un usage commercial
- Nov. 15, 2026The Decoder rapporte la publication des poids et le déploiement exemple sur 194 puces
La suite
Les étapes confirmées sont simples. Les poids sont publiés, l’API est en ligne, et les développeurs peuvent maintenant exécuter le modèle dans les configurations documentées par Meituan et publier des résultats qui ne viennent pas de Meituan. Ce travail externe est le prochain vrai jalon, et non un autre graphique de lancement.
Les questions ouvertes sont plus grandes. Un modèle de 1,6 billion de paramètres au total n’est pas un modèle pour ordinateur portable, même avec seulement 48 milliards actifs par jeton et une version à 4 bits disponible. L’exemple documenté a besoin de 194 accélérateurs, ce qui place l’auto hébergement en territoire de centre de données. La plupart des équipes qui essaieront LongCat-2.5 d’abord le rencontreront par une API ou par un hôte qui exécute déjà du matériel Ascend, un schéma qui façonne aussi la poussée pour du matériel souverain dans notre reportage sur Nvidia, Rebellions et SK Telecom en Corée.
Il y a aussi une question de marché que le lancement laisse ouverte. Un modèle réglé pour les puces chinoises dès le départ rend ces puces plus attrayantes hors de Chine si la performance se maintient, car le logiciel et le matériel arrivent maintenant en paire. Si la performance ne se maintient pas sous les tests externes, la publication compte quand même comme une preuve que la voie d’entraînement fonctionne, mais elle ne changera pas beaucoup de décisions d’achat.
La conclusion est claire. Meituan a livré un très grand modèle agent, l’a entraîné sans matériel Nvidia dans le cycle qu’elle décrit, et a publié les poids sous une licence qui permet à d’autres de les utiliser pour les affaires. L’exploit du matériel est documenté dans le guide de déploiement. L’exploit de performance reste une affirmation, et maintenant que les poids sont publics, c’est une affirmation que toute personne ayant le bon groupe de machines peut vérifier.
Sources
- The Decoder, Meituan releases a 1.6 trillion parameter agent model that never touched an Nvidia GPU, 15 novembre 2026. Calendrier de publication des poids, méthode des jetons d’image, tâches d’entraînement, résultats à 4 bits, déploiement sur 194 puces, tableau de références et prix de lancement.
- Tech Times, Meituan Releases LongCat 2.5 on Chinese Chips; Benchmark Claims Await Independent Tests, 3 novembre 2026. Calendrier de l’annonce, nombre de paramètres actifs, et l’avertissement que toutes les affirmations de référence étaient auto rapportées sans test indépendant à cette date.
- Techies Journal, reportage sur LongCat-2.5 vérifié le 15 novembre 2026. Annonce du 2 novembre et publication ouverte du 10 novembre sous MIT, et la note que les publications de Meituan ne nomment que des accélérateurs domestiques pour l’entraînement tandis que le guide de déploiement nomme Ascend Atlas A2.
- Faits vérifiés le 15 novembre 2026. L’image de référence vient de Meituan via The Decoder et est créditée ci dessus. Les autres images de cet article sont des illustrations Dirty Static dans le style maison.
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.