Dirty Static // El veredicto
Un modelo agente serio en papel y una API barata para probar, pero cada puntaje es un puntaje del proveedor y la ruta documentada para alojarlo por cuenta propia necesita un grupo de 194 chips Ascend.
Ideal paraEquipos que quieren probar un modelo agente de bajo costo primero por una API, y talleres Ascend que de verdad pueden hacer funcionar el grupo documentado
Lo que funciona
- Los puntajes agente del proveedor quedan cerca de Claude Opus 5 y GPT-5.6 Sol en Terminal Bench v2.1, con 88,4 frente a 89,1 y 88,8
- Los pesos están publicados bajo la licencia MIT, así que el uso comercial y las pruebas externas están permitidos
- La API habla los formatos OpenAI y Anthropic y se conecta con Claude Code, Codex y Hermes
- El precio de lanzamiento es bajo, cerca de 0,30 dólares por millón de tokens de entrada y 1,20 dólares por millón de tokens de salida
- Las imágenes entran como tokens nativos junto al texto, lo que sirve para codificación visual y trabajo de diseño
Lo que no funciona
- Ninguna prueba independiente publicada en la cobertura revisada el 15 de noviembre, así que cada puntaje aquí es un puntaje de Meituan
- La guía de ejemplo para alojarlo por cuenta propia usa 194 chips Huawei Ascend Atlas A2, lo que pone esa ruta en territorio de centro de datos
- La guía no da ninguna ruta para GPU de Nvidia, así que la mayoría de los talleres occidentales no tiene una ruta documentada para hacer funcionar los pesos
- Los límites de salida difieren entre los documentos de Meituan, con 128 000 tokens en la cobertura de lanzamiento y 256 000 tokens en los documentos de parámetros
- En las pruebas más duras la brecha crece, con 38,5 en Terminal Bench v4.0 frente a 53,9 de Claude Opus 5 en la misma tabla del proveedor
Reseña basada en investigación: se apoya en pruebas publicadas, especificaciones y documentación, no en pruebas prácticas.
LongCat-2.5 llegó con una afirmación sobre hardware primero y una afirmación sobre el modelo después. Meituan dice que el modelo se entrenó solo con aceleradores chinos, y los pesos llegaron el 10 de noviembre bajo la licencia MIT. La pregunta para un comprador es más simple que la política que lo rodea. ¿Este modelo hace el trabajo de agente lo bastante bien para ganar un lugar en una pila, y cuánto cuesta hacerlo funcionar donde usted de verdad trabaja?
Esta reseña responde solo desde material publicado. Dirty Static no hizo funcionar el modelo. Cada puntaje abajo viene de la tabla de Meituan, reportada por The Decoder el 15 de noviembre, y ninguna prueba independiente se había publicado en la cobertura revisada ese día. Trate los puntajes como afirmaciones con números, no como resultados cerrados.
Qué es
LongCat-2.5 es un modelo de mezcla de expertos construido por el equipo LongCat en Meituan, la empresa china de entrega de comida que ahora dirige un laboratorio de modelos serio. Un modelo de mezcla de expertos divide su trabajo entre muchas subredes pequeñas y despierta solo algunas para cada token. Por eso el tamaño total y el costo de funcionamiento pueden contar historias distintas. El total es de 1,6 billones de parámetros. El conteo activo por token es de cerca de 48 mil millones.
El modelo se creó para agentes que trabajan en tareas largas en muchos pasos, con la codificación como caso principal. Toma texto, imágenes y video como entrada y devuelve texto. Los usuarios pueden encender o apagar su modo de razonamiento. Se apoya en LongCat-2.0 y suma la comprensión de imágenes como la nueva habilidad principal.
Para el entrenamiento, Meituan usó tareas reales de software tomadas de solicitudes de cambios en GitHub, más fallos de agentes reconstruidos como tareas de entrenamiento. En esos entornos el equipo bloqueó el acceso a internet, quitó el historial de Git y los archivos en caché, y usó otro modelo de lenguaje para revisar las soluciones en busca de trucos. Ese detalle importa para una reseña. Sugiere que el equipo trató de impedir que el modelo hiciera trampa en su propia tarea, aun si los puntajes finales aún necesitan revisiones externas.
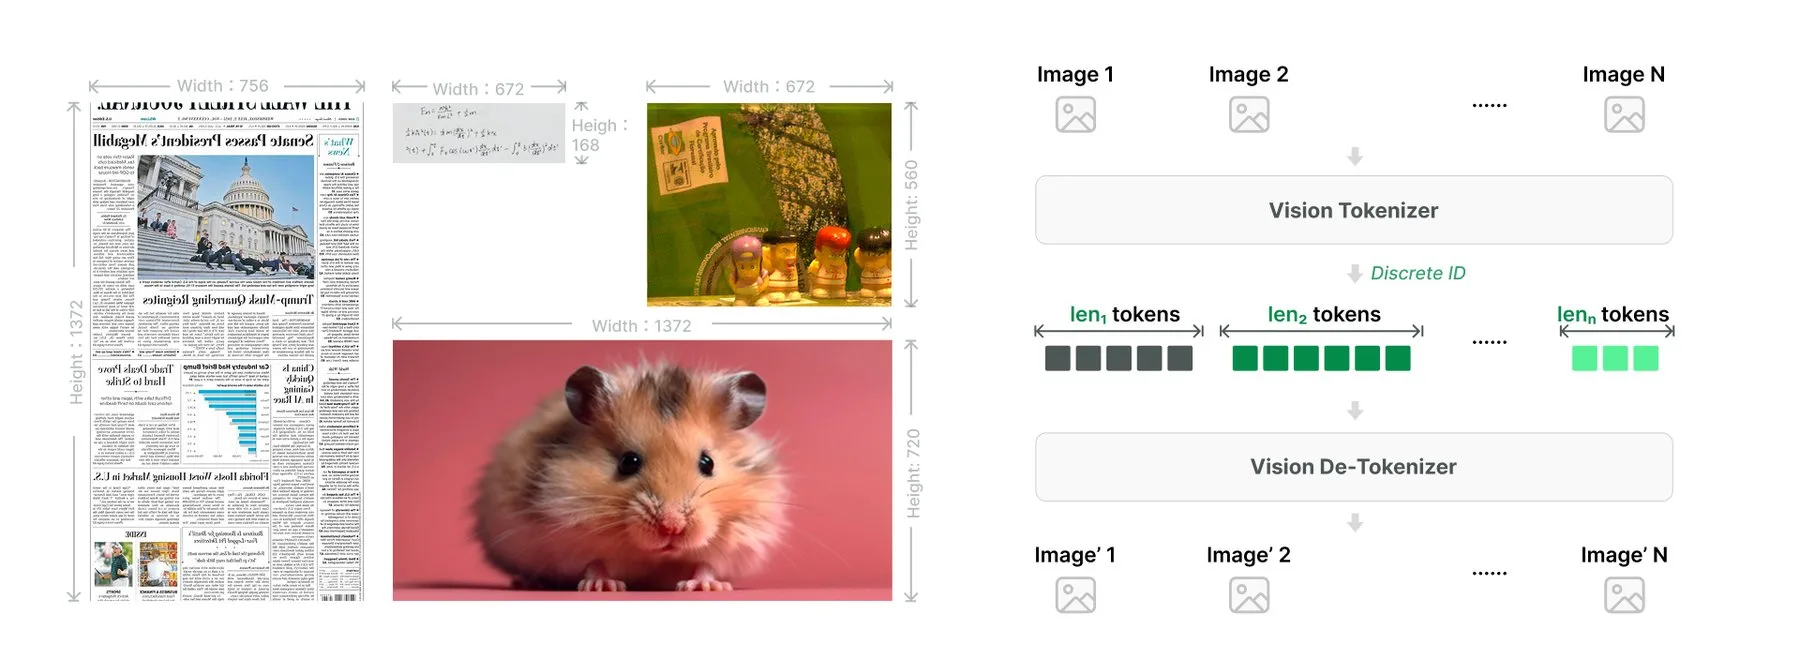
Funciones y especificaciones
| Área | LongCat-2.5 |
|---|---|
| Fabricante | Equipo LongCat en Meituan |
| Anunciado | 2 de noviembre de 2026 |
| Pesos publicados | 10 de noviembre de 2026, bajo la licencia MIT |
| Parámetros en total | 1,6 billones |
| Activos por token | Cerca de 48 mil millones |
| Notas de arquitectura | 768 expertos enrutados con enrutamiento de los 12 primeros, según la configuración del modelo |
| Contexto por la API | Hasta 1 millón de tokens |
| Salida máxima | 128 000 tokens en la cobertura de lanzamiento; 256 000 tokens en los documentos de parámetros |
| Entradas | Texto, imágenes y video |
| Salida | Texto |
| Razonamiento | Se puede encender o apagar |
| Versión cuantizada | Pesos y activaciones de expertos a 4 bits para trabajo nativo en aceleradores nacionales |
| Despliegue de ejemplo | 194 chips Huawei Ascend Atlas A2 |
| Formatos de API | OpenAI y Anthropic |
| Arneses de agente nombrados | Claude Code, Codex y Hermes |
La ruta de las imágenes merece una mirada más cercana. Muchos modelos pegan un codificador de imágenes separado a un modelo de texto después del hecho. LongCat-2.5 en cambio divide una imagen en su tamaño nativo en tokens discretos y lee esos tokens en la misma corriente que el texto. Meituan dice que eso debería ayudar con la codificación visual, el trabajo de diseño y las tareas en 3D. Esa es una afirmación sobre la intención del diseño. Los puntajes visuales en la tabla del proveedor le dan cierto apoyo, y las pruebas visuales externas le darán más o se lo quitarán.
La diferencia en el límite de salida es una cosa pequeña que cuenta una historia más grande. La cobertura de lanzamiento puso el tope en 128 000 tokens. Los documentos de parámetros revisados por otros analistas lo pusieron en 262 144 tokens, lo que redondea a 256 000. Ambos números vienen de material de Meituan. Un equipo que planea corridas largas de agente debería confirmar el tope en su propia cuenta antes de diseñar alrededor de una u otra cifra. Nuestro reporte de noticias sobre la publicación de los pesos de LongCat-2.5 cubre el anuncio de hardware por completo.
Experiencia en el mundo real
Esta sección es una discusión basada en investigación, no un registro de pruebas. Se apoya en la tarjeta del modelo, la guía de despliegue tal como la reportó The Decoder, los documentos de precios, y el pequeño conjunto de reseñas externas que revisaron esos documentos en noviembre.
Empiece por la ruta que la mayoría de los equipos de verdad tomará, que es la API. El precio es el atractivo. Los documentos de precios dan cerca de 0,30 dólares por millón de tokens de entrada, 0,006 dólares por entrada en caché, y 1,20 dólares por millón de tokens de salida, bajo una etiqueta de tiempo limitado sin fecha de fin dada. The Decoder puso el mismo precio de lanzamiento en cerca de 0,27 euros de entrada y 1,07 euros de salida. A esas tasas, un equipo puede hacer una prueba real de agente por el costo de un almuerzo de equipo y aprender más de lo que cualquier tabla de puntajes puede enseñar.
El acceso también ayuda. La API habla el formato OpenAI y el formato Anthropic. Eso quiere decir que las herramientas creadas para una pila a menudo pueden apuntar a LongCat-2.5 con un cambio de dirección base y una clave nueva. Meituan nombra a Claude Code, Codex y Hermes como arneses que funcionan con el modelo. Para un modelo agente, ese ajuste importa tanto como los puntajes brutos, porque los agentes viven dentro de arneses, no dentro de cajas de chat.
Terminal Bench v2.1 scores, vendor table
Scores from Meituan evaluation table as reported by The Decoder, November 15, 2026. All figures are vendor reported. No independent run had been published in the coverage checked.
Los puntajes del proveedor se dividen en dos historias. En Terminal Bench v2.1, que prueba el trabajo de agente en línea de comandos, LongCat-2.5 queda en 88,4 en un grupo apretado cerca de la cima. En BrowseComp, una prueba de búsqueda web, Meituan reporta 91,9, el puntaje más alto de su tabla, aun si la empresa hizo esa prueba en su propio entorno. En DeepSWE, que prueba la corrección de errores en código real, el modelo salta de 9,7 para LongCat-2.0 a 64,6, una ganancia grande que aun así lo deja detrás de la mayoría de los rivales de la tabla.
La prueba más dura cuenta la historia más fría. En Terminal Bench v4.0, LongCat-2.5 obtiene 38,5. Eso supera a GPT-5.6 Sol con 37,3 en la misma tabla y queda muy por debajo de Claude Opus 5 con 53,9. Una lectura justa es que el modelo maneja el trabajo de agente de rutina a un nivel cercano a los líderes, y que los líderes se alejan cuando las tareas se hacen largas y confusas. Ese es también el patrón que los compradores de agentes ven en la mayoría de los modelos nuevos, así que el resultado es plausible. Plausible no es lo mismo que probado.
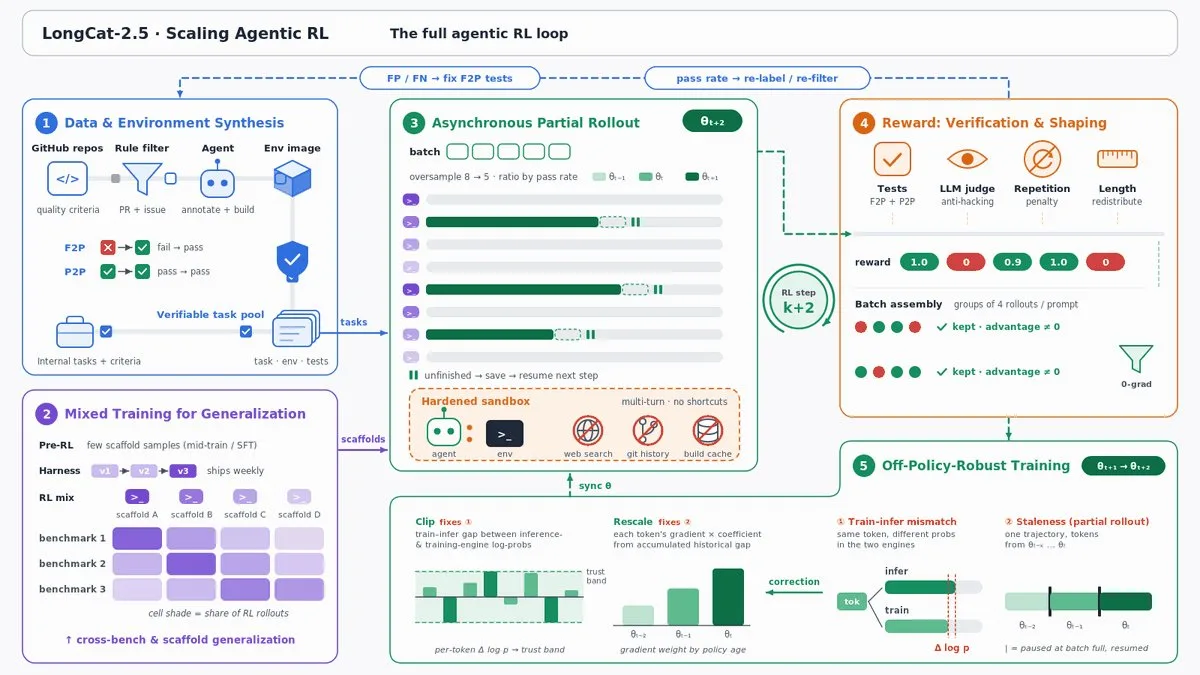
Alojarlo por cuenta propia es donde la reseña se pone dura. La guía documentada cuantiza los pesos y las activaciones de los expertos a 4 bits, un formato que los chips chinos manejan de forma nativa. Meituan dice que esa versión subió el rendimiento de las entradas en 43,3 por ciento y el rendimiento de las respuestas en 42,77 por ciento frente a una versión de 8 bits en sus propias pruebas de carga, con una precisión igual. Esas son pruebas de carga del proveedor. El grupo en la guía es la parte concreta. Usa 194 chips Huawei Ascend Atlas A2, con 2 para el trabajo de imágenes, 64 para la entrada de solicitudes y 128 para la generación de respuestas. No hay ninguna guía de Nvidia en la guía.
Esa forma decide para quién es esta publicación. Un taller que ya hace funcionar hardware Ascend recibe un modelo agente grande ajustado para sus bastidores desde el primer día. Un taller con hardware de Nvidia recibe una API y una página de chat, más unos pesos que no tiene ninguna ruta documentada para servir. Ambos grupos pueden usar el modelo. Solo un grupo puede ser dueño de su funcionamiento.
Lo que funciona
El enfoque en agentes es real en el diseño, no solo en el mercadeo. Las tareas de entrenamiento vinieron de solicitudes reales de cambios. Los casos de fallo se reconstruyeron como lecciones. El entorno aislado bloqueó las trampas fáciles. Los modelos entrenados así tienden a comportarse mejor en arneses que los modelos entrenados solo con datos de chat, y el salto en DeepSWE de 9,7 a 64,6, aun como cifra del proveedor, apunta en esa dirección.
La licencia y el precio funcionan juntos. Los términos MIT dejan que una empresa use los pesos en un producto sin una negociación de licencia. El precio de la API deja que un equipo pruebe el modelo esta semana sin una pelea de compras. Sume la API de doble formato y el apoyo nombrado de arneses, y la ruta de prueba es casi tan corta como esta clase permite. En comparación, la pregunta de control en nuestro reporte sobre los agentes gestionados de Claude alojados por cuenta propia es la misma que LongCat plantea desde el otro lado del mundo. ¿Quién hace funcionar el agente, y en los chips de quién?
Lo que no funciona
El problema de la evidencia viene primero. Tech Times notó el 3 de noviembre que cada afirmación de rendimiento en ese momento venía de las propias pruebas de Meituan. La cobertura de la publicación de los pesos dos semanas después aún no citaba ninguna prueba independiente. Hasta que un laboratorio sin interés en el resultado publique sus propios números, un comprador califica la tarea de Meituan con una clave de respuestas de Meituan.
El tamaño es el segundo problema. Solo 48 mil millones de parámetros se despiertan por token, pero el total completo de 1,6 billones aún tiene que vivir en algún lugar y cargarse desde algún lugar. La tarjeta del modelo da 208 archivos de pesos y cerca de 3,56 billones de bytes de almacenamiento. Nadie hace funcionar esto en una estación de trabajo. La versión de 4 bits corta el costo de servicio, y aun así necesita un grupo que la mayoría de las empresas alquilará en vez de poseer, si es que puede alquilar capacidad Ascend.
La deriva de la documentación es el tercer problema, y el más fácil de corregir. Los topes de salida difieren entre los propios documentos de Meituan. Las cifras de contexto difieren entre la configuración del modelo y el discurso de la API. Nada de esto es fatal, y todo esto cuesta tiempo a un usuario nuevo que un conjunto de documentos más ajustado ahorraría.
Competencia
| Modelo | Acceso | Puntaje agente en la tabla del proveedor | Ruta para alojarlo por cuenta propia |
|---|---|---|---|
| LongCat-2.5 | Pesos MIT más API alojada | Terminal Bench v2.1 con 88,4, reportado por el proveedor | Documentada solo en 194 chips Ascend Atlas A2 |
| Claude Opus 5 | Solo API alojada | Terminal Bench v2.1 con 89,1 y v4.0 con 53,9, tal como los da Meituan | Ninguna |
| GPT-5.6 Sol | Solo API alojada | Terminal Bench v2.1 con 88,8 y v4.0 con 37,3, tal como los da Meituan | Ninguna |
| DeepSeek V4.1 Flash | Línea de pesos abiertos de DeepSeek | Terminal Bench v2.1 con 90,6, tal como lo da Meituan | Servicio comunitario amplio en pilas de GPU comunes |
La tabla usa cifras de Meituan para los rivales también, así que léala como un mapa de afirmaciones, no como una tabla de posiciones. La forma aun así ayuda a una decisión. Claude y GPT siguen siendo las opciones alojadas seguras, con el puntaje más fuerte en la prueba dura de esta tabla en manos de Opus 5. DeepSeek ofrece la ruta abierta que la mayoría de los talleres de GPU de verdad puede servir hoy. LongCat-2.5 ofrece la ruta abierta creada para Ascend, a un precio de API que supera a la sala mientras dura la promoción.
Veredicto final
Pruebe LongCat-2.5 por su API si hace trabajo de agente y su arnés habla el formato OpenAI o Anthropic. La prueba es barata, la instalación es corta, y sus propias tareas le dirán más en un día de lo que la tabla del proveedor puede. Esa es la forma honesta de probar un modelo cuyos puntajes vienen todos de su fabricante.
Elíjalo para alojarlo por cuenta propia solo si su mundo ya funciona con Ascend. Para ese taller, esto es una cosa rara, un modelo agente a escala de frontera ajustado para su hardware desde el inicio, con una versión cuantizada y una guía completa de grupo. Para cada otro taller, espere. Espere puntajes independientes, espere apoyo de servicio comunitario en GPU comunes, o espere un hermano menor que quepa en bastidores reales. El modelo bien puede ganar sus puntajes. El 15 de noviembre, la evidencia de que lo había hecho aún era la palabra de Meituan, y un comprador cuidadoso pone precio a una afirmación como una afirmación.
Esta reseña está basada en investigación. Se apoya en la tarjeta del modelo y los documentos de precios de Meituan, el reporte de The Decoder del 15 de noviembre de 2026, y revisiones externas de documentos de noviembre de 2026. No se hizo ninguna prueba práctica. Hechos revisados el 15 de noviembre de 2026.
Fuentes
- The Decoder, Meituan releases a 1.6 trillion parameter agent model that never touched an Nvidia GPU, 15 de noviembre de 2026. Tabla de puntajes, método de tokens de imagen, tareas de entrenamiento, pruebas de carga de 4 bits, despliegue de 194 chips y precios de lanzamiento en euros.
- Equipo LongCat de Meituan, tarjeta del modelo para LongCat-2.5 en Hugging Face, revisada el 15 de noviembre de 2026. Licencia MIT, configuración de arquitectura, archivos de pesos, tamaño de almacenamiento y notas de la versión cuantizada.
- Documentos de precios y parámetros de la plataforma LongCat, revisados en la cobertura de noviembre de 2026. Precio por tiempo limitado de cerca de 0,30 dólares por millón de tokens de entrada y 1,20 dólares por millón de tokens de salida, y la cifra de salida de 256 000 tokens en los documentos de parámetros.
- Tech Times, reporte del 3 de noviembre de 2026, que nota que todas las afirmaciones de puntajes en esa fecha venían de las propias pruebas de Meituan sin un evaluador independiente.
- Imágenes de producto: Meituan vía The Decoder, acreditadas en cada figura. Imagen principal y demás ilustraciones: Dirty Static.
FIN DE LA TRANSMISIÓN
Mantén la curiosidad. Cuestiónalo todo.