Dirty Static // Le verdict
Le plus fort résultat en maths dans le domaine en ce moment, et une nette avance sur Argon, achetée avec beaucoup plus de jetons et de temps par problème. Il vaut le coût pour les maths difficiles, la science et la sécurité, quand une bonne réponse compte. Difficile à justifier comme modèle par défaut.
Idéal pourLes équipes avec des maths difficiles, de la science, de longs contextes ou de la sécurité, quand la justesse bat le coût par essai, et les équipes qui budgètent déjà Argon à ses tarifs de décembre
Ce qui fonctionne
- Première place sur MathArena à 85,4 pour cent, devant Claude Fable 5.2 et GPT-6.1 Sol
- Premier sur l'indice d'intelligence Artificial Analysis v5.0 à 59, neuf points devant Argon
- Gains larges sur Argon dans les tableaux publiés par Google, avec GraphWalks à 96,2 pour cent et ExploitGym à 54,8 pour cent
- Même prix par jeton que Argon, avec une fenêtre d'un million de jetons et une entrée en texte, image, audio, vidéo et PDF
Ce qui ne fonctionne pas
- Coût MathArena de 15,70 $ par problème, environ quinze fois Sol à 1,07 $, avec une part du score estimée plutôt que mesurée
- Le prix par jeton double le 1er décembre à 4 $ en entrée et 20 $ en sortie par million de jetons, sans niveau gratuit
- L'avance sur MathArena tient dans les marges d'erreur, et les tableaux de Google montrent encore des défaites sur certains essais d'usage d'ordinateur et de logiciel
- L'échec le plus fréquent sur MathArena était de dépasser la limite de temps, dans un cas pendant plus de onze heures
Test fondé sur la recherche : basé sur des essais publiés, des spécifications et de la documentation, et non sur des essais pratiques.
Gemini 4 Carbon occupe maintenant le sommet de MathArena, le banc d’essai de l’ETH Zurich qui évalue les modèles sur des problèmes de maths frais qu’ils n’ont pas vus pendant l’entraînement. Carbon a obtenu 85,4 pour cent. Le modèle qu’il a déplacé, GPT-6.1 Sol d’OpenAI, a obtenu 80,6 pour cent. Cet écart semble net jusqu’à la colonne suivante. Un essai Carbon coûte 15,70 $ par problème. Un essai Sol coûte 1,07 $.
Cet échange résume tout l’examen en miniature. Carbon est, selon les preuves publiées, le plus fort modèle que Google a livré et le meneur actuel sur au moins deux classements sérieux. Il dépense aussi beaucoup plus pour y arriver, en jetons, en temps, et dès le 1er décembre en prix affiché aussi. Savoir s’il vaut l’achat dépend de la valeur d’une bonne réponse pour vous quand un modèle moins cher se trompe.
Ce que c’est
Google a annoncé Gemini 4 Carbon le 28 octobre 2026 dans un texte de Koray Kavukcuoglu. La société l’a appelé son plus fort modèle et l’a d’abord destiné à la cybersécurité et au travail logiciel complexe. L’accès au lancement est allé seulement à un sous ensemble de défenseurs en cybersécurité dans le programme Fairwind, une voie limitée que Google avait aussi utilisée pour Argon.
Cette porte s’est ouverte le 10 novembre. Carbon est devenu offert à tous sous le nom gemini-4-carbon par l’API Gemini et Google AI Studio au niveau payant, par Vertex AI et Gemini pour les entreprises, et par l’application Gemini, la Recherche et Antigravity pour les abonnés Google AI Ultra. Il n’y a pas de niveau gratuit. Les lecteurs qui ont rencontré Carbon comme la moitié planification du duo dans notre profil de Gemini 4 Hydrogen ont déjà vu ce partage. Hydrogen exécute. Carbon est fait pour la réflexion la plus difficile.
Fonctions et spécifications
| Domaine | Spécification de Gemini 4 Carbon |
|---|---|
| Fabricant | Google DeepMind |
| Annoncé | 28 octobre 2026 |
| Offert à tous | 10 novembre 2026 |
| Identifiant du modèle | gemini-4-carbon |
| Fenêtre de contexte | 1 048 576 jetons |
| Entrée | Texte, image, audio, vidéo, PDF |
| Sortie | Texte, avec les jetons de réflexion facturés au tarif de sortie |
| Premier accès | Programme Fairwind, pour un sous ensemble de défenseurs en cybersécurité |
| Voies publiques | API Gemini, Google AI Studio, Vertex AI, Gemini pour les entreprises, application Gemini et Antigravity sur Ultra |
Prix, vérifiés le 16 novembre 2026
- Entrée standard, jusqu'au 30 novembre
- 2,00 $ par million de jetons
- Entrée standard, dès le 1er décembre
- 4,00 $ par million de jetons
- Sortie standard, jusqu'au 30 novembre
- 10,00 $ par million de jetons, réflexion incluse
- Sortie standard, dès le 1er décembre
- 20,00 $ par million de jetons, réflexion incluse
- Entrée en cache
- 0,10 $ par million de jetons, puis 0,20 $ dès le 1er décembre
- Niveau gratuit
- Non offert
Le pas de décembre compte plus que le prix de lancement. Chaque tarif double le 1er décembre, pour l’entrée, la sortie et l’entrée en cache. Aux tarifs de décembre, Carbon coûte exactement ce que Claude Opus 5.5 coûte par jeton, et deux fois ce que GPT-6.1 Sol coûte par jeton. Quiconque cite les tarifs de 2 $ et 10 $ sans la date cite une promotion comme si c’était un prix. Notre rapport Antigravity sur les bases Gemini de 512K dans Antigravity montre Carbon déjà présent dans les outils de code de Google, où la plupart de l’usage payant commencera.
Expérience en usage réel
Ceci est un examen de recherche. Dirty Static n’a pas roulé Carbon, et aucun essai pratique n’est revendiqué ici. Ce qui suit vient de MathArena, de Artificial Analysis, des tableaux publiés par Google, et de reportages de VentureBeat, The Decoder et Tbreak, tous vérifiés le 16 novembre 2026.
Commencez par le résultat le plus récent, parce que c’est celui du titre. MathArena a ajouté Carbon et Claude Fable 5.2 le 13 novembre. Le banc utilise des problèmes de concours et de recherche fraîchement publiés, et chaque modèle tente chaque problème quatre fois. Carbon, à son niveau de raisonnement élevé, a pris la première place à 85,4 pour cent, avec une marge de plus ou moins 3,0 points. Fable 5.2, à son niveau max, a obtenu 82,8 pour cent, plus ou moins 5,3 points. Sol, à max, a obtenu 80,6 pour cent, plus ou moins 2,7 points. The Decoder a noté que Carbon est le premier modèle hors OpenAI depuis un moment à dominer ce classement.
Performance attendue sur MathArena, 13 novembre 2026
Performance attendue de MathArena, rapportée par The Decoder et Tbreak. Carbon à élevé, les rivaux à max. Plus haut est meilleur.
Lisez maintenant la colonne des coûts avec le même soin. MathArena place le coût attendu d’un essai à 15,70 $ pour Carbon, 40,20 $ pour Fable 5.2, 3,70 $ pour Kimi K3.1 Pro et 1,07 $ pour Sol. Fable coûte plus que Carbon. Sol coûte environ un quinzième, pour 4,8 points de moins. Les prix par jeton seuls n’expliquent pas cet écart, puisque Carbon et Sol partagent un tarif de sortie de 10 $ aux réglages notés. Carbon fait simplement beaucoup plus de travail par problème. Les reportages sur le banc notent des comptes moyens de jetons dans les centaines de milliers par tentative sur certains tours, et plus d’un million de jetons sur un tour ArXivLean.
Deux réserves vont à côté du trophée. D’abord, les intervalles se chevauchent. Carbon à 85,4 plus ou moins 3,0 et Fable à 82,8 plus ou moins 5,3 pourraient changer de place sur un autre échantillon, et l’avance sur Sol n’est pas réglée hors de tout doute non plus. Ensuite, une part du score de Carbon est estimée plutôt que mesurée. À cause du coût, MathArena a roulé Carbon seulement sur ArXivLean et a estimé le reste à partir de sa performance observée. Cela ne rend pas le résultat faux. Cela le rend plus doux qu’un essai complet sur chaque ensemble.
Le mode d’échec vaut aussi d’être connu avant de donner une échéance à Carbon. The Decoder rapporte que son échec le plus fréquent sur MathArena était de dépasser la limite de temps, et qu’il abandonne presque jamais. Dans un essai, il a gardé un script en marche pendant plus de onze heures sans vérifier la progression. La persistance est une vertu sur une preuve. C’est un fardeau sur une facture et sur un horaire.
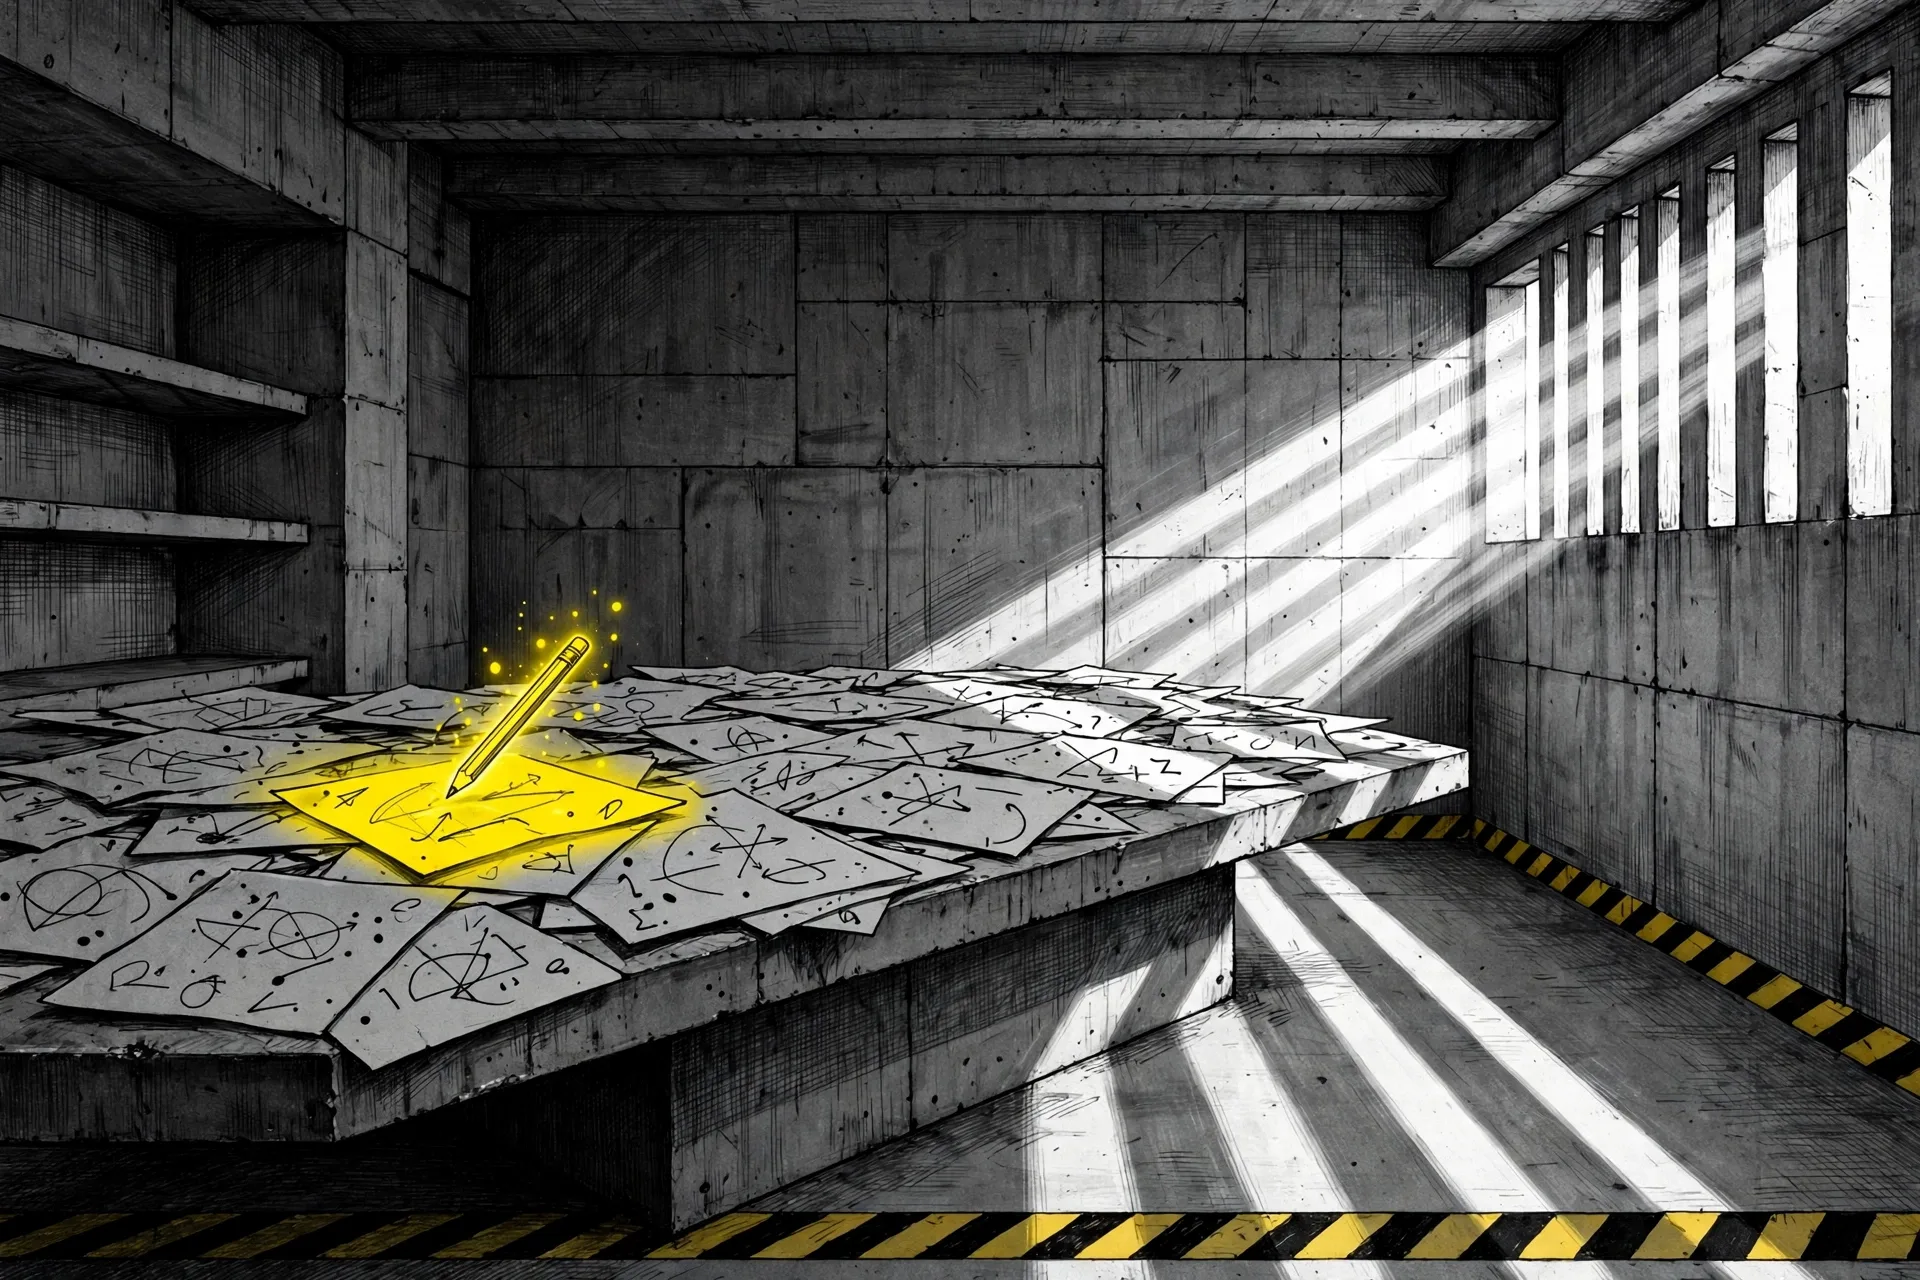
Les classements plus larges soutiennent la direction, avec moins de drame. Sur l’indice d’intelligence Artificial Analysis v5.0, un composite indépendant, Carbon obtient 59, devant Claude Opus 5.5 à 58, GPT-6 Astra à 57 et Argon à 50. Sur LiveBench 2.0, il obtient 83,5. Artificial Analysis place son coût à 7,76 $ par tâche au prix courant, avec environ 123 000 jetons de sortie par tâche. C’est le plus fort argument général pour Carbon. Contre son propre frère, au même prix par jeton, il est nettement meilleur pour environ le même argent.
Le tableau de Google pointe dans le même sens, et c’est un tableau de la société, alors nommez le comme tel. Google rapporte Carbon devant Argon sur chaque ligne publiée, dont Terminal-Bench 4.0 à 65,2 pour cent contre 57,1 pour cent, GraphWalks sur de longs contextes à 96,2 pour cent contre 84,2 pour cent, ExploitGym à 54,8 pour cent contre 42,0 pour cent et SEC-bench Pro à 88,2 pour cent contre 83,4 pour cent. Il rapporte aussi 80,0 pour cent sur RiemannBench pour la science et les maths. Le même reportage montre les limites. Carbon suit Claude Opus 5.5 sur le sous ensemble hors ligne de OSWorld, 81,5 pour cent contre 87,2 pour cent, et suit GPT-6 Astra sur FrontierSWE 2. VentureBeat a aussi noté un taux plus élevé d’affirmations sans appui que Argon sur un essai de connaissances factuelles dans un travail indépendant. Un raisonnement plus fort n’a pas retiré le besoin de vérifier les sorties.
Ce qui fonctionne
Les maths et la science sont la force la plus claire, et elles ont maintenant un classement indépendant derrière elles, pas seulement un graphique de lancement. Une première place sur des problèmes frais, où la mémorisation aide moins, est un résultat plus dur à écarter qu’une avance sur un ensemble public. Pour le travail de recherche, les preuves et les problèmes quantitatifs durs, Carbon a mérité un essai devant les modèles qu’il a déplacés.
Le long contexte est la deuxième force. GraphWalks à 96,2 pour cent sur des contextes de 256 000 à un million de jetons est un large écart sur Argon et sur les rivaux nommés dans le tableau de Google. Le travail qui vit dans une immense base de code, un long ensemble de contrats ou une archive complète est exactement le travail où perdre le fil coûte le plus, et c’est le travail pour lequel Carbon a été bâti.
La sécurité est la troisième, avec le même avertissement sur la source. Trouver une faille, montrer qu’elle peut servir, et écrire un correctif sont trois travaux différents. Google rapporte des gains sur les trois, sur CWE-bench, ExploitGym et SEC-bench Pro. Ces essais ont roulé dans les conditions que Google décrit pour son travail d’évaluation, et les acheteurs devraient attendre des chiffres plus bas sous les garde fous normaux. La direction colle quand même à l’histoire Fairwind, où les défenseurs ont utilisé le modèle sur du vrai travail de vulnérabilité avant le lancement public.
Ce qui ne fonctionne pas
Le coût par problème fini est la faiblesse principale, et MathArena rend impossible de le cacher derrière les prix par jeton. Deux modèles peuvent partager une grille de tarifs et produire des factures qui diffèrent par un facteur de quinze, parce que l’un réfléchit plus longtemps, écrit plus, et refuse de s’arrêter. Carbon est ce modèle sur ce classement. Les équipes qui achètent au jeton et ne mesurent jamais le coût par tâche finie apprendront cela d’une facture.
Le temps est la deuxième faiblesse, et elle suit la première. Un modèle dont l’échec fréquent est de dépasser une limite a besoin d’une limite fixée par l’acheteur, dans le code, avant le départ de l’essai. Notre tutoriel sur les niveaux de réflexion dans Gemini 4 Hydrogen couvre la même discipline chez le petit frère. Le principe est identique ici. Méritez le niveau élevé avec un essai raté à un niveau plus bas, et plafonnez l’essai.
La troisième faiblesse est la certitude. L’avance sur MathArena tient dans des marges qui se chevauchent, une part du score est estimée, et le large tableau de Google est un tableau du vendeur. Rien de cela n’annule le résultat. Tout cela plaide contre le basculement de tout un flux de travail sur une semaine de classement.
Concurrence
| Modèle | Score MathArena | Coût par problème MathArena | Portrait du prix par jeton | Contraste principal avec Carbon |
|---|---|---|---|---|
| Gemini 4 Carbon | 85,4 % | 15,70 $ | 2 $ / 10 $ jusqu’au 30 novembre, puis 4 $ / 20 $ par million de jetons | Meilleur score, avec une dépense élevée par problème et une hausse en décembre |
| Claude Fable 5.2 | 82,8 % | 40,20 $ | 8 $ / 40 $ par million de jetons dans les comparaisons de lancement | Proche sur le score, beaucoup plus coûteux par problème, avec la marge d’erreur la plus large du groupe |
| GPT-6.1 Sol | 80,6 % | 1,07 $ | 2 $ / 10 $ par million de jetons, sans changement dans les comparaisons de décembre | Le choix valeur, 4,8 points derrière pour environ un quinzième du coût d’essai |
| Gemini 4 Argon | Aucune ligne MathArena dans les sources vérifiées | Non listé | 2 $ / 10 $ jusqu’au 30 novembre, puis 4 $ / 20 $ par million de jetons | Même prix que Carbon, neuf points derrière sur l’indice Artificial Analysis |
| Claude Opus 5.5 | Aucune ligne MathArena dans les sources vérifiées | Non listé | 4 $ / 20 $ par million de jetons | Égale le prix de décembre de Carbon par jeton, le mène sur le sous ensemble hors ligne de OSWorld |
Le choix n’est pas Carbon ou rien. Pour la plupart du code, des documents et du travail d’agent en volume, un modèle rapide comme Hydrogen ou un modèle valeur comme Sol finira plus de tâches par dollar. Carbon gagne sa place au sommet d’une table de routage, pas comme toute la table. Envoyez lui les problèmes qui ont vaincu les modèles moins chers, le travail sur de longs contextes qui a besoin de toute la fenêtre, et le travail de sécurité où ses gains publiés sont les plus grands.
Verdict final
Utilisez Carbon là où avoir raison vaut le prix, et mesurez le sur vos propres problèmes les plus durs avant de vous engager. Fixez un plafond de temps et un plafond de jetons sur chaque essai, budgétez aux tarifs de décembre, et comparez le coût par bonne réponse contre Sol et Fable 5.2 sur le même ensemble. Selon les preuves publiées, Carbon gagnera certaines de ces comparaisons sur la qualité et perdra la plupart sur le coût, et les deux moitiés de cette phrase comptent.
Évitez le comme défaut. Un modèle par défaut roule sur le travail facile comme sur le travail dur, et Carbon facture un temps frontière et des jetons frontière pour les deux, sans niveau gratuit pour adoucir les essais. Le modèle qui domine un classement de maths à quinze fois le coût d’essai est un outil de spécialiste. Le traiter comme un spécialiste, avec une règle de routage et une ligne de budget propre, est la façon dont il se paie.
Sources
- Google : annonce de Gemini 4 Carbon, 28 octobre 2026, par Koray Kavukcuoglu, telle que rapportée par VentureBeat
- Tbreak : Gemini 4 Carbon tops MathArena maths benchmark
- eesel AI : Gemini 4 Carbon pricing, $2 and $10 promo, $4 and $20 after, cost per task
- AI Pro League : Gemini 4 Carbon, LiveBench 83.5 and pricing record
- Images : les images du héros et du bureau de maths sont des illustrations générées dans le style maison de Dirty Static. L’image du tableau de résultats est un tableau publié par Google, crédité plus haut.
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.