Dirty Static // El veredicto
El resultado de matemáticas más fuerte del campo ahora mismo, y una ventaja amplia sobre Argon, comprada con muchos más tokens y tiempo por problema. Vale la pena para matemáticas duras, ciencia y seguridad, cuando una respuesta correcta importa. Difícil de justificar como modelo por defecto.
Ideal paraEquipos con matemáticas duras, ciencia, contextos largos o trabajo de seguridad, cuando la precisión supera el costo por corrida, y equipos que ya presupuestan Argon a sus tarifas de diciembre
Lo que funciona
- Primer lugar en MathArena con 85,4 por ciento, por delante de Claude Fable 5.2 y GPT-6.1 Sol
- Primero en el índice de inteligencia Artificial Analysis v5.0 con 59, nueve puntos por delante de Argon
- Ganancias amplias sobre Argon en las tablas publicadas por Google, con GraphWalks en 96,2 por ciento y ExploitGym en 54,8 por ciento
- Mismo precio por token que Argon, con una ventana de un millón de tokens y entrada en texto, imagen, audio, video y PDF
Lo que no funciona
- Costo en MathArena de 15,70 $ por problema, unas quince veces Sol con 1,07 $, con parte del puntaje estimado en lugar de medido
- El precio por token se duplica el 1 de diciembre a 4 $ de entrada y 20 $ de salida por millón de tokens, sin nivel gratis
- La ventaja en MathArena queda dentro de los márgenes de error, y las tablas de Google aún muestran derrotas en algunas pruebas de uso de computadora y de software
- La falla más común en MathArena fue pasar el límite de tiempo, en un caso por más de once horas
Reseña basada en investigación: se apoya en pruebas publicadas, especificaciones y documentación, no en pruebas prácticas.
Gemini 4 Carbon ahora ocupa la cima de MathArena, la prueba de ETH Zurich que evalúa modelos con problemas de matemáticas nuevos que no vieron durante el entrenamiento. Carbon marcó 85,4 por ciento. El modelo que desplazó, GPT-6.1 Sol de OpenAI, marcó 80,6 por ciento. Esa brecha parece limpia hasta leer la columna siguiente. Una corrida de Carbon cuesta 15,70 $ por problema. Una corrida de Sol cuesta 1,07 $.
Ese intercambio resume toda la reseña en miniatura. Carbon es, según la evidencia publicada, el modelo más fuerte que Google ha lanzado y el líder actual en al menos dos tablas serias. También gasta mucho más para llegar ahí, en tokens, en tiempo, y desde el 1 de diciembre también en precio de lista. Si vale la pena comprarlo depende de cuánto vale una respuesta correcta para ti cuando un modelo más barato se equivoca.
Qué es
Google anunció Gemini 4 Carbon el 28 de octubre de 2026 en un texto de Koray Kavukcuoglu. La empresa lo llamó su modelo más fuerte y lo apuntó primero a la ciberseguridad y al trabajo de software complejo. El acceso en el lanzamiento fue solo para un subconjunto de defensores de ciberseguridad en el programa Fairwind, una vía cerrada que Google también usó para Argon.
Esa puerta se abrió el 10 de noviembre. Carbon quedó disponible para todos como gemini-4-carbon por la API de Gemini y Google AI Studio en el nivel pago, por Vertex AI y Gemini para empresas, y por la aplicación Gemini, la Búsqueda y Antigravity para suscriptores de Google AI Ultra. No hay nivel gratis. Los lectores que conocieron Carbon como la mitad de planificación del dúo en nuestro perfil de Gemini 4 Hydrogen ya vieron esta división. Hydrogen ejecuta. Carbon está hecho para el pensamiento más difícil.
Funciones y especificaciones
| Área | Especificación de Gemini 4 Carbon |
|---|---|
| Fabricante | Google DeepMind |
| Anunciado | 28 de octubre de 2026 |
| Disponible para todos | 10 de noviembre de 2026 |
| Identificador del modelo | gemini-4-carbon |
| Ventana de contexto | 1 048 576 tokens |
| Entrada | Texto, imagen, audio, video, PDF |
| Salida | Texto, con los tokens de pensamiento cobrados a la tarifa de salida |
| Primer acceso | Programa Fairwind, para un subconjunto de defensores de ciberseguridad |
| Vías públicas | API de Gemini, Google AI Studio, Vertex AI, Gemini para empresas, aplicación Gemini y Antigravity en Ultra |
Precios, verificados el 16 de noviembre de 2026
- Entrada estándar, hasta el 30 de noviembre
- 2,00 $ por millón de tokens
- Entrada estándar, desde el 1 de diciembre
- 4,00 $ por millón de tokens
- Salida estándar, hasta el 30 de noviembre
- 10,00 $ por millón de tokens, pensamiento incluido
- Salida estándar, desde el 1 de diciembre
- 20,00 $ por millón de tokens, pensamiento incluido
- Entrada en caché
- 0,10 $ por millón de tokens, luego 0,20 $ desde el 1 de diciembre
- Nivel gratis
- No disponible
El paso de diciembre importa más que el precio de lanzamiento. Cada tarifa se duplica el 1 de diciembre, entrada, salida y entrada en caché por igual. A las tarifas de diciembre, Carbon cuesta exactamente lo que Claude Opus 5.5 cuesta por token, y el doble de lo que GPT-6.1 Sol cuesta por token. Quien cite las tarifas de 2 $ y 10 $ sin la fecha cita una promoción como si fuera un precio. Nuestro informe de Antigravity sobre las bases Gemini de 512K en Antigravity muestra a Carbon ya dentro de las herramientas de código de Google, donde empezará la mayor parte del uso pago.
Experiencia en el mundo real
Esta es una reseña de investigación. Dirty Static no ejecutó Carbon, y aquí no se reclama ninguna prueba práctica. Lo que sigue viene de MathArena, de Artificial Analysis, de las tablas publicadas por Google, y de reportes de VentureBeat, The Decoder y Tbreak, todos verificados el 16 de noviembre de 2026.
Empieza por el resultado más nuevo, porque es el del título. MathArena agregó Carbon y Claude Fable 5.2 el 13 de noviembre. La prueba usa problemas de concursos y de investigación recién publicados, y cada modelo intenta cada problema cuatro veces. Carbon, en su nivel de razonamiento alto, tomó el primer lugar con 85,4 por ciento, con un margen de más o menos 3,0 puntos. Fable 5.2, en su nivel max, marcó 82,8 por ciento, más o menos 5,3 puntos. Sol, en max, marcó 80,6 por ciento, más o menos 2,7 puntos. The Decoder notó que Carbon es el primer modelo fuera de OpenAI en un tiempo que domina esta tabla.
Rendimiento esperado en MathArena, 13 de noviembre de 2026
Rendimiento esperado de MathArena, reportado por The Decoder y Tbreak. Carbon en alto, los rivales en max. Más alto es mejor.
Lee ahora la columna de costos con el mismo cuidado. MathArena pone el costo esperado de una corrida en 15,70 $ para Carbon, 40,20 $ para Fable 5.2, 3,70 $ para Kimi K3.1 Pro y 1,07 $ para Sol. Fable cuesta más que Carbon. Sol cuesta cerca de una quinceava parte, por 4,8 puntos menos. Los precios por token solos no explican esa brecha, ya que Carbon y Sol comparten una tarifa de salida de 10 $ en los ajustes registrados. Carbon simplemente hace mucho más trabajo por problema. Los reportes sobre la prueba notan cuentas promedio de tokens en los cientos de miles por intento en algunas rondas, y más de un millón de tokens en una ronda de ArXivLean.
Dos cautelas van junto al trofeo. Primero, los rangos se cruzan. Carbon con 85,4 más o menos 3,0 y Fable con 82,8 más o menos 5,3 podrían cambiar de lugar en otra muestra, y la ventaja sobre Sol tampoco está cerrada sin duda. Segundo, parte del puntaje de Carbon es estimado en lugar de medido. Por el costo, MathArena ejecutó Carbon solo en ArXivLean y estimó el resto desde su rendimiento observado. Eso no hace falso el resultado. Lo hace más blando que una corrida completa en cada conjunto.
El modo de falla también vale la pena conocerlo antes de darle a Carbon una fecha límite. The Decoder reporta que su falla más común en MathArena fue pasar el límite de tiempo, y que casi nunca se rinde. En una corrida mantuvo un script en marcha por más de once horas sin revisar el progreso. La persistencia es una virtud en una prueba. Es una carga en una factura y en un horario.
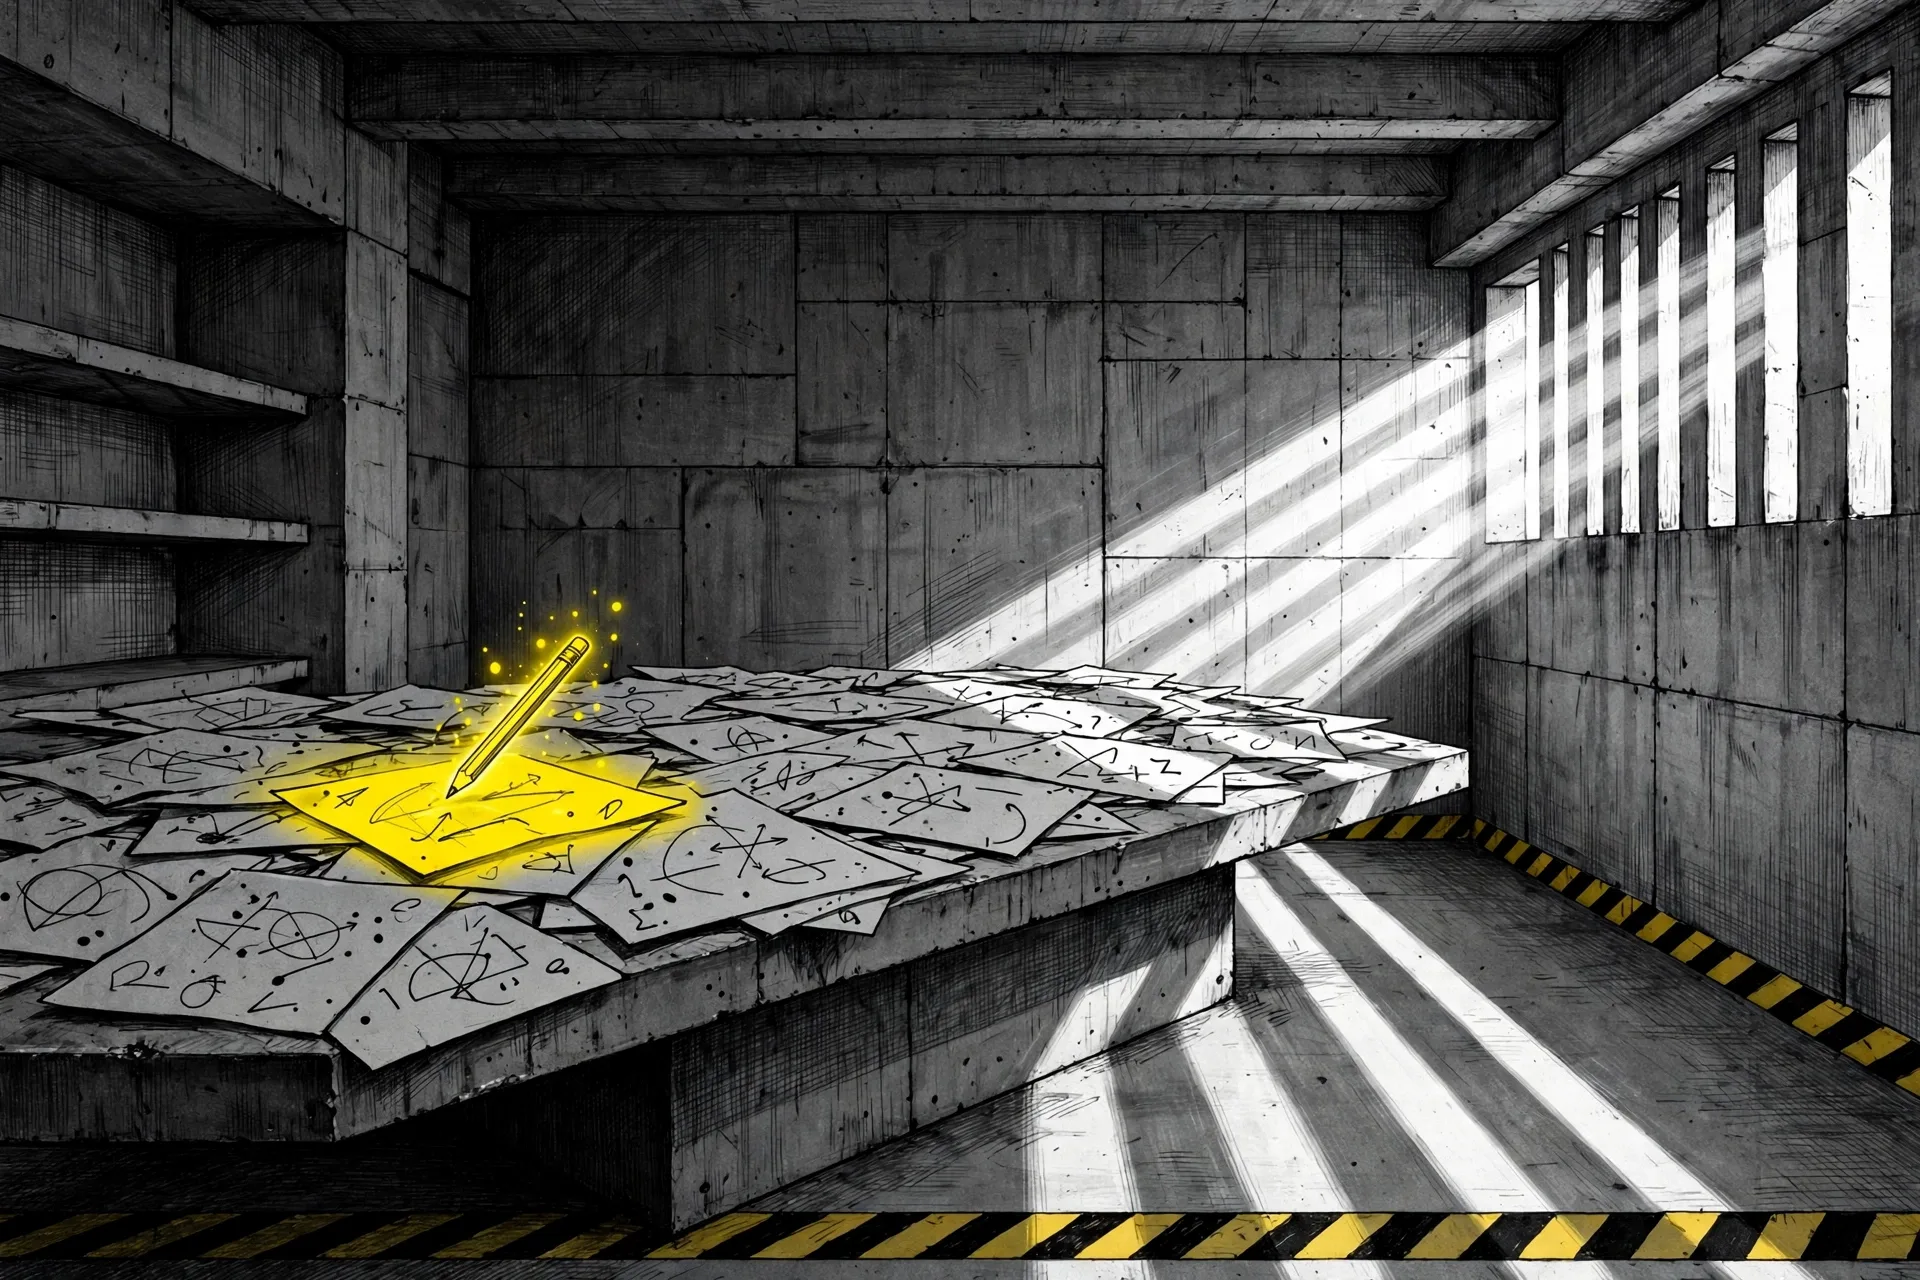
Las tablas más amplias apoyan la dirección, con menos drama. En el índice de inteligencia Artificial Analysis v5.0, un compuesto independiente, Carbon marca 59, por delante de Claude Opus 5.5 con 58, GPT-6 Astra con 57 y Argon con 50. En LiveBench 2.0 marca 83,5. Artificial Analysis pone su costo en 7,76 $ por tarea a precio de lista, con unos 123 000 tokens de salida por tarea. Ese es el argumento general más fuerte para Carbon. Contra su propio hermano, al mismo precio por token, es claramente mejor por casi el mismo dinero.
La tabla de Google apunta en el mismo sentido, y es una tabla de la empresa, así que nombrala como tal. Google reporta a Carbon por delante de Argon en cada fila publicada, entre ellas Terminal-Bench 4.0 con 65,2 por ciento contra 57,1 por ciento, GraphWalks en contextos largos con 96,2 por ciento contra 84,2 por ciento, ExploitGym con 54,8 por ciento contra 42,0 por ciento y SEC-bench Pro con 88,2 por ciento contra 83,4 por ciento. También reporta 80,0 por ciento en RiemannBench para ciencia y matemáticas. El mismo reporte muestra los límites. Carbon queda detrás de Claude Opus 5.5 en el subconjunto sin conexión de OSWorld, 81,5 por ciento contra 87,2 por ciento, y detrás de GPT-6 Astra en FrontierSWE 2. VentureBeat también notó una tasa más alta de afirmaciones sin apoyo que Argon en una prueba de conocimiento factual en trabajo independiente. Un razonamiento más fuerte no ha quitado la necesidad de revisar las salidas.
Qué funciona
Las matemáticas y la ciencia son la fuerza más clara, y ahora tienen una tabla independiente detrás, no solo un gráfico de lanzamiento. Un primer lugar en problemas nuevos, donde la memorización ayuda menos, es un resultado más difícil de descartar que una ventaja en un conjunto público. Para trabajo de investigación, pruebas y problemas cuantitativos duros, Carbon se ganó una prueba por delante de los modelos que desplazó.
El contexto largo es la segunda fuerza. GraphWalks con 96,2 por ciento en contextos de 256 000 a un millón de tokens es una brecha grande sobre Argon y sobre los rivales nombrados en la tabla de Google. El trabajo que vive en una base de código enorme, un conjunto largo de contratos o un archivo completo es justo el trabajo donde perder el hilo cuesta más, y es el trabajo para el que Carbon fue construido.
La seguridad es la tercera, con la misma advertencia sobre la fuente. Encontrar una falla, mostrar que puede usarse, y escribir un parche son tres trabajos distintos. Google reporta ganancias en los tres, en CWE-bench, ExploitGym y SEC-bench Pro. Esas pruebas corrieron en las condiciones que Google describe para su trabajo de evaluación, y los compradores deberían esperar cifras más bajas bajo los controles normales. La dirección aún coincide con la historia de Fairwind, donde los defensores usaron el modelo en trabajo real de vulnerabilidades antes del lanzamiento público.
Qué no funciona
El costo por problema terminado es la debilidad principal, y MathArena hace imposible esconderlo detrás de los precios por token. Dos modelos pueden compartir una tabla de tarifas y producir facturas que difieren por un factor de quince, porque uno piensa más tiempo, escribe más, y se niega a parar. Carbon es ese modelo en esta tabla. Los equipos que compran por token y nunca miden el costo por tarea terminada aprenderán esto de una factura.
El tiempo es la segunda debilidad, y sigue a la primera. Un modelo cuya falla frecuente es pasar un límite necesita un límite fijado por el comprador, en el código, antes de que empiece la corrida. Nuestro tutorial sobre niveles de pensamiento en Gemini 4 Hydrogen cubre la misma disciplina en el hermano menor. El principio es idéntico aquí. Gana el nivel alto con una corrida fallida en un nivel más bajo, y pon un tope a la corrida.
La tercera debilidad es la certeza. La ventaja en MathArena queda dentro de márgenes que se cruzan, parte del puntaje es estimado, y la tabla amplia de Google es una tabla del vendedor. Nada de eso cancela el resultado. Todo eso argumenta en contra de cambiar todo un flujo de trabajo por una semana de tabla.
Competencia
| Modelo | Puntaje MathArena | Costo por problema MathArena | Retrato del precio por token | Contraste principal con Carbon |
|---|---|---|---|---|
| Gemini 4 Carbon | 85,4 % | 15,70 $ | 2 $ / 10 $ hasta el 30 de noviembre, luego 4 $ / 20 $ por millón de tokens | Mejor puntaje, con gasto alto por problema y una subida en diciembre |
| Claude Fable 5.2 | 82,8 % | 40,20 $ | 8 $ / 40 $ por millón de tokens en comparaciones de lanzamiento | Cerca en puntaje, mucho más costoso por problema, con el margen de error más amplio del grupo |
| GPT-6.1 Sol | 80,6 % | 1,07 $ | 2 $ / 10 $ por millón de tokens, sin cambio en comparaciones de diciembre | La opción de valor, 4,8 puntos detrás por cerca de una quinceava parte del costo |
| Gemini 4 Argon | Sin fila MathArena en las fuentes revisadas | No listado | 2 $ / 10 $ hasta el 30 de noviembre, luego 4 $ / 20 $ por millón de tokens | Mismo precio que Carbon, nueve puntos detrás en el índice Artificial Analysis |
| Claude Opus 5.5 | Sin fila MathArena en las fuentes revisadas | No listado | 4 $ / 20 $ por millón de tokens | Iguala el precio de diciembre de Carbon por token, lo lidera en el subconjunto sin conexión de OSWorld |
La elección no es Carbon o nada. Para la mayor parte del código, los documentos y el trabajo de agentes en volumen, un modelo rápido como Hydrogen o un modelo de valor como Sol terminará más tareas por dólar. Carbon gana su lugar en la cima de una tabla de rutas, no como toda la tabla. Mandale los problemas que vencieron a los modelos más baratos, el trabajo de contexto largo que necesita toda la ventana, y el trabajo de seguridad donde sus ganancias publicadas son mayores.
Veredicto final
Usa Carbon donde tener razón vale el precio, y medilo en tus propios problemas más duros antes de comprometerte. Fija un tope de tiempo y un tope de tokens en cada corrida, presupuesta a las tarifas de diciembre, y compara el costo por respuesta correcta contra Sol y Fable 5.2 en el mismo conjunto. Según la evidencia publicada, Carbon ganará algunas de esas comparaciones en calidad y perderá la mayoría en costo, y ambas mitades de esa frase importan.
Evitalo como defecto. Un modelo por defecto corre en trabajo fácil igual que en trabajo duro, y Carbon cobra tiempo frontera y tokens frontera por ambos, sin nivel gratis para suavizar las pruebas. El modelo que domina una tabla de matemáticas a quince veces el costo por corrida es una herramienta de especialista. Tratarlo como especialista, con una regla de rutas y una línea de presupuesto propia, es la forma en que se paga solo.
Fuentes
- Google: anuncio de Gemini 4 Carbon, 28 de octubre de 2026, por Koray Kavukcuoglu, tal como lo reportó VentureBeat
- Tbreak: Gemini 4 Carbon tops MathArena maths benchmark
- eesel AI: Gemini 4 Carbon pricing, $2 and $10 promo, $4 and $20 after, cost per task
- AI Pro League: Gemini 4 Carbon, LiveBench 83.5 and pricing record
- Imágenes: las imágenes del héroe y del escritorio de matemáticas son ilustraciones generadas en el estilo de la casa de Dirty Static. La imagen de la tabla de resultados es una tabla publicada por Google, acreditada arriba.
FIN DE LA TRANSMISIÓN
Mantén la curiosidad. Cuestiónalo todo.