Dirty Static // Le verdict
Vaut la peine d'être testé maintenant pendant que l'accès est gratuit, surtout pour le travail d'agent et de codage en coréen ou en anglais. Les scores sont forts sur papier et non prouvés hors de LG, les poids ne sont pas ouverts, et la période gratuite n'a aucune date de fin énoncée, alors ne construisez rien que vous ne pouvez pas en déplacer.
Idéal pourLes développeurs, les jeunes entreprises et les équipes de recherche qui veulent tester un gros modèle coréen et anglais sur des tâches d'agent, de codage et de recherche web sans coût, dans des outils qu'ils utilisent déjà
Ce qui fonctionne
- Accès API gratuit à partir du 9 novembre 2026, avec une clé API comme seule barrière énoncée, pour le développement de services et la recherche
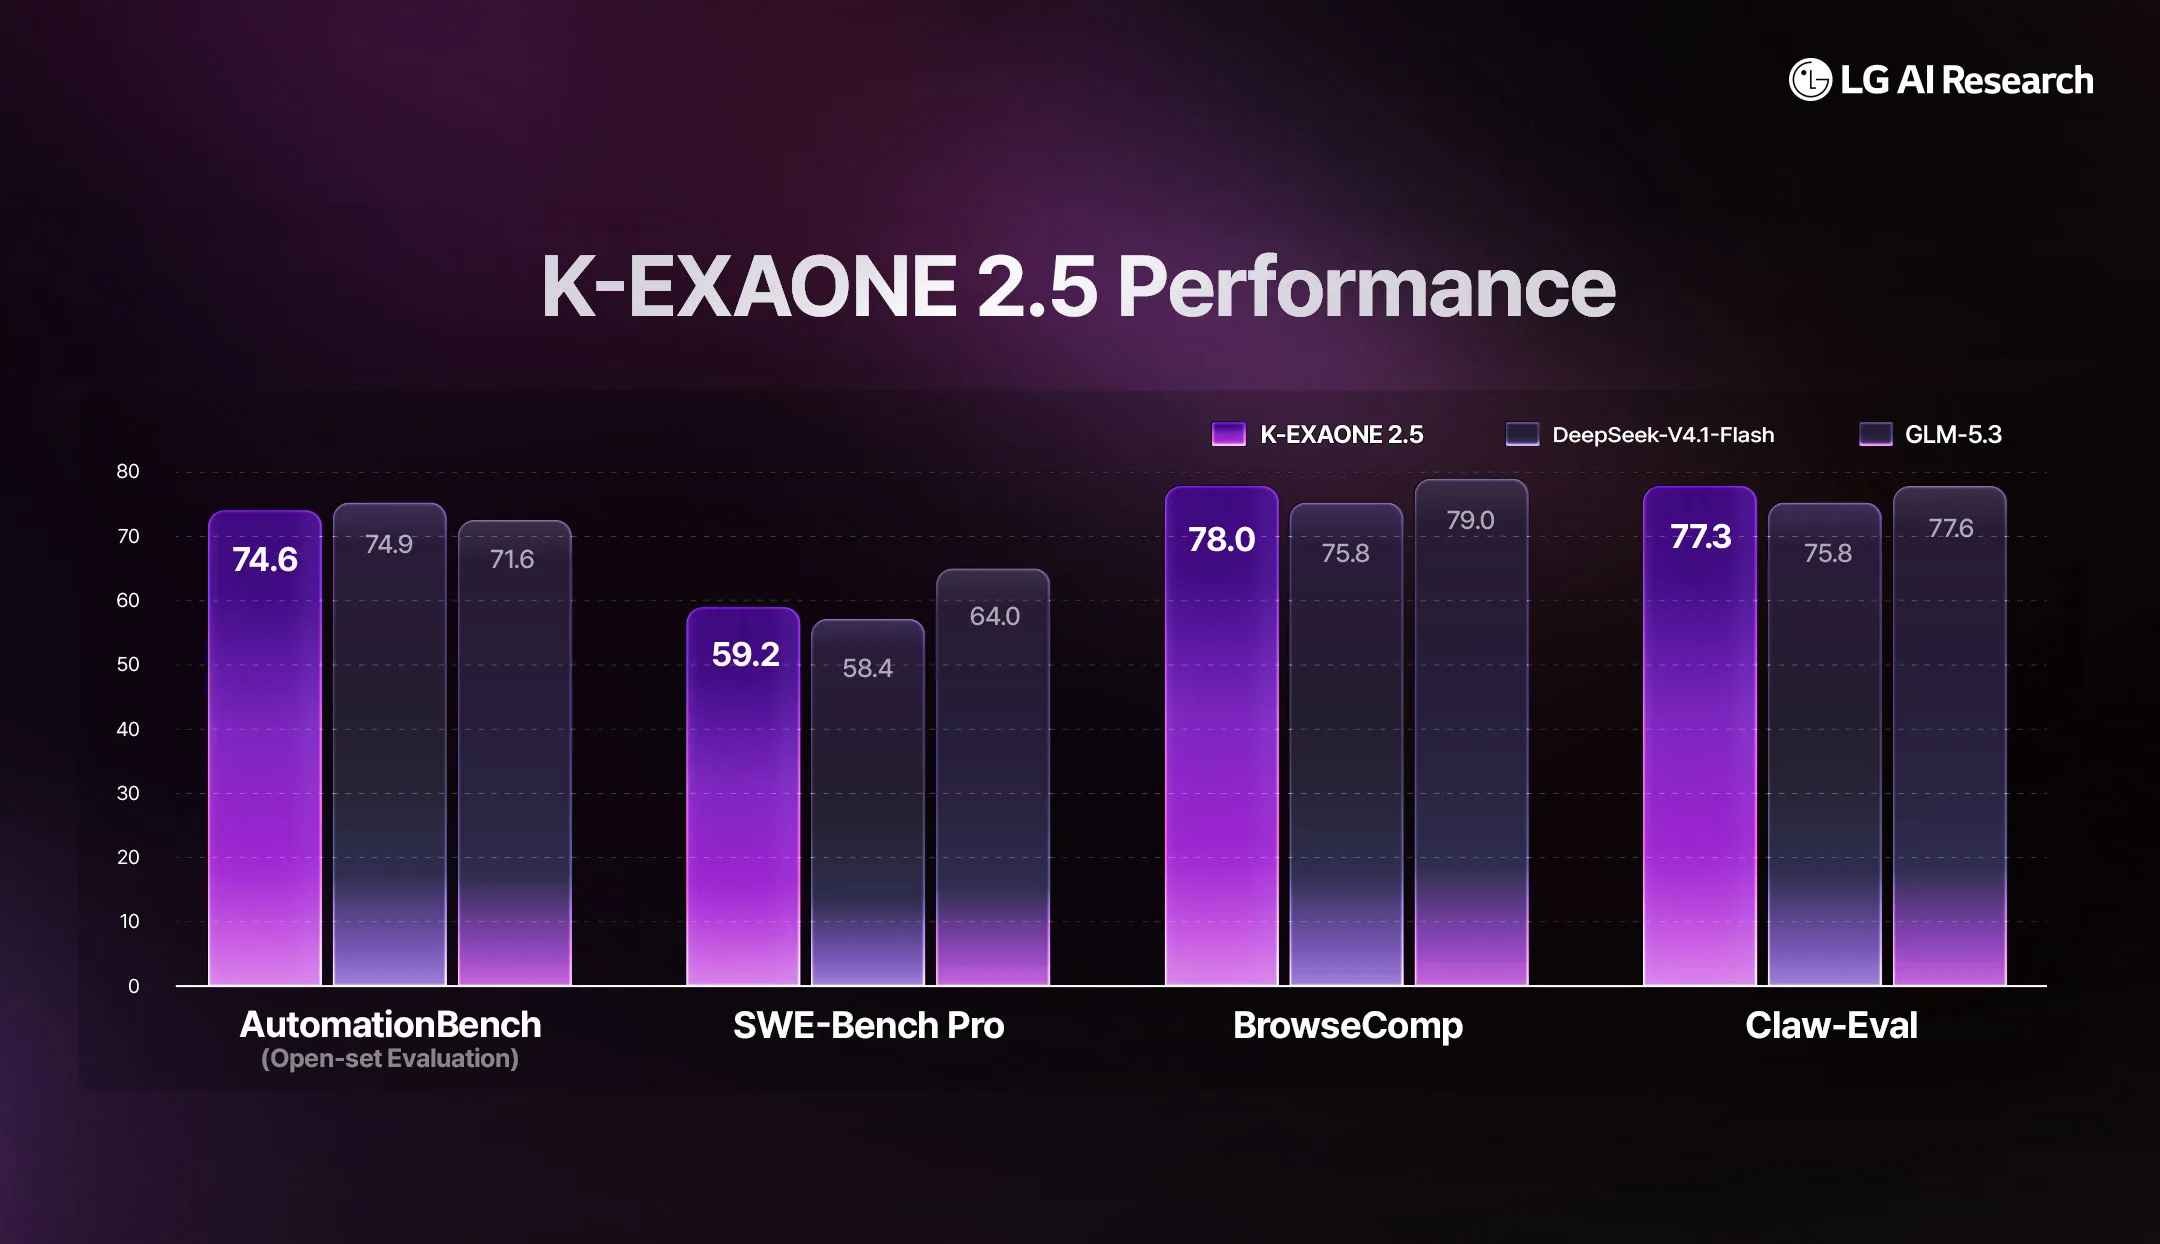
- Les scores d'agent rapportés par LG siègent au niveau de DeepSeek V4.1 Flash et GLM 5.3 sur quatre bancs d'essai publics, un saut clair par rapport au modèle d'août
- Une fenêtre de contexte de 512K jetons et un point de terminaison compatible OpenAI signifient que la plupart des équipes peuvent le tester en changeant un nom de modèle et une adresse de base
- Construit pour le travail d'agent exprès : appels d'outils, sorties structurées, diffusion et un contrôle d'effort de raisonnement sont tous des fonctions documentées
Ce qui ne fonctionne pas
- Chaque chiffre de performance de ce lancement vient des tests internes de LG sur des ensembles de données publics, sans résultat indépendant publié encore
- Cette version est un accès API seulement, sans poids ouverts annoncés, pendant que le modèle d'août a livré ses poids sous Apache 2.0
- LG n'a pas dit combien de temps l'accès gratuit dure, quels quotas s'appliquent, ou ce que le modèle coûtera quand la période gratuite se terminera
- Le modèle API affiche coréen et anglais seulement et entrée texte seulement, une offre plus étroite que les dix langues que le modèle d'août prend en charge
Test fondé sur la recherche : basé sur des essais publiés, des spécifications et de la documentation, et non sur des essais pratiques.
LG n’a pas lancé un modèle le 9 novembre. Elle a ouvert une porte. K-EXAONE 2.5, la version la plus récente du propre modèle de fondation de LG AI Research, est maintenant accessible par quiconque demande une clé API, et LG ne facture rien pour lui. L’argument tient en un chiffre : LG dit que le modèle s’est amélioré de plus de 70 pour cent en environ huit semaines.
Ce chiffre mérite respect et suspicion en parts égales. Le modèle qu’il décrit est grand, les scores d’agent que LG a publiés sont vraiment proches de deux forts rivaux chinois, et le prix en ce moment est zéro. Les scores viennent aussi tous de LG. Ce test sépare ce qui est documenté de ce qui est affirmé, pour que vous puissiez décider de dépenser un après midi à le tester ou d’attendre une preuve externe.
Ce que c’est
K-EXAONE 2.5 est un modèle de validation technologique, dans le propre langage de LG. Cette phrase compte. LG a pris K-EXAONE 2.0, le modèle qu’elle a sorti en août, et lui a appliqué un entraînement supplémentaire. Le laboratoire dit que le point était de tester une nouvelle méthode d’entraînement et de prouver que le modèle existant avait encore de gros gains en lui. Les résultats, bons ou mauvais, nourrissent maintenant le troisième modèle, que LG vise à terminer à ce qu’elle appelle le niveau frontière d’ici janvier 2027.
Un modèle de fondation est le système de base sur lequel d’autres produits construisent. K-EXAONE est l’entrée d’IA souveraine de la Corée dans cette course, développée sous le programme national de modèles de fondation, et nous avons couvert la poussée coréenne plus large dans notre rapport sur Nvidia, Rebellions et SK Telecom construisant une IA souveraine coréenne. La version 2.5 n’est pas une nouvelle base. C’est un rapport de progrès que vous pouvez appeler par une API.
L’annonce a atterri à NVIDIA AI Day Seoul 2026, tenu à COEX à Séoul le 9 novembre. LG a aussi dit qu’elle examine NVIDIA Dynamo, un système de service pour l’inférence de modèles, pour améliorer la vitesse et l’échelle. Examiner est le mot opératoire. LG n’a pas dit que Dynamo fait tourner cette API aujourd’hui.
Fonctions et spécifications
La forme du modèle a moins changé que ses scores. La taille totale reste à 750 milliards de paramètres, le même chiffre vedette que le modèle d’août. Les paramètres actifs, la tranche du modèle qui travaille sur chaque jeton, sont affichés à 31 milliards dans la documentation du modèle de la plateforme, en baisse par rapport à 37 milliards affichés pour la version 2.0. Le contexte, la quantité de texte que le modèle peut garder en tête à la fois, a doublé : 512K jetons contre 262 144 jetons dans la version 2.0. Un jeton est un petit morceau de texte, environ un mot court ou une partie d’un.
Specifications
- Maker
- LG AI Research
- Model
- K-EXAONE 2.5, model name k-exaone_v2.5 on the API
- Status
- Technology validation model, further training on the August 2026 model
- Parameters
- 750 billion total, 31 billion active, per the platform documentation
- Context window
- 512K tokens; input plus the generation allowance cannot exceed 524,288 tokens
- Languages
- Korean and English
- Input
- Text only
- Knowledge cutoff
- January 2026
- Features
- Chat, tool calling, structured outputs, code generation, streaming
- Reasoning control
- reasoning_effort set to low, high or max, with max as the default
- Access
- API key from the EXAONE API Platform; free at launch on November 9, 2026
- Weights
- No open weights announced for version 2.5
Deux détails de spécification sont faciles à manquer et valent une pause. D’abord, la liste des langues a rétréci. La version 2.0 prend en charge dix langues et est livrée comme des poids ouverts sous Apache 2.0 sur Hugging Face. La documentation de l’API de la version 2.5 affiche coréen et anglais seulement. Cela peut refléter la portée de validation plutôt qu’une limite du modèle, mais la documentation est ce sur quoi un développeur peut compter, et elle nomme deux langues.
Ensuite, le contrôle de raisonnement est exposé plutôt que caché. Le réglage reasoning_effort dit au modèle combien de temps penser avant de répondre, et un réglage séparé peut transporter le raisonnement précédent dans les tours suivants d’une conversation. Les outils d’agent vivent ou meurent sur des détails comme celui là, parce qu’une boucle d’agent envoie de nombreux tours dans les deux sens pendant que les outils tournent entre eux. Le guide d’agent de LG, selon la couverture publiée de la documentation, comprend des configurations pour l’agent Hermes et l’agent de codage OpenCode. Les lecteurs qui font tourner ces outils peuvent vouloir notre guide de configuration Hermes et notre regard sur l’exécution d’OpenCode avec d’autres agents de codage avant d’échanger un modèle.
Expérience en conditions réelles
Ceci est un test de recherche. Dirty Static ne détenait pas de clé API et n’a pas fait tourner ce modèle avant la publication, et rien ci dessous ne prétend autrement. Ce qui suit tire de l’annonce de LG, de la documentation de la plateforme telle que rapportée le jour du lancement, et du tableau de bancs d’essai que LG a elle même publié.
Le test qu’un développeur ordinaire fera est simple. Le point de terminaison parle le format de complétions de discussion OpenAI, alors le code existant qui appelle ce format peut pointer vers la plateforme EXAONE, échanger le nom de modèle k-exaone_v2.5, et envoyer les mêmes invites qu’il envoie ailleurs. Ce choix de conception est le signal pratique le plus fort de ce lancement. LG n’a pas construit un jardin fermé. Elle a construit un logement de remplacement direct et a réglé le prix à zéro.
La charge de travail que LG vise est le travail d’agent : un logiciel qui planifie des étapes, appelle des outils, lit des résultats et continue. LG a nommé la génération de code, le débogage, la refactorisation et la création de tests dans son annonce, et les quatre bancs d’essai qu’elle a choisis mesurent tous ce genre de travail plutôt que la qualité de discussion. Ce centre est honnête sur là où le laboratoire pense que ce modèle gagne sa vie.
Ce qu’aucune source ne peut encore vous dire est comment le modèle se ressent dans une longue session : à quelle fréquence les appels d’outils arrivent mal formés, comment le réglage de raisonnement maximal échange la vitesse contre la qualité, ou comment le service tient sous la charge d’une foule de nouveaux comptes gratuits. Ces réponses viennent de l’usage, pas d’un tableau de lancement, et elles sont exactement ce que LG dit vouloir que la période gratuite produise.
Scores d'agent de K-EXAONE 2.5 rapportés par LG, 9 novembre 2026
Résultats internes de LG sur des ensembles de données publics, vérifiés le 9 novembre 2026. AutomationBench mesure l'automatisation de tâches avec des outils SaaS. Claw-Eval mesure la résolution de problèmes d'agent au travail. BrowseComp mesure la recherche web et la recherche. SWE-Bench Pro mesure les tâches de développement et de modification de logiciels.
Ce qui fonctionne
Le saut depuis la version 2.0 est grand à chaque mesure que LG a publiée. Sur AutomationBench, le modèle d’août a noté 16,9 et la version 2.5 note 74,6. Sur BrowseComp, le score est monté de 50,87 à 78,0. Sur SWE-Bench Pro, il est monté de 47,1 à 59,2, et sur Claw-Eval de 62,11 à 77,3. Des gains de cette taille à partir d’un entraînement supplémentaire sur la même base sont assez rares pour que la méthode d’entraînement, quels que soient ses détails, soit la vraie histoire de cette version.
La position contre les rivaux est aussi réelle, avec une réserve gardée pour la prochaine section. La version 2.5 bat DeepSeek V4.1 Flash sur trois des quatre mesures du tableau de LG, par de petites marges : 59,21 contre 58,41 sur SWE-Bench Pro, 78,0 contre 75,8 sur BrowseComp, et 77,29 contre 75,78 sur Claw-Eval. Elle reste derrière DeepSeek d’un cheveu sur AutomationBench, 74,6 contre 74,9. Contre GLM 5.3, elle gagne seulement AutomationBench, et perd SWE-Bench Pro par un écart plus large, 59,21 contre 64,03. Au niveau du champ est un résumé juste. Devant le champ ne l’est pas.
L’offre elle même est propre. Une plateforme, une clé API, aucune étape de paiement, et un deuxième modèle sur la même plateforme, EXAONE Tabular, pour des prédictions sur des données structurées. Pour une équipe en Corée, ou une équipe n’importe où qui veut un fort modèle de langue coréenne sans router les données vers un fournisseur américain ou chinois, un test gratuit d’un modèle de 750 milliards de paramètres avec un contexte d’un demi million de jetons est un oui facile.
Ce qui ne fonctionne pas
Commencez par l’affirmation de 70 pour cent, parce que c’est le titre et la preuve la plus faible du lancement. LG dit qu’une analyse interne combinant 24 mesures d’évaluation s’est améliorée de plus de 70 pour cent contre le modèle d’août. LG n’a pas publié la liste complète des 24 mesures à côté de cette affirmation dans le matériel de lancement, ni comment le chiffre combiné a été pondéré. Les quatre scores d’agent qu’elle a publiés appuient un gros gain. Ils ne vérifient pas, par eux mêmes, un seul chiffre combiné, et aucun laboratoire externe n’a encore reproduit quoi que ce soit. Traitez 70 pour cent comme une affirmation sur la propre carte de scores de LG jusqu’à ce que quelqu’un d’autre fasse tourner les tests.
L’histoire d’ouverture a aussi reculé. La version 2.0 a donné au monde ses poids sous Apache 2.0, ce qui signifie que toute équipe pouvait la faire tourner sur son propre matériel et la garder pour toujours. La version 2.5 donne au monde une clé pour les serveurs de LG. Si la période gratuite se termine mal, ou si le service change, les utilisateurs de l’API n’ont rien sur quoi retomber sauf le modèle plus ancien. Pour un exercice de validation, cet échange est compréhensible. C’est quand même un échange, et les équipes avec des règles de données strictes remarqueront que les invites voyagent maintenant vers LG plutôt que de rester à la maison.
Enfin, les inconnues pratiques sont celles qui décident de la vraie adoption : la vitesse de réponse à chaque réglage de raisonnement, le comportement sur de longs passages d’agent, et le temps de disponibilité une fois que les comptes gratuits s’empilent. LG examine NVIDIA Dynamo pour aider au service, ce qui vous dit que le laboratoire lui même voit l’échelle comme une question ouverte. Rien de cela n’est une raison de rester loin. Tout cela est une raison de tester avec des charges de travail que vous pouvez vous permettre de refaire ailleurs.
Concurrence
Les rivaux du propre tableau de LG sont des modèles à poids ouverts de Chine, et cette comparaison coupe des deux côtés. Ils coûtent de l’argent par une API et rien à télécharger, pendant que K-EXAONE 2.5 ne coûte rien par une API et ne peut pas être téléchargé du tout.
| Option | Access | Context | The trade |
|---|---|---|---|
| K-EXAONE 2.5 | API gratuite seulement, aucun poids annoncé | 512K tokens | Test sans coût d’un modèle de 750B en coréen et en anglais, sur des conditions que LG peut changer |
| K-EXAONE 2.0 | Open weights, Apache 2.0, from August 2026 | 262,144 tokens | À vous pour toujours en dix langues, avec les scores d’agent plus faibles que LG vient de remplacer |
| DeepSeek V4.1 Flash | Open weights and a paid API | 1M tokens, per its model documentation | Accès plus large et fenêtre plus longue, à un prix par jeton, avec des scores au niveau de 2.5 dans le tableau de LG |
| GLM 5.3 | Open weights and a paid API | 1M class, per published comparisons | Le score SWE-Bench Pro le plus fort du tableau de LG à 64,03, à un prix API plus élevé que DeepSeek |
La lecture honnête est que K-EXAONE 2.5 concurrence sur le prix aujourd’hui et sur la promesse demain. Pendant que l’API est gratuite, c’est la façon la moins chère de tester des scores d’agent de classe frontière. Au moment où LG nommera un prix, la comparaison deviendra une question de confiance, de vitesse et de profondeur de langue coréenne contre des rivaux dont vous pouvez déjà tenir les poids.
Verdict final
Testez le. Ce verdict est facile pendant que le coût est une clé API et un après midi. Pointez un agent ou un flux de codage existant vers le point de terminaison, faites tourner vos propres tâches en coréen et en anglais, et comparez la sortie contre le modèle que vous utilisez maintenant. LG a construit la rampe pour exactement cette expérience, et ses scores publiés, mesurés par elle même ou non, sont assez forts pour justifier de la faire tourner.
Construisez dessus avec soin. Ne placez pas un service de production, une promesse de client ou une charge de travail sensible aux données sur une API de validation gratuite sans date de fin énoncée, sans quota publié et sans poids vers lesquels reculer. Le troisième modèle, dû d’ici janvier 2027 dans le plan de LG, est la version pour laquelle celle ci répète. La version 2.5 est votre chance d’apprendre, aux frais de LG, si cette version mérite une place dans votre pile quand elle atterrira.
Sources
- LG AI Research: K-EXAONE 2.5 API Available for Free
- Digital Today: LG AI Research opens K-EXAONE 2.5 API free, says performance up 70 percent
- Money Today: LG AI Research Institute opens free access to K-Exaone 2.5
- Unite.AI: LG AI Research Opens Free API Access to Its K-EXAONE 2.5 Model
- Spectrum Web Co: LG opens K-EXAONE 2.5 API free for developers
- Hugging Face: K-EXAONE 2.0 model card
- Images: Hero and agent illustrations are generated Dirty Static house style artwork. The benchmark chart image is from LG AI Research, credited at the image.
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.

