Beaucoup de travail IA n’est pas de l’écriture. C’est du jugement. Ce billet demande t il un remboursement. Quelle équipe devrait en être propriétaire. Cette photo montre t elle des dommages. Les équipes demandent souvent à un modèle de clavardage de répondre en prose, puis écrivent plus de code pour tirer une valeur utilisable de cette prose. Gemini Decision 1 saute la prose exprès.
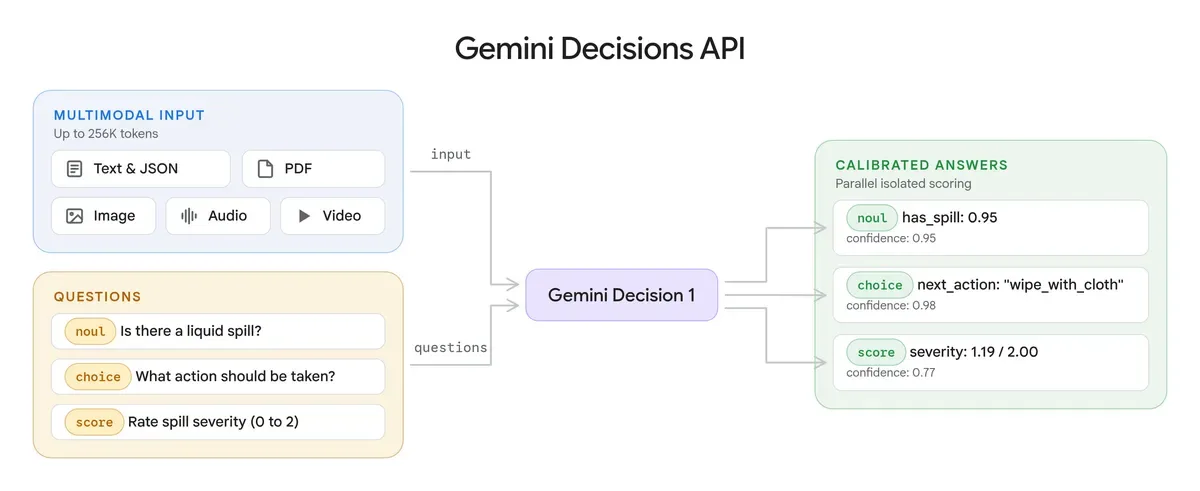
Google DeepMind a présenté le modèle le 11 novembre 2026, comme le moteur d’un nouveau point de terminaison appelé la Gemini Decisions API. Il est disponible par la Gemini API dans Google AI Studio. Vous envoyez une entrée partagée et un ensemble de questions. Le modèle note les options que vous lui avez données et retourne des nombres sur lesquels votre code peut agir aussitôt.
Gemini Decision 1
Site officielUn modèle de notation pour des choix limités, avec l’identifiant de modèle gemini-decision-1. Cas d’utilisation principal : des jugements avec un ensemble fixe de réponses, comme la sélection d’outils, les vérifications de politique, le routage de modèles et la notation de contexte, où le code a besoin d’une valeur plutôt que d’une réponse écrite.
Fonctionnalités clés : une entrée multimodale partagée facturée une fois par demande; jusqu’à 1 000 questions indépendantes en un seul passage; trois types de questions qui peuvent se mélanger en un appel; un score de confiance sur chaque réponse pour que les cas faibles puissent aller à un modèle de repli ou à une personne.
Ce qu’il fait
L’entrée peut mélanger du texte avec des images, de l’audio, de la vidéo et des fichiers PDF, jusqu’à 256K jetons en une demande. Google dit que le modèle note les options candidates en un seul passage vers l’avant plutôt que de générer du texte de réponse un jeton à la fois. Ce design est tout le point. Les jetons de sortie sont toujours zéro, alors la sortie n’est jamais facturée.
Chaque question est jugée par elle même contre l’entrée partagée. Ajouter une question ne change pas les réponses aux autres. Notre guide d’atelier montre le patron en code : utiliser la Gemini Decisions API pour des vérifications par lots construit quatre jugements sur un billet de soutien en un seul appel.
Les trois types de questions
| Type | Ce que vous demandez | Ce qui revient |
|---|---|---|
| noul | Une vérification oui ou non sur une condition | La probabilité que la condition tienne, de 0,01 à 0,99, plus la confiance |
| choice | Un choix parmi un ensemble fixe de 2 à 255 options | L’option gagnante et une probabilité normalisée pour chaque option, plus la confiance |
| score | Une note contre une rubrique ordonnée qui commence à 0 | Un score pondéré et une probabilité pour chaque niveau, plus la confiance |
La confiance est la partie sur laquelle le code s’appuiera le plus. Un score élevé avec une basse confiance n’est pas un feu vert. C’est un signal pour envoyer le cas à un modèle plus grand qui peut raisonner, ou à une personne qui peut lire le contexte que la rubrique a manqué.
 Une entrée qui entre, trois genres de jugement qui sortent. Le cadran de confiance décide de ce qui se passe ensuite. Illustration : Dirty Static
Vitesse, prix et les affirmations autour d’eux
Google cite un calcul médian de modèle de 50 à 100 millisecondes et 150 à 250 millisecondes de bout en bout, sur des entrées jusqu’à 16K jetons, avec un temps qui reste presque plat de 1 à 100 questions par demande. Google dit aussi que le modèle mène sa suite de bancs d’essai sur le routage d’agents, le raisonnement, le classement et le travail multimodal, avec la plus basse erreur de calibration dans cette suite, et qu’il coûte près de cinq fois moins que Gemini 3.5 Flash-Lite avec la Interactions API sur la même suite. Ce sont des affirmations Google du billet de lancement, pas des résultats de nos propres tests. Traitez les comme une raison de tester l’API sur vos propres données, pas comme un verdict dessus.
Le prix lui même est assez simple pour être vérifié à la main. L’entrée partagée est facturée une fois par demande à 0,10 $ par million de jetons d’entrée, peu importe combien de questions voyagent dessus. Chaque question ajoute seulement ses propres jetons d’instruction et de critères. Il n’y a aucun frais pour la sortie, et Google ne liste aucun frais séparé pour la transcription audio ou le travail de caractères optiques dans l’entrée.
Decision 1 en un coup d'œil
- Modèle
- Gemini Decision 1, model ID gemini-decision-1
- Lancé
- November 11, 2026, by Google DeepMind
- Accès
- Gemini API in Google AI Studio, version v1beta; Google Cloud support coming soon
- Entrée
- One shared input, up to 256K tokens, in text, image, audio, video, or PDF form
- Questions
- Up to 1,000 per request, of types noul, choice, and score
- Prix
- $0.10 per million input tokens, $0 for output; a no cost tier for prototyping
- Affirmation de latence
- 150 to 250 milliseconds end to end, per Google
- Faits vérifiés
- November 12, 2026
Comment Google dit que les équipes l’utilisent
Google liste quatre utilisations dans ses propres produits. Gemini Notebook utilise l’API comme un routeur qui envoie chaque requête à un niveau de modèle et un niveau de réflexion, et Google affirme jusqu’à 40 pour cent de latence plus basse pour les requêtes quotidiennes tandis que les tâches plus dures vont à des modèles de raisonnement plus profonds. Stitch l’utilise dans une expérience de canevas rapide pour construire des maquettes jouables et appliquer des éditions faites par la voix ou le toucher. Une application Google Labs appelée CC l’utilise pour choisir une réaction emoji dans une palette de plus de 200 options. Search l’utilise comme une couche de sécurité pour les outils MCP, pour détecter un comportement adversaire dans un budget de latence serré.
Hors de Google, le billet de lancement dit que des intégrations se déploient sur OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit et OpenCode, à côté des SDK Google. Cette liste compte moins comme un mur de logos que comme un signe d’ajustement. Le routage et la notation siègent dans des piles d’agents, alors un point de terminaison de notation doit se brancher dans la pile que les équipes roulent déjà.
À qui il s’adresse
Meilleur pour les équipes dont les applications font beaucoup de petits appels avec des réponses fixes. Le routage de soutien, la notation de contenu, les vérifications de politique, la sélection d’outils et le routage de modèles conviennent tous à la forme. Les vérifications de photos et de documents où la réponse est un score, pas un récit, aussi. Si votre file fait des centaines de ces appels, payer une fois pour une entrée partagée et obtenir des nombres en retour en environ un quart de seconde, selon les chiffres Google, est un design plus propre que d’analyser de la prose toute la journée.
Sautez le quand le travail a besoin de mots. Decision 1 ne peut pas rédiger une réponse, expliquer un appel limite à un client, extraire un champ qu’on ne lui a pas demandé de noter, ou raisonner par un problème en étapes. Il ne peut pas non plus sauver une mauvaise rubrique. Des critères vagues produiront des nombres qui ont l’air confiants pour la mauvaise question, et seul un ensemble de tests étiquetés de votre propre trafic le montrera avant que vos utilisateurs le fassent.
Ce qui fonctionne
- Des nombres sur lesquels le code peut agir aussitôt, sans prose à analyser et sans jetons de sortie à facturer
- Une entrée partagée facturée une fois, même avec jusqu'à 1 000 questions dans la même demande
- Un score de confiance sur chaque réponse, pour que les cas faibles puissent aller à un repli ou à une personne
- Entrée multimodale native, pour qu'une photo, un enregistrement et un PDF puissent faire face aux mêmes questions
Ce qui ne fonctionne pas
- Aucune raison et aucune explication, alors les appels limites ont encore besoin d'un modèle ou d'une personne qui peut en donner une
- Une question de choix doit choisir parmi les options qu'on lui a données, même quand aucune ne convient bien
- Les chiffres de vitesse, de banc d'essai et d'avantage de coût sont des affirmations Google, pas des tests indépendants
- Le soutien Google Cloud n'est pas encore ici, alors les équipes dans cette pile attendent
Réflexions finales
Decision 1 est une correction utile à une habitude paresseuse. Ce n’est pas chaque appel IA qui devrait être un clavardage. Quand la réponse est un choix, une note ou un appel oui ou non, un paragraphe est du gaspillage, et le code qui l’analyse est du gaspillage par dessus le gaspillage. Un score rapide avec une valeur de confiance honnête est le meilleur outil pour ce travail.
Le test qui compte n’est pas le graphique de lancement. Roulez le sur un ensemble de vos propres cas où une personne a déjà fait l’appel, vérifiez à quelle fréquence chaque bande de confiance s’avère juste, et gardez les cas qu’il se trompe où vous pouvez les étudier. Si les nombres tiennent sur vos données, c’est une plomberie bon marché et sensée pour le travail d’agent. S’ils ne tiennent pas, le score de confiance vous dit au moins où ne pas lui faire confiance, et cela seul le met devant un modèle qui écrit une réponse fluide dans les deux cas.
Ce profil est une évaluation de bureau construite à partir du billet de lancement Google et de la documentation publiée de la Decisions API. Aucun test pratique n’est revendiqué. Les prix, limites et accès ci dessus sont ceux publiés au 12 novembre 2026.
Sources
- Faits de lancement, types de questions, prix, latence, affirmations de bancs d’essai et utilisations internes : Gemini Decisions API: Fast multimodal decisions, Google Blog, November 11, 2026
- Documentation et guide de l’API, vérifiés le 12 novembre 2026 : Gemini Decisions API documentation, Google AI Studio
- Image du corps : Google, du billet de lancement. Illustration de la porte et image vedette : Dirty Static
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.

