Gran parte del trabajo con IA no es escribir. Es juzgar. ¿Este ticket pide un reembolso? ¿Qué equipo debería ser su dueño? ¿Esta foto muestra daños? Los equipos suelen pedir a un modelo de chat que responda en prosa y luego escriben más código para extraer un valor utilizable de esa prosa. Gemini Decision 1 se salta la prosa a propósito.
Google DeepMind presentó el modelo el 11 de noviembre de 2026 como el motor de un nuevo endpoint llamado Gemini Decisions API. Está disponible mediante la Gemini API en Google AI Studio. Envías una entrada compartida y un conjunto de preguntas. El modelo puntúa las opciones que le diste y devuelve números sobre los que tu código puede actuar de inmediato.
Gemini Decision 1
Sitio oficialUn modelo de puntuación para opciones acotadas, con el ID de modelo gemini-decision-1. Caso de uso principal: juicios con un conjunto fijo de respuestas, como selección de herramientas, verificaciones de políticas, enrutamiento de modelos y calificación de contexto, donde el código necesita un valor en lugar de una respuesta escrita.
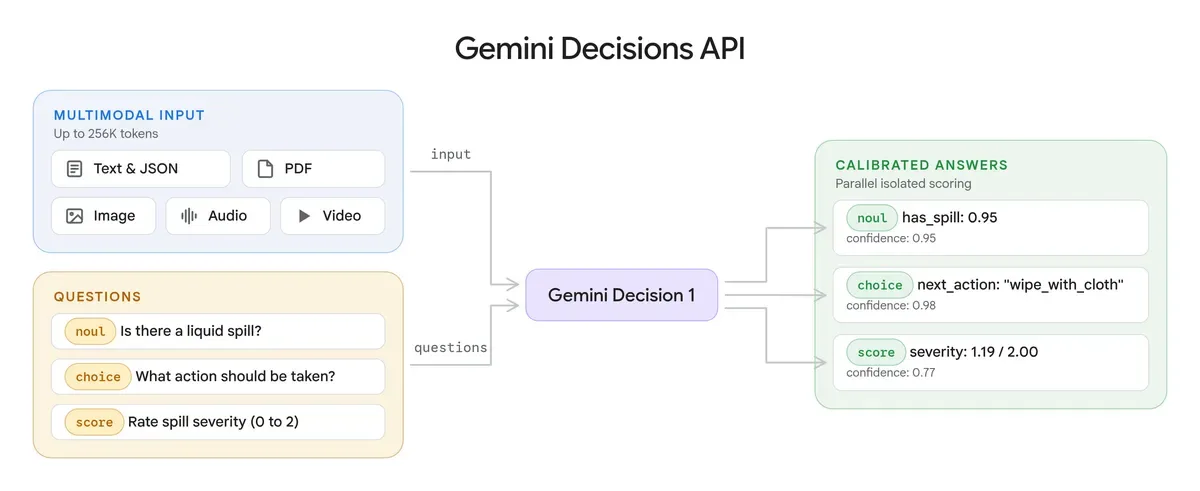
Funciones clave: una entrada multimodal compartida facturada una vez por solicitud; hasta 1,000 preguntas independientes en una sola pasada; tres tipos de preguntas que pueden mezclarse en una llamada; una puntuación de confianza en cada respuesta para que los casos débiles puedan ir a un modelo de respaldo o a una persona.
Qué hace
La entrada puede mezclar texto con imágenes, audio, video y archivos PDF, hasta 256K tokens en una solicitud. Google dice que el modelo puntúa las opciones candidatas en una sola pasada hacia adelante en lugar de generar texto de respuesta token por token. Ese diseño es todo el punto. Los tokens de salida siempre son cero, así que la salida nunca se factura.
Cada pregunta se juzga por sí sola contra la entrada compartida. Agregar una pregunta no cambia las respuestas de las demás. Nuestra guía de Workshop muestra el patrón en código: usa la Gemini Decisions API para verificaciones por lotes construye cuatro juicios sobre un ticket de soporte en una sola llamada.
Los tres tipos de preguntas
| Type | Qué preguntas | Qué vuelve |
|---|---|---|
| noul | Una verificación de sí o no sobre una condición | La probabilidad de que la condición se cumpla, de 0.01 a 0.99, más confianza |
| choice | Una elección de un conjunto fijo de 2 a 255 opciones | La opción ganadora y una probabilidad normalizada para cada opción, más confianza |
| score | Una calificación contra una rúbrica ordenada que empieza en 0 | Una puntuación ponderada y una probabilidad para cada nivel, más confianza |
La confianza es la parte en la que el código se apoyará más. Una puntuación alta con confianza baja no es luz verde. Es una señal para enviar el caso a un modelo más grande que pueda razonar o a una persona que pueda leer el contexto que la rúbrica pasó por alto.
 Una entrada, tres tipos de juicio a la salida. El dial de confianza decide qué pasa después. Ilustración: Dirty Static
Velocidad, precio y las afirmaciones en torno a ellos
Google cita una computación mediana del modelo de 50 a 100 milisegundos y de 150 a 250 milisegundos de extremo a extremo, en entradas de hasta 16K tokens, con un tiempo que se mantiene casi plano de 1 a 100 preguntas por solicitud. Google también dice que el modelo lidera su suite de benchmarks en enrutamiento de agentes, razonamiento, clasificación y trabajo multimodal, con el error de calibración más bajo en esa suite, y que cuesta casi cinco veces menos que Gemini 3.5 Flash-Lite con la Interactions API en la misma suite. Esas son afirmaciones de Google de la publicación de lanzamiento, no resultados de nuestras propias pruebas. Trátalas como una razón para probar la API con tus propios datos, no como un veredicto sobre ella.
El precio mismo es lo bastante simple como para verificarlo a mano. La entrada compartida se factura una vez por solicitud a $0.10 por millón de tokens de entrada, sin importar cuántas preguntas viajen en ella. Cada pregunta agrega solo sus propios tokens de instrucción y criterios. No hay cargo por salida y Google no lista ningún cargo separado por transcripción de audio o trabajo de caracteres ópticos dentro de la entrada.
Decision 1 de un vistazo
- Model
- Gemini Decision 1, model ID gemini-decision-1
- Launched
- 11 de noviembre de 2026, por Google DeepMind
- Access
- Gemini API en Google AI Studio, versión v1beta; soporte de Google Cloud próximamente
- Input
- Una entrada compartida, hasta 256K tokens, en forma de texto, imagen, audio, video o PDF
- Questions
- Hasta 1,000 por solicitud, de tipos noul, choice y score
- Price
- $0.10 por millón de tokens de entrada, $0 por salida; un nivel sin costo para prototipar
- Latency claim
- De 150 a 250 milisegundos de extremo a extremo, según Google
- Facts checked
- 12 de noviembre de 2026
Cómo dice Google que los equipos lo usan
Google lista cuatro usos dentro de sus propios productos. Gemini Notebook usa la API como un enrutador que envía cada consulta a un nivel de modelo y un nivel de pensamiento y Google afirma hasta un 40 por ciento menos de latencia para consultas cotidianas mientras las tareas más difíciles van a modelos de razonamiento más profundo. Stitch lo usa en un experimento de lienzo rápido para construir wireframes jugables y aplicar ediciones hechas por voz o toque. Una aplicación de Google Labs llamada CC lo usa para elegir una reacción con emoji de una paleta de más de 200 opciones. Search lo usa como una capa de seguridad para herramientas MCP, para detectar comportamiento adversarial dentro de un presupuesto de latencia ajustado.
Fuera de Google, la publicación de lanzamiento dice que las integraciones se están desplegando en OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit y OpenCode, junto a los SDK de Google. Esa lista importa menos como muro de logotipos que como señal de ajuste. El enrutamiento y la calificación viven dentro de las pilas de agentes, así que un endpoint de puntuación tiene que conectarse a la pila que los equipos ya operan.
Para quién es
Ideal para equipos cuyas aplicaciones hacen muchas llamadas pequeñas con respuestas fijas. El enrutamiento de soporte, la calificación de contenido, las verificaciones de políticas, la selección de herramientas y el enrutamiento de modelos encajan en la forma. También encajan las verificaciones de fotos y documentos donde la respuesta es una puntuación, no una historia. Si tu cola hace cientos de esas llamadas, pagar una vez por una entrada compartida y obtener números de vuelta en cerca de un cuarto de segundo, según cifras de Google, es un diseño más limpio que analizar prosa todo el día.
Sáltalo cuando el trabajo necesita palabras. Decision 1 no puede redactar una respuesta, explicar una llamada límite a un cliente, extraer un campo que no se le pidió calificar ni razonar un problema en pasos. Tampoco puede rescatar una rúbrica mala. Criterios vagos producirán números que se ven confiados para la pregunta equivocada y solo un conjunto de pruebas etiquetado de tu propio tráfico lo mostrará antes que tus usuarios.
Lo que funciona
- Números sobre los que el código puede actuar de inmediato, sin prosa que analizar y sin tokens de salida que facturar
- Una entrada compartida facturada una vez, incluso con hasta 1,000 preguntas en la misma solicitud
- Una puntuación de confianza en cada respuesta, para que los casos débiles puedan ir a un respaldo o a una persona
- Entrada multimodal nativa, para que una foto, una grabación y un PDF puedan enfrentar las mismas preguntas
Lo que no funciona
- Sin razones y sin explicación, así que las llamadas límite todavía necesitan un modelo o una persona que pueda dar una
- Una pregunta de elección debe elegir entre las opciones que se le dieron, incluso cuando ninguna encaja bien
- Las cifras de velocidad, benchmark y ventaja de costo son afirmaciones de Google, no pruebas independientes
- El soporte de Google Cloud todavía no está aquí, así que los equipos en esa pila esperan
Reflexiones finales
Decision 1 es una corrección útil a un hábito perezoso. No cada llamada de IA debería ser un chat. Cuando la respuesta es una elección, una calificación o una llamada de sí o no, un párrafo es desperdicio y el código que lo analiza es desperdicio sobre desperdicio. Una puntuación rápida con un valor de confianza honesto es la mejor herramienta para ese trabajo.
La prueba que importa no es el gráfico de lanzamiento. Ejecútalo en un conjunto de tus propios casos donde una persona ya hizo la llamada, revisa con qué frecuencia cada banda de confianza resulta correcta y guarda los casos que se equivoca donde puedas estudiarlos. Si los números se sostienen en tus datos, esto es infraestructura barata y sensata para el trabajo con agentes. Si no se sostienen, la puntuación de confianza al menos te dice dónde no confiar en él y eso solo lo pone por delante de un modelo que escribe una respuesta fluida de cualquier manera.
Este perfil es una evaluación de escritorio construida a partir de la publicación de lanzamiento de Google y la documentación publicada de la Decisions API. No se afirma ninguna prueba práctica. Los precios, límites y acceso anteriores son los publicados al 12 de noviembre de 2026.
Fuentes
- Datos de lanzamiento, tipos de preguntas, precios, latencia, afirmaciones de benchmark y usos internos: Gemini Decisions API: Fast multimodal decisions, Google Blog, November 11, 2026
- Documentación y guía de la API, verificadas el 12 de noviembre de 2026: Gemini Decisions API documentation, Google AI Studio
- Imagen del cuerpo: Google, de la publicación de lanzamiento. Ilustración de la puerta y principal: Dirty Static
FIN DE LA TRANSMISIÓN
Mantén la curiosidad. Cuestiónalo todo.

