OpenAI met fin à la division qui gardait vos clavardages et votre codage dans des pots séparés. À partir de décembre, une lourde exécution de Codex et une longue session avec un modèle avancé dans ChatGPT puiseront dans la même allocation pour les abonnés Plus, Pro et Business.
Le changement compte le plus pour les personnes qui utilisent les deux produits intensément dans la même journée. Un travail qui ne coûtait rien par rapport à Codex jusqu’à maintenant coûtera par rapport à lui à partir de décembre, à moins que ce travail reste dans le clavardage Instant.
L’annonce
OpenAI a exposé le changement dans un article du Centre d’aide intitulé Understanding ChatGPT and Codex usage limits. L’article donne la raison en une ligne, et elle concerne la forme du produit autant que la facturation.
« À partir de décembre, l’allocation d’utilisation des forfaits Plus, Pro et Business sera partagée entre ChatGPT et Codex alors que nous apportons les capacités agentiques de Work dans l’expérience principale de ChatGPT. »
L’utilisation sera mesurée en jetons, qu’OpenAI définit comme les unités d’information qu’un modèle traite et génère. La quantité de l’allocation qu’une demande utilise dépendra du modèle choisi et de la tâche demandée, et l’article dit que les modèles plus avancés et les tâches complexes utilisent généralement davantage de l’allocation.
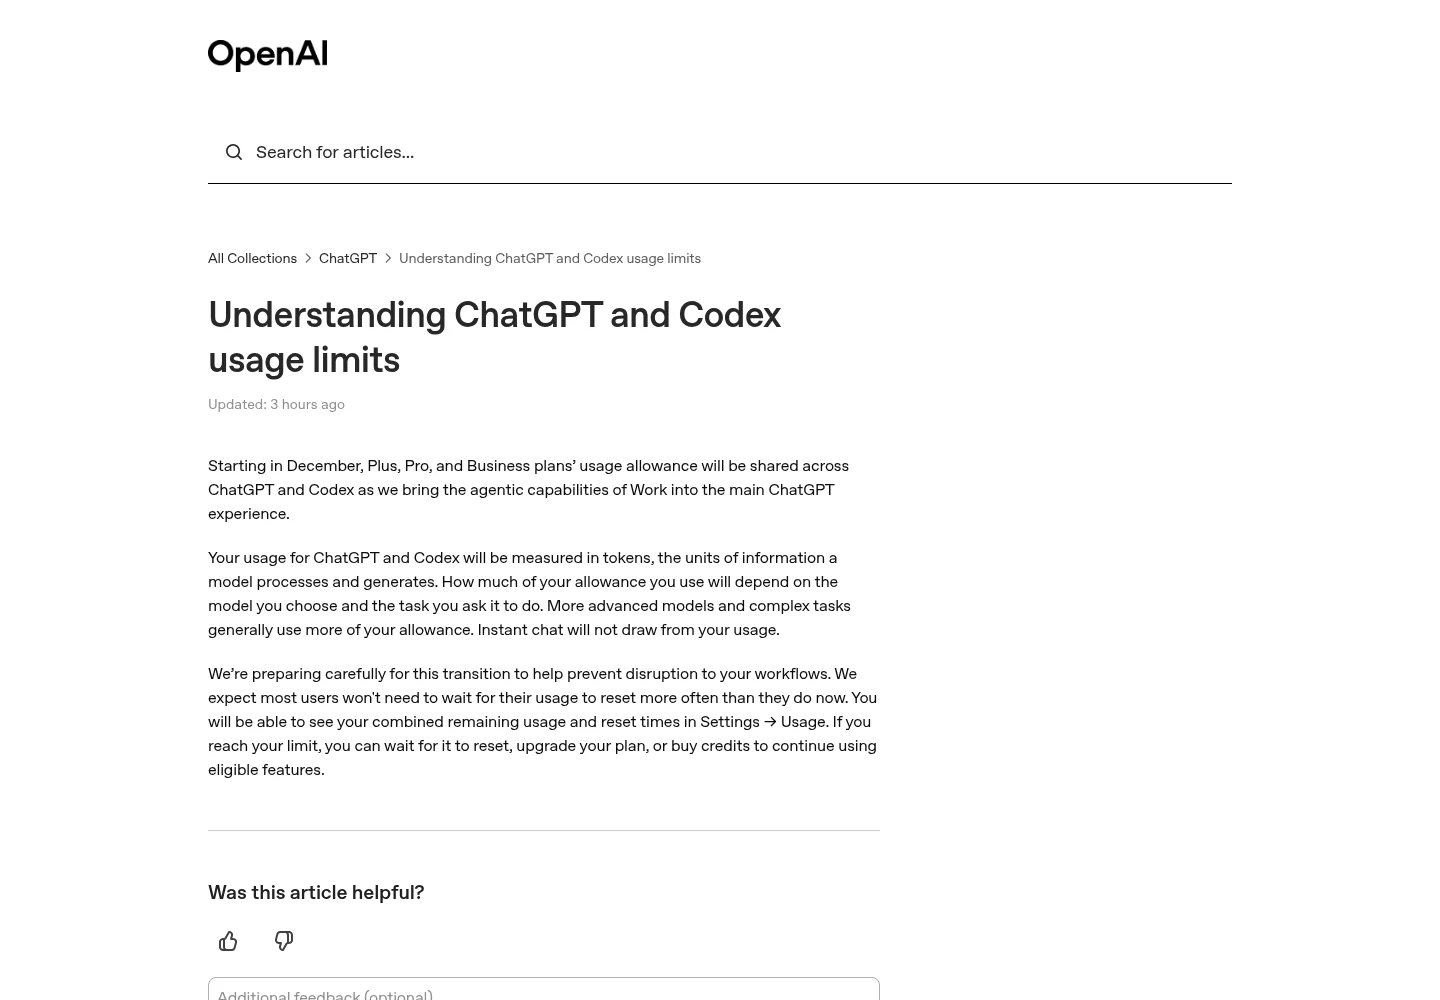
Une exception est nommée clairement. Le clavardage Instant ne puisera pas dans votre utilisation, donc les questions rapides sur Instant restent à l’extérieur du bassin partagé. Tout le reste dans ChatGPT et Codex se trouve à l’intérieur.
Les abonnés verront l’utilisation restante combinée et les heures de réinitialisation dans Paramètres, puis Utilisation. Si la limite est atteinte, OpenAI liste trois options : attendre qu’elle se réinitialise, mettre à niveau votre forfait, ou acheter des crédits pour continuer d’utiliser les fonctions admissibles.
Ce qui se partage déjà, et ce qui se joint en décembre
Une partie de ce bassin existe déjà. Dans son guide sur l’utilisation de Codex avec un forfait ChatGPT, OpenAI dit que Codex, ChatGPT Work, ChatGPT pour Excel et Workspace Agents utilisent une allocation et un bassin de crédits partagés quand ces fonctions sont offertes dans votre forfait. L’utilisation là dépend du modèle, de l’endroit où la tâche s’exécute, de la complexité de la tâche, du contexte, du raisonnement, de la vitesse et des outils, et une tâche de longue durée peut utiliser beaucoup plus qu’une courte demande.
Les clavardages ordinaires ont fonctionné sous des limites séparées jusqu’à maintenant, comme l’explique la couverture du changement au Centre d’aide. Décembre apporte ces clavardages dans le bassin, avec Instant comme seule exception déclarée. Les lecteurs qui jonglent avec plusieurs agents de codage, comme dans notre guide pour exécuter Claude Code, Codex et Opencode ensemble, sentiront cette jonction le plus directement dans Codex.
OpenAI dit qu’elle se prépare avec soin pour la transition afin d’aider à prévenir les perturbations des flux de travail. Elle dit aussi qu’elle s’attend à ce que la plupart des utilisateurs n’aient pas besoin d’attendre que leur utilisation se réinitialise plus souvent qu’ils le font maintenant. Cette deuxième ligne est une attente de l’entreprise, et non une garantie, et elle arrive sans aucun chiffre d’allocation pour la tester.
Détails importants
| Élément | Détail |
|---|---|
| Forfaits nommés | Plus, Pro et Business |
| Début | Décembre, sans date exacte donnée |
| Ce qui est partagé | Une seule allocation d’utilisation entre ChatGPT et Codex |
| Unité | Jetons, les unités qu’un modèle traite et génère |
| Ce qui coûte plus | Les modèles plus avancés et les tâches complexes, généralement |
| Ce qui est exempté | Le clavardage Instant |
| Où vérifier | Paramètres, puis Utilisation, pour l’utilisation restante combinée et les heures de réinitialisation |
| À la limite | Attendre la réinitialisation, mettre à niveau le forfait, ou acheter des crédits pour les fonctions admissibles |
| Tailles des allocations | Non publiées pour aucun forfait |
| Autres forfaits | Free, Go, Enterprise et Edu ne sont pas mentionnés dans l’article d’annonce |
Les chiffres manquants sont l’histoire dans l’histoire. Sans une allocation de jetons pour chaque forfait, aucun abonné ne peut comparer le nouveau bassin avec les deux budgets qu’il remplace, et aucune équipe ne peut planifier la capacité de décembre à partir de la seule annonce.
Le contexte des jours précédant l’avis joue dans les deux sens. La couverture par Mad Robot signale qu’OpenAI a annulé une réduction prévue de l’allocation Pro 200 pour Work et Codex à la fin d’octobre, une réduction qui l’aurait fait passer de 20 fois à 10 fois l’allocation Plus, et a plutôt doublé les allocations Pro 100 et Pro 500. Ces mouvements sont un contexte signalé, et non une partie de l’article de décembre lui-même, et OpenAI n’a pas dit comment ils se traduisent dans le nouveau bassin partagé.
Pourquoi le choix de modèle comptera davantage
OpenAI publie déjà des estimations qui montrent à quel point l’écart entre les modèles peut être large. Sur sa page de prix Codex, les estimations actuelles pour les messages locaux dans une fenêtre de cinq heures sur Plus vont de 5 à 45 avec GPT-6 Astra à 350 à 3000 avec GPT-6 Luna. La page souligne que ce sont des estimations, et non des limites de messages fixes, que les tâches infonuagiques peuvent utiliser davantage de l’allocation que les messages locaux, et que des limites hebdomadaires peuvent aussi s’appliquer.
Estimations actuelles de Plus pour les messages Codex locaux dans une fenêtre de cinq heures
Source : page de prix Codex d'OpenAI, vérifiée le 2 novembre 2026. Les barres utilisent l'extrémité supérieure de chaque fourchette publiée. Ce sont des estimations actuelles pour Work et Codex, et non des chiffres d'allocation de décembre.
Cet écart explique pourquoi un compteur de jetons change le comportement. Une tâche de routine exécutée sur un modèle léger et une tâche difficile exécutée sur un modèle avancé ne tomberont plus dans des mondes séparés une fois que le clavardage se joint au même bassin. Les forfaits Pro n’ont actuellement aucune limite de cinq heures dans Work et Codex sur la page de prix, mais l’article de décembre ne dit pas si cet arrangement reste, change, ou prend une nouvelle forme.
Ce qui vient ensuite
Les étapes confirmées sont étroites. L’allocation partagée commence à un moment en décembre pour les trois forfaits nommés, les soldes combinés apparaîtront dans Paramètres, puis Utilisation, et les trois options à la limite sont attendre, mettre à niveau ou acheter des crédits. Rien d’autre dans l’article n’est daté ni dimensionné.
Les questions ouvertes sont importantes, et elles doivent rester étiquetées comme ouvertes. OpenAI n’a publié ni date de début exacte, ni allocations de jetons par forfait, ni aucune déclaration sur la question de savoir si les fenêtres actuelles et les plafonds par modèle dans le clavardage restent à côté du bassin ou sont remplacés par lui. Elle n’a pas non plus dit, dans cet article, comment le bassin Business est compté pour chaque membre par rapport à un espace de travail dans son ensemble.
Les reportages sur l’avis ajoutent deux petits signaux, tous deux non vérifiés comme politique. Des abonnés sur Hacker News disent qu’OpenAI a envoyé le changement par courriel sous des titres sur le rapprochement de Chat et de Work, comme l’a signalé Mad Robot, et que ce reportage n’a trouvé aucun article de blogue ni aucune déclaration au-delà de la page du Centre d’aide. Traitez les deux comme de la couleur signalée jusqu’à ce qu’OpenAI publie davantage, et non comme des détails de déploiement confirmés.
Pour les abonnés, le geste pratique en novembre est la mesure. Vérifiez Paramètres, puis Utilisation, notez comment l’utilisation du clavardage et de Codex se répartit sur une semaine normale, et déplacez les questions quotidiennes vers Instant là où Instant est assez bon. Quand les chiffres de décembre arriveront, ce registre est la seule base honnête pour juger si le bassin unique est généreux, serré, ou à peu près le même.
Sources
- OpenAI Help Center : Understanding ChatGPT and Codex usage limits
- OpenAI Help Center : Using Codex with your ChatGPT plan
- OpenAI : Codex pricing page
- Mad Robot : ChatGPT and Codex will share one usage limit from December
- Capture d’écran : OpenAI Help Center
- Image du corps : illustration de style maison Dirty Static
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.

