Faire tourner un modèle sur un GPU n a jamais été la partie difficile à elle seule. La partie difficile est tout ce qui l entoure. Vous choisissez une instance, vous gardez le pilote et la trousse CUDA au même pas que votre image, vous planifiez la capacité, vous écrivez la logique de mise à l échelle, puis vous construisez le câblage qui relie cette étape GPU au reste de votre application.
Le soutien GPU de AWS Lambda est une tentative pour retirer ce travail d entourage pour une classe de tâches. AWS a annoncé le 18 novembre 2026 que les fonctions Event sur Lambda Managed Instances peuvent maintenant tourner sur des instances GPU EC2 de série G. Vous apportez une fonction sous forme d image de conteneur, et Lambda s occupe de l approvisionnement, de la mise à l échelle et de l intégration aux événements.
AWS Lambda GPU on Managed Instances
Site officielUne façon sans serveur de faire tourner du travail GPU dans une application AWS. Cas d usage principal : inférence de modèles sur mesure et autres tâches GPU déclenchées par des événements AWS et placées comme une étape dans une application Lambda plus large.
Fonctions clés : images de base préparées pour CUDA, PyTorch, vLLM et SGLang; un fournisseur de capacité qui choisit l instance disponible la plus rentable dans votre liste; les mêmes plus de 200 sources d événements que les autres fonctions Event; des demandes en même temps dans un seul environnement d exécution; et des mesures GPU dans Amazon CloudWatch et la console Lambda.
Ce que c est
Lambda Managed Instances est la partie de Lambda qui fait tourner les fonctions Event sur des instances EC2 dans votre propre compte et dans votre propre VPC, pendant que Lambda gère encore le cycle de vie des instances, les correctifs, le routage, la répartition de charge et la mise à l échelle. Le soutien GPU étend cette base aux instances de série G.
Cette distinction compte. Ce n est pas le modèle Lambda classique où vous payez seulement pour les millisecondes pendant lesquelles une fonction tourne. La fonction tourne sur une capacité EC2 que Lambda approvisionne pour vous, et la facture suit cette capacité. Ce que vous laissez de côté dans la facturation pure à l usage, vous le gagnez en choix de matériel, en tâches plus longues, et dans la capacité de garder un GPU occupé avec beaucoup de demandes à la fois.
AWS est clair sur la portée visée. L entreprise dit que la fonction est optimisée pour l inférence plutôt que pour l entraînement, et pour les modèles sur mesure plutôt que pour les grands modèles de fondation déjà offerts sur Amazon Bedrock.
Ce que vous pouvez construire
AWS nomme cinq grands types de travail. L inférence de modèles sur mesure couvre les modèles de décision, la vision par ordinateur, la parole vers le texte et le texte vers la parole, la recommandation, l analyse de documents, et les modèles de langue de petite à moyenne taille qui font partie d une application. Un deuxième groupe est l inférence pour les agents, où un modèle sur mesure est déclenché directement par un événement AWS et composé avec le reste de l application.
Les autres groupes sortent entièrement des modèles de langue. Le traitement et le transcodage de médias peuvent tourner comme des chaînes déclenchées lors d un téléversement. Le travail de rendu couvre le rendu d images et de ressources, la diffusion, et la génération de texte vers vidéo. Le calcul scientifique et la modélisation financière couvrent les simulations, le calcul matriciel et l analyse de risque.
Comment une fonction GPU fonctionne
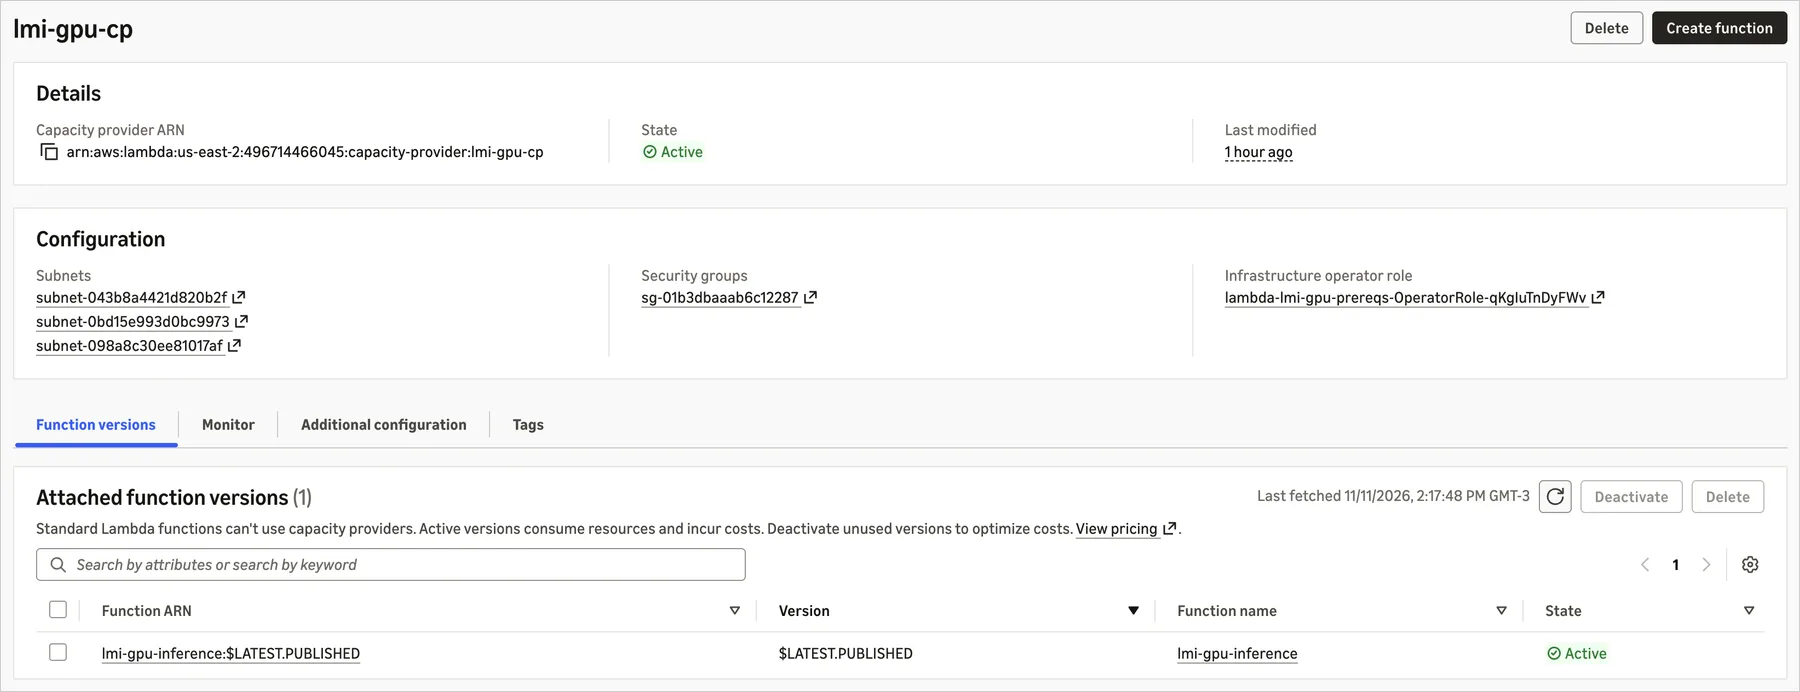
Vous commencez par un fournisseur de capacité. Vous y nommez les types d instances que Lambda peut utiliser, par exemple g5.2xlarge, g6.2xlarge et g6e.2xlarge, et vous réglez sa mise à l échelle. Nommer plusieurs types n est pas de la décoration. Cela laisse Lambda choisir d abord une option disponible moins chère et passer à une autre génération quand le premier choix n a pas de capacité.
Ensuite vous construisez une image de conteneur. Les fonctions GPU partent en images de conteneur OCI, et AWS fournit des images de base préparées pour que vous n installiez pas et ne réconciliiez pas vous même la pile logicielle GPU. Les images nommées par AWS sont base:cuda pour la trousse et le moteur CUDA, cupy:cuda pour CuPy avec NumPy, SciPy, Pandas et Numba, pytorch:cuda pour PyTorch avec torchvision, torchaudio, transformers et FFmpeg, et les images de service vllm:cuda et sglang:cuda.
L exemple de lancement montre à quel point cela peut être mince. Avec l image de base vLLM, tout le Dockerfile dans l article AWS tient en une ligne qui nomme cette image de base. Vous réglez la variable d environnement MODEL_ID sur un modèle sur Hugging Face ou ModelScope, sur un emplacement Amazon S3, ou sur un chemin local, et Lambda télécharge le modèle, gère la mémoire GPU, et sert les demandes dans le format compatible OpenAI que l image fournit. AWS dit que cette route a pris environ 10 minutes dans son exemple, la plus grande partie sans surveillance pendant que la capacité était approvisionnée et que le modèle se réchauffait.
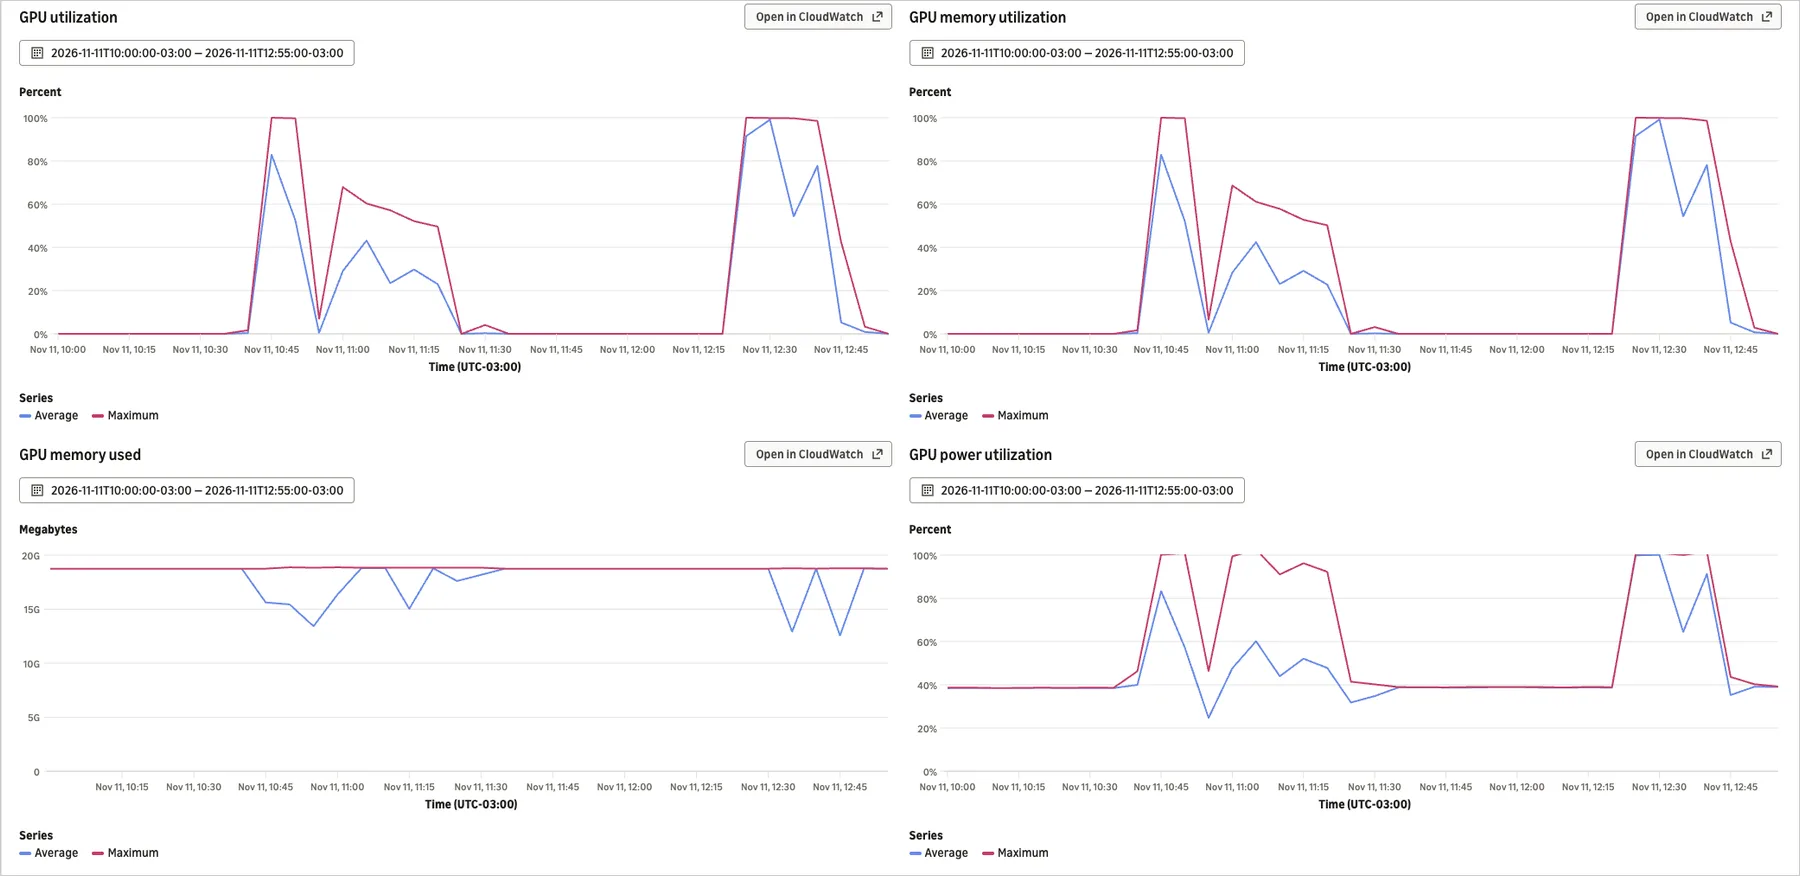
Deux réglages façonnent la façon dont le GPU est utilisé. AcceleratorConfig règle AcceleratorMemorySize, la mémoire d accélérateur minimale dont la fonction a besoin, de 3 à 48 Go, et Lambda place le travail sur le plus petit GPU disponible qui y répond. PerExecutionEnvironmentMaxConcurrency règle combien de demandes un environnement d exécution peut traiter à la fois, jusqu à 48. Dans l exemple AWS, quatre invocations en même temps ont fini en environ le même temps qu une seule, parce que le serveur vLLM les a regroupées sur un GPU qui partageait une seule copie du modèle.
Les fonctions tournent à partir d une version publiée, et ce moment aide. La publication approvisionne les environnements d exécution, et chacun télécharge les poids du modèle et réchauffe le moteur avant que la version devienne active. Le coût du démarrage à froid tombe au moment de la publication plutôt que sur le premier appelant, même si une nouvelle version ou un nouveau modèle a encore besoin de ce réchauffement.
Limites et plateformes
Faits vérifiés le 19 novembre 2026 contre l article de lancement AWS et la page de prix AWS Lambda.
Specifications
- Announced
- November 18, 2026, generally available at launch
- Instance families
- G4dn, G5, G6, G6f, Gr6, Gr6f, and G6e at launch, with more families promised
- Container image
- Up to 32 GB, with 10 GB per file
- Ephemeral storage
- Up to 32 GB of NVMe storage in /tmp
- Memory
- 2,048 to 32,768 MB
- Accelerator memory
- 3 to 48 GB requested per function
- Concurrency
- Up to 48 concurrent requests per execution environment
- Capacity
- Up to 15,000 vCPUs per capacity provider
- Timeout
- Up to 90 minutes for asynchronous and event source mapping invocations
| Famille | GPU noté dans la couverture de lancement | Mémoire d accélérateur |
|---|---|---|
| G4dn | NVIDIA T4 | 16 Go |
| G5 | NVIDIA A10G | 24 Go |
| G6 et Gr6 | NVIDIA L4 | 24 Go |
| G6e | NVIDIA L40S | 48 Go |
Le tableau couvre les familles que AWS et la couverture de lancement nomment le plus souvent. La liste complète de lancement comprend aussi les variantes G6f, Gr6f et Gr6, et la demande de la fonction elle même est dite en mémoire d accélérateur plutôt que comme un GPU nommé, donc Lambda peut placer le travail sur un GPU plus grand que le minimum demandé.
Les fonctions GPU se déclenchent à partir des mêmes sources d événements que les autres fonctions Event, dont Amazon S3, Amazon SQS, Amazon API Gateway et Amazon EventBridge, avec la même mise à l échelle, la même gestion d erreurs et les mêmes relances, et sans code d intégration sur mesure. Elles se composent aussi avec le reste de Lambda. Les fonctions durables peuvent orchestrer des flux plus longs autour de l étape GPU avec des points de contrôle et une reprise, et les Lambda MicroVMs peuvent faire tourner la logique d outil sur CPU et appeler la fonction GPU seulement pour l étape d inférence.
Prix
Il y a trois parties dans la facture Managed Instances, et les fonctions GPU utilisent le taux GPU pour celle du milieu.
| Frais | Taux pour fonction GPU |
|---|---|
| Demandes | 0,20 $ par million de demandes |
| Frais de gestion | 9,75 pour cent en plus du prix EC2 pour les instances GPU de série G |
| Instances EC2 | Prix habituel des instances EC2 pour la capacité que Lambda approvisionne |
AWS note que les fonctions Managed Instances ne payent pas de frais séparé pour la durée d exécution de chaque demande, contrairement aux fonctions Lambda par défaut. Les Savings Plans et les Reserved Instances peuvent s appliquer à la partie EC2 de la facture, et une réservation de capacité EC2 On Demand qui correspond à la configuration de votre fournisseur de capacité peut servir pour une disponibilité GPU plus prévisible.
Cette structure porte un avertissement bien en vue. Vous payez pour la capacité d instance, donc un GPU au repos coûte de l argent de la même façon qu un GPU au repos que vous gérez vous même coûte de l argent. Les frais de gestion achètent la liberté face aux pilotes, au code de mise à l échelle et aux opérations de parc. Sur un travail qui tourne à plein régime toute la journée, ces frais sont un vrai pourcentage sur une grosse facture d instance. Sur un travail qui arrive par vagues, par événements, ou comme une étape dans une application plus large, éviter un parc GPU permanent peut valoir plus que ce que les frais coûtent.
Ce qui fonctionne
- Aucun pilote GPU, aucune version CUDA, aucun AMI, aucun cluster et aucun module d appareil à opérer, avec des images préparées pour PyTorch, vLLM et SGLang
- Les mêmes sources d événements, la même identité, le même réseau et les mêmes outils que le reste de Lambda, dans votre propre VPC
- Des demandes en même temps partagent un GPU et une copie du modèle, ce qui hausse l utilisation sur les petits modèles
- Le travail de démarrage à froid se fait quand une version est publiée, pas quand le premier appelant arrive, et les délais atteignent 90 minutes pour le travail asynchrone
Ce qui ne fonctionne pas
- Vous payez pour la capacité EC2 plutôt que seulement pour la durée des demandes, donc le temps GPU au repos tombe quand même sur la facture, plus des frais de gestion de 9,75 pour cent
- La portée est l inférence et les modèles sur mesure par conception, pas l entraînement et pas un remplacement pour les grands modèles de fondation sur Bedrock
- Les nouveaux comptes peuvent avoir besoin d une hausse de quota avant que le premier test puisse tourner
- Les limites de conteneur, de stockage et de mémoire d accélérateur plafonnent la taille du modèle et du travail qui tiennent dans une fonction
Lequel choisir
Choisissez Lambda GPU quand le modèle est le vôtre et que le travail arrive comme un événement. Un classifieur ajusté, un modèle de vision, un modèle de parole, ou un petit modèle de langue qui siège dans une chaîne de documents ou un flux d agent est la forme pour laquelle AWS a construit ceci. Le gain est que l étape GPU rejoint l application que vous avez déjà, avec les mêmes déclencheurs et la même histoire d opérations.
Choisissez Amazon Bedrock quand le modèle est un modèle de fondation général. AWS fait ce choix lui même. Si le modèle que vous voulez est déjà servi sur Bedrock, faire tourner votre propre copie GPU d un modèle semblable sur Lambda ajoute du travail sans ajouter le contrôle dont vous avez besoin.
Calculez le prix d un parc que vous gérez vous même quand l utilisation reste haute toute la journée. Si un GPU sera saturé jour et nuit, comparez la facture complète d instance plus les frais de 9,75 pour cent contre le coût de bien faire tourner cette instance vous même. Les frais se justifient le plus facilement quand ils remplacent un travail de parc qui arrive par vagues, à l occasion, ou réparti entre beaucoup de petites fonctions qui peuvent partager la capacité.
Réflexions finales
Pendant des années, l histoire Lambda s arrêtait au point exact où beaucoup d applications IA commencent, parce que la fonction pouvait orchestrer un modèle mais ne pouvait jamais être le modèle. Cet écart est maintenant fermé pour une tranche de travail définie et utile : inférence sur mesure, tâches de médias, rendu et simulation qui sont déclenchés par des événements et qui vivent dans une application AWS. Cela ne remplacera pas un cluster d entraînement ou un service de modèles de fondation, et AWS ne prétend pas que ce sera le cas. Ce que cela fait, c est laisser une équipe ajouter une étape GPU à une application qu elle fait déjà tourner, sans ouvrir une deuxième pile d infrastructure juste pour tenir cette étape.
Sources
- Lancement, portée, limites, images et exemple : AWS Lambda now supports GPU instances for Event Functions on Lambda Managed Instances, AWS News Blog, November 18, 2026
- Aperçu Managed Instances : AWS Lambda Managed Instances, AWS
- Captures d écran de console : AWS
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.