Ejecutar un modelo en una GPU nunca ha sido la parte difícil por sí sola. La parte difícil es todo lo que la rodea. Eliges una instancia, mantienes el controlador y el kit CUDA al mismo paso que tu imagen, planificas la capacidad, escribes la lógica de escalado, y luego construyes el cableado que conecta ese paso GPU con el resto de tu aplicación.
El soporte GPU de AWS Lambda es un intento de quitar ese trabajo de entorno para una clase de tarea. AWS anunció el 18 de noviembre de 2026 que las funciones Event en Lambda Managed Instances ahora pueden ejecutarse en instancias GPU EC2 de la serie G. Traes una función como imagen de contenedor, y Lambda se encarga del aprovisionamiento, el escalado y la integración con eventos.
AWS Lambda GPU on Managed Instances
Sitio oficialUna forma sin servidor de ejecutar trabajo GPU dentro de una aplicación AWS. Caso de uso principal: inferencia de modelos a medida y otros trabajos GPU que se activan con eventos AWS y se colocan como un paso dentro de una aplicación Lambda más amplia.
Funciones clave: imágenes base preparadas para CUDA, PyTorch, vLLM y SGLang; un proveedor de capacidad que elige la instancia disponible más rentable de tu lista; las mismas más de 200 fuentes de eventos que las demás funciones Event; solicitudes a la vez dentro de un solo entorno de ejecución; y métricas GPU en Amazon CloudWatch y la consola Lambda.
Qué es
Lambda Managed Instances es la parte de Lambda que ejecuta funciones Event en instancias EC2 en tu propia cuenta y en tu propia VPC, mientras Lambda sigue gestionando el ciclo de vida de las instancias, los parches, el enrutamiento, el balanceo de carga y el escalado. El soporte GPU extiende esa base a las instancias de la serie G.
Esa distinción importa. Este no es el modelo clásico de Lambda donde pagas solo por los milisegundos en que se ejecuta una función. La función se ejecuta en capacidad EC2 que Lambda aprovisiona para ti, y la factura sigue esa capacidad. Lo que dejas de lado en facturación pura por uso, lo ganas en elección de hardware, trabajos más largos, y la capacidad de mantener una GPU ocupada con muchas solicitudes a la vez.
AWS es claro sobre el alcance buscado. La empresa dice que la función está optimizada para inferencia en lugar de entrenamiento, y para modelos a medida en lugar de grandes modelos fundacionales que ya están disponibles en Amazon Bedrock.
Qué puedes construir con esto
AWS nombra cinco grandes tipos de trabajo. La inferencia de modelos a medida cubre modelos de decisión, visión por computadora, voz a texto y texto a voz, recomendación, análisis de documentos, y modelos de lenguaje de tamaño pequeño a mediano que forman parte de una aplicación. Un segundo grupo es la inferencia para agentes, donde un modelo a medida se activa directamente con un evento AWS y se compone con el resto de la aplicación.
Los demás grupos quedan por completo fuera de los modelos de lenguaje. El procesamiento y la transcodificación de medios pueden ejecutarse como cadenas activadas al subir un archivo. El trabajo de renderizado cubre renderizado de cuadros y recursos, difusión, y generación de texto a video. La computación científica y el modelado financiero cubren simulaciones, cálculo matricial y análisis de riesgo.
Cómo funciona una función GPU
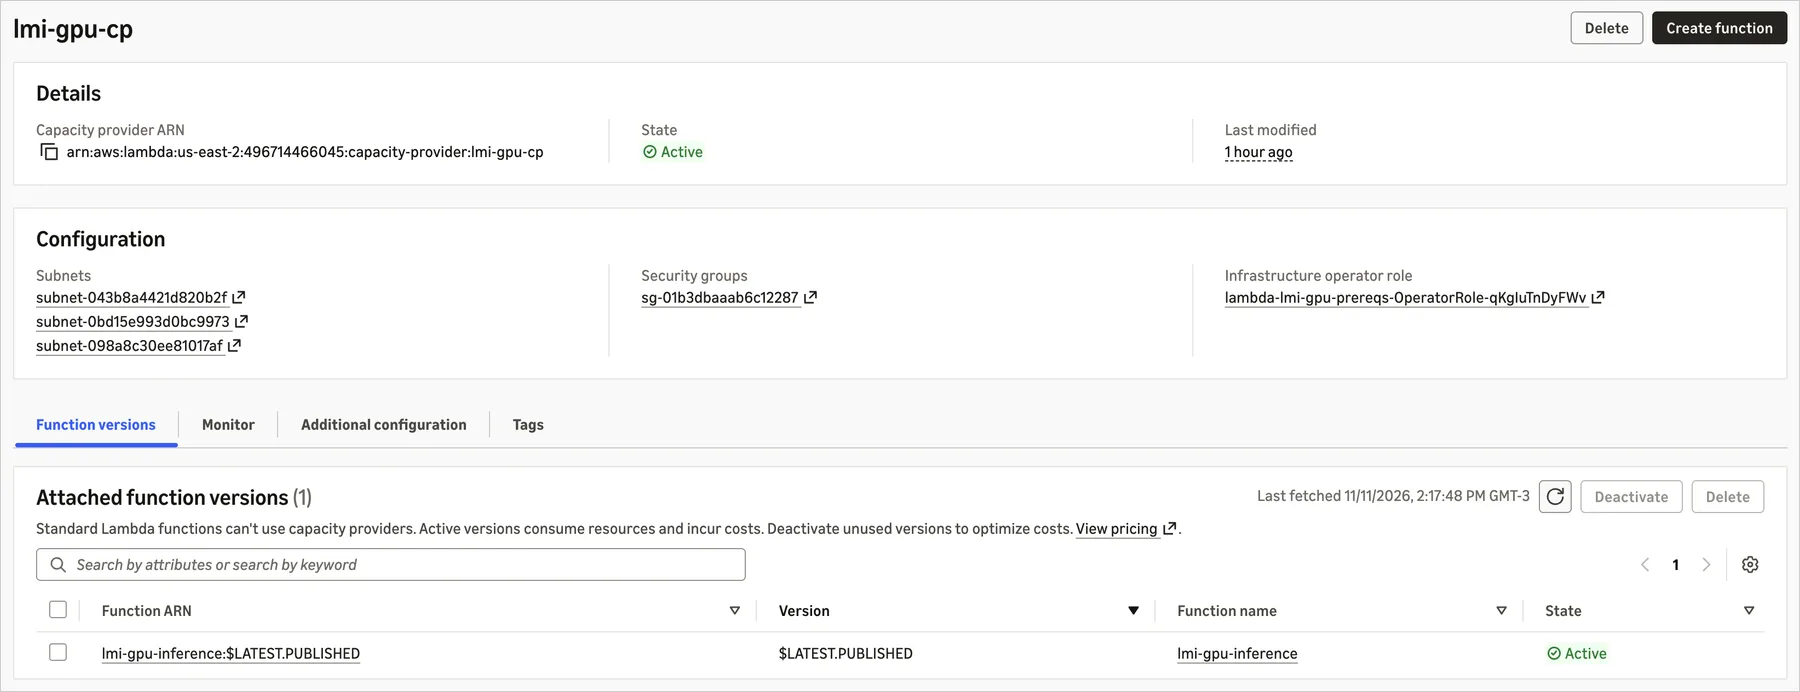
Empiezas con un proveedor de capacidad. En él nombras los tipos de instancia que Lambda puede usar, por ejemplo g5.2xlarge, g6.2xlarge y g6e.2xlarge, y ajustas cómo escala. Nombrar varios tipos no es decoración. Permite que Lambda elija primero una opción disponible más barata y pase a otra generación cuando la primera opción no tiene capacidad.
Luego construyes una imagen de contenedor. Las funciones GPU salen en imágenes de contenedor OCI, y AWS ofrece imágenes base preparadas para que no instales ni reconcilies tú mismo la pila de software GPU. Las imágenes que nombra AWS son base:cuda para el kit y el entorno CUDA, cupy:cuda para CuPy con NumPy, SciPy, Pandas y Numba, pytorch:cuda para PyTorch con torchvision, torchaudio, transformers y FFmpeg, y las imágenes de servicio vllm:cuda y sglang:cuda.
El ejemplo de lanzamiento muestra lo delgado que puede ser esto. Con la imagen base vLLM, todo el Dockerfile en el artículo de AWS cabe en una línea que nombra esa imagen base. Ajustas la variable de entorno MODEL_ID a un modelo en Hugging Face o ModelScope, a una ubicación en Amazon S3, o a una ruta local, y Lambda descarga el modelo, gestiona la memoria GPU, y sirve las solicitudes en el formato compatible con OpenAI que ofrece la imagen. AWS dice que esa ruta tomó cerca de 10 minutos en su ejemplo, la mayor parte sin atención mientras se aprovisionaba la capacidad y el modelo se calentaba.
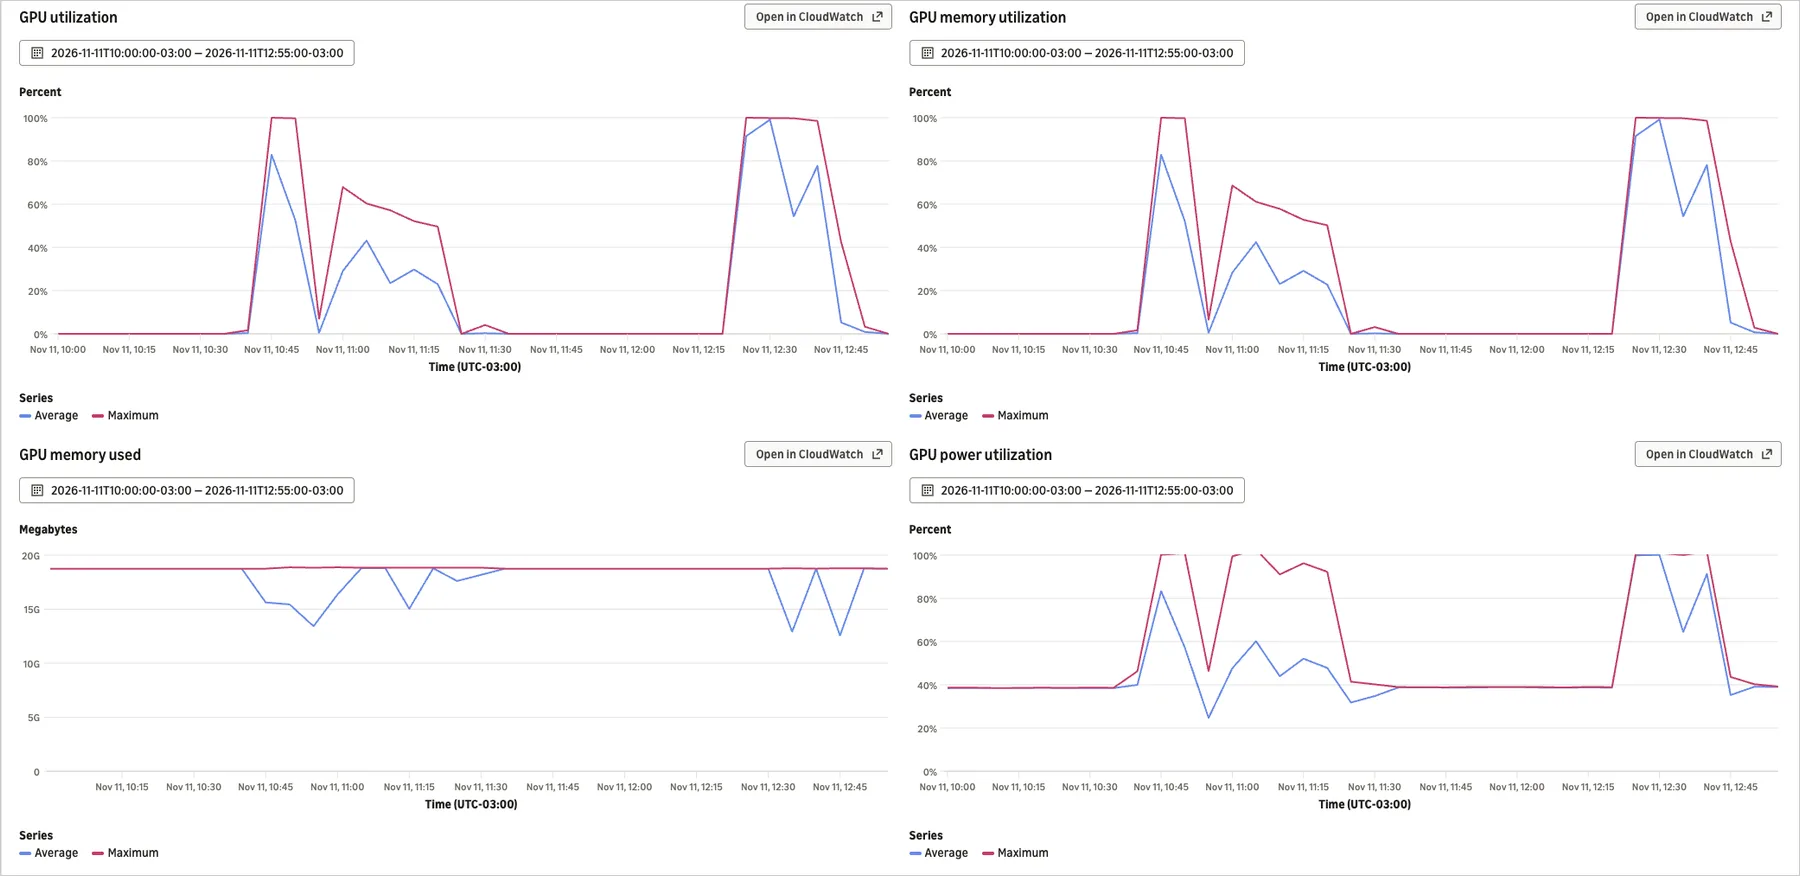
Dos ajustes dan forma a qué tan bien se usa la GPU. AcceleratorConfig ajusta AcceleratorMemorySize, la memoria mínima de acelerador que necesita la función, de 3 a 48 GB, y Lambda coloca el trabajo en la GPU disponible más pequeña que la cumple. PerExecutionEnvironmentMaxConcurrency ajusta cuántas solicitudes puede procesar a la vez un entorno de ejecución, hasta 48. En el ejemplo de AWS, cuatro invocaciones a la vez terminaron en cerca del mismo tiempo que una sola, porque el servidor vLLM las agrupó en una GPU que compartía una sola copia del modelo.
Las funciones se ejecutan desde una versión publicada, y ese momento ayuda. La publicación aprovisiona los entornos de ejecución, y cada uno descarga los pesos del modelo y calienta el motor antes de que la versión se active. El costo del arranque en frío cae en el momento de la publicación en lugar de caer sobre quien llama primero, aunque una versión nueva o un modelo nuevo aún necesita ese calentamiento.
Límites y plataformas
Datos verificados el 19 de noviembre de 2026 contra el artículo de lanzamiento de AWS y la página de precios de AWS Lambda.
Specifications
- Announced
- November 18, 2026, generally available at launch
- Instance families
- G4dn, G5, G6, G6f, Gr6, Gr6f, and G6e at launch, with more families promised
- Container image
- Up to 32 GB, with 10 GB per file
- Ephemeral storage
- Up to 32 GB of NVMe storage in /tmp
- Memory
- 2,048 to 32,768 MB
- Accelerator memory
- 3 to 48 GB requested per function
- Concurrency
- Up to 48 concurrent requests per execution environment
- Capacity
- Up to 15,000 vCPUs per capacity provider
- Timeout
- Up to 90 minutes for asynchronous and event source mapping invocations
| Familia | GPU nombrada en la cobertura de lanzamiento | Memoria de acelerador |
|---|---|---|
| G4dn | NVIDIA T4 | 16 GB |
| G5 | NVIDIA A10G | 24 GB |
| G6 y Gr6 | NVIDIA L4 | 24 GB |
| G6e | NVIDIA L40S | 48 GB |
La tabla cubre las familias que AWS y la cobertura de lanzamiento nombran con más frecuencia. La lista completa de lanzamiento también incluye las variantes G6f, Gr6f y Gr6, y la solicitud de la función en sí se expresa en memoria de acelerador en lugar de como una GPU nombrada, así que Lambda puede colocar el trabajo en una GPU más grande que el mínimo que pediste.
Las funciones GPU se activan desde las mismas fuentes de eventos que las demás funciones Event, entre ellas Amazon S3, Amazon SQS, Amazon API Gateway y Amazon EventBridge, con el mismo escalado, la misma gestión de errores y los mismos reintentos, y sin código de integración a medida. También se componen con el resto de Lambda. Las funciones durables pueden orquestar flujos más largos alrededor del paso GPU con puntos de control y recuperación, y las Lambda MicroVMs pueden ejecutar la lógica de herramientas en CPU y llamar a la función GPU solo para el paso de inferencia.
Precios
Hay tres partes en la factura de Managed Instances, y las funciones GPU usan la tarifa GPU para la del medio.
| Cargo | Tarifa para función GPU |
|---|---|
| Solicitudes | 0,20 dólares por millón de solicitudes |
| Tarifa de gestión | 9,75 por ciento sobre el precio EC2 para instancias GPU de la serie G |
| Instancias EC2 | Precio habitual de instancias EC2 para la capacidad que Lambda aprovisiona |
AWS señala que las funciones Managed Instances no pagan un cargo separado por la duración de ejecución de cada solicitud, a diferencia de las funciones Lambda por defecto. Los Savings Plans y las Reserved Instances pueden aplicar a la parte EC2 de la factura, y una reserva de capacidad EC2 On Demand que coincida con la configuración de tu proveedor de capacidad puede usarse para una disponibilidad GPU más predecible.
Esa estructura lleva una advertencia a la vista. Pagas por capacidad de instancia, así que una GPU en reposo cuesta dinero de la misma forma en que cuesta dinero una GPU en reposo que gestionas tú mismo. La tarifa de gestión compra la libertad frente a controladores, código de escalado y operaciones de parque. En un trabajo que funciona a pleno ritmo todo el día, esa tarifa es un porcentaje real sobre una factura grande de instancia. En un trabajo que llega en ráfagas, en eventos, o como un paso en una aplicación más amplia, evitar un parque GPU permanente puede valer más de lo que cuesta la tarifa.
Lo que funciona
- Sin controladores GPU, versiones CUDA, AMI, clústeres ni módulos de dispositivo que operar, con imágenes preparadas para PyTorch, vLLM y SGLang
- Las mismas fuentes de eventos, identidad, red y herramientas que el resto de Lambda, dentro de tu propia VPC
- Las solicitudes a la vez comparten una GPU y una copia del modelo, lo que eleva el uso en modelos pequeños
- El trabajo de arranque en frío ocurre cuando se publica una versión, no cuando llega quien llama primero, y los tiempos límite llegan a 90 minutos para trabajo asíncrono
Lo que no funciona
- Pagas por capacidad EC2 en lugar de solo por duración de solicitudes, así que el tiempo GPU en reposo igual cae en la factura, más una tarifa de gestión de 9,75 por ciento
- El alcance es inferencia y modelos a medida por diseño, no entrenamiento y no un reemplazo para grandes modelos fundacionales en Bedrock
- Las cuentas nuevas pueden necesitar un aumento de cuota antes de que la primera prueba pueda ejecutarse
- Los límites de contenedor, almacenamiento y memoria de acelerador ponen un techo al tamaño de modelo y trabajo que cabe en una función
Cuál deberías elegir
Elige Lambda GPU cuando el modelo es tuyo y el trabajo llega como un evento. Un clasificador ajustado, un modelo de visión, un modelo de voz, o un modelo de lenguaje pequeño que vive en una cadena de documentos o un flujo de agente es la forma para la que AWS construyó esto. La ganancia es que el paso GPU se une a la aplicación que ya tienes, con los mismos activadores y la misma historia de operaciones.
Elige Amazon Bedrock cuando el modelo es un modelo fundacional general. AWS hace esta elección por sí mismo. Si el modelo que quieres ya se sirve en Bedrock, ejecutar tu propia copia GPU de un modelo similar en Lambda suma trabajo sin sumar el control que necesitas.
Calcula el precio de un parque que gestionas tú mismo cuando el uso se mantiene alto todo el día. Si una GPU estará saturada día y noche, compara la factura completa de instancia más la tarifa de 9,75 por ciento contra el costo de ejecutar bien esa instancia por tu cuenta. La tarifa se justifica con más facilidad cuando reemplaza trabajo de parque que llega en ráfagas, de vez en cuando, o repartido entre muchas funciones pequeñas que pueden compartir capacidad.
Reflexiones finales
Durante años, la historia de Lambda se detenía en el punto exacto donde empiezan muchas aplicaciones de IA, porque la función podía orquestar un modelo pero nunca podía ser el modelo. Esa brecha ahora está cerrada para una parte definida y útil de trabajo: inferencia a medida, trabajos de medios, renderizado y simulación que se activan con eventos y viven dentro de una aplicación AWS. No reemplazará un clúster de entrenamiento ni un servicio de modelos fundacionales, y AWS no afirma que lo hará. Lo que hace es permitir que un equipo sume un paso GPU a una aplicación que ya ejecuta, sin abrir una segunda pila de infraestructura solo para sostener ese paso.
Fuentes
- Lanzamiento, alcance, límites, imágenes y ejemplo: AWS Lambda now supports GPU instances for Event Functions on Lambda Managed Instances, AWS News Blog, November 18, 2026
- Vista general de Managed Instances: AWS Lambda Managed Instances, AWS
- Capturas de pantalla de consola: AWS
FIN DE LA TRANSMISIÓN
Mantén la curiosidad. Cuestiónalo todo.