L’ordinateur le moins cher dans la plupart des foyers a déjà un processeur, environ un gigaoctet de RAM et un stockage flash qui reste inactif la majeure partie de la journée. smolmaxxing se demande quelle taille de modèle de langue ce matériel peut faire tourner, et répond à la question sur le matériel lui-même. Son résultat vedette est Ling-mini-2.0, un modèle de 16,3 milliards de paramètres, qui génère du texte à 5,1 tok/s sur un Xiaomi TV Box S 3e génération avec environ 1 Go de RAM utilisable. Le même modèle de 16B tourne aussi sur un iPad Air jailbreaké de 2013, avec environ 700 Mo de mémoire utilisable.
Rien de tout cela ne fonctionne de la façon normale. Le fichier du modèle Ling-mini-2.0 occupe près de 6 Go de mémoire flash sur le boîtier TV une fois son cache écrit. Ce qui le fait tourner, c’est un ensemble de correctifs qui ne gardent qu’une partie du modèle en mémoire à un moment donné et lisent le reste depuis la mémoire flash au fur et à mesure que chaque jeton en a besoin.
smolmaxxing
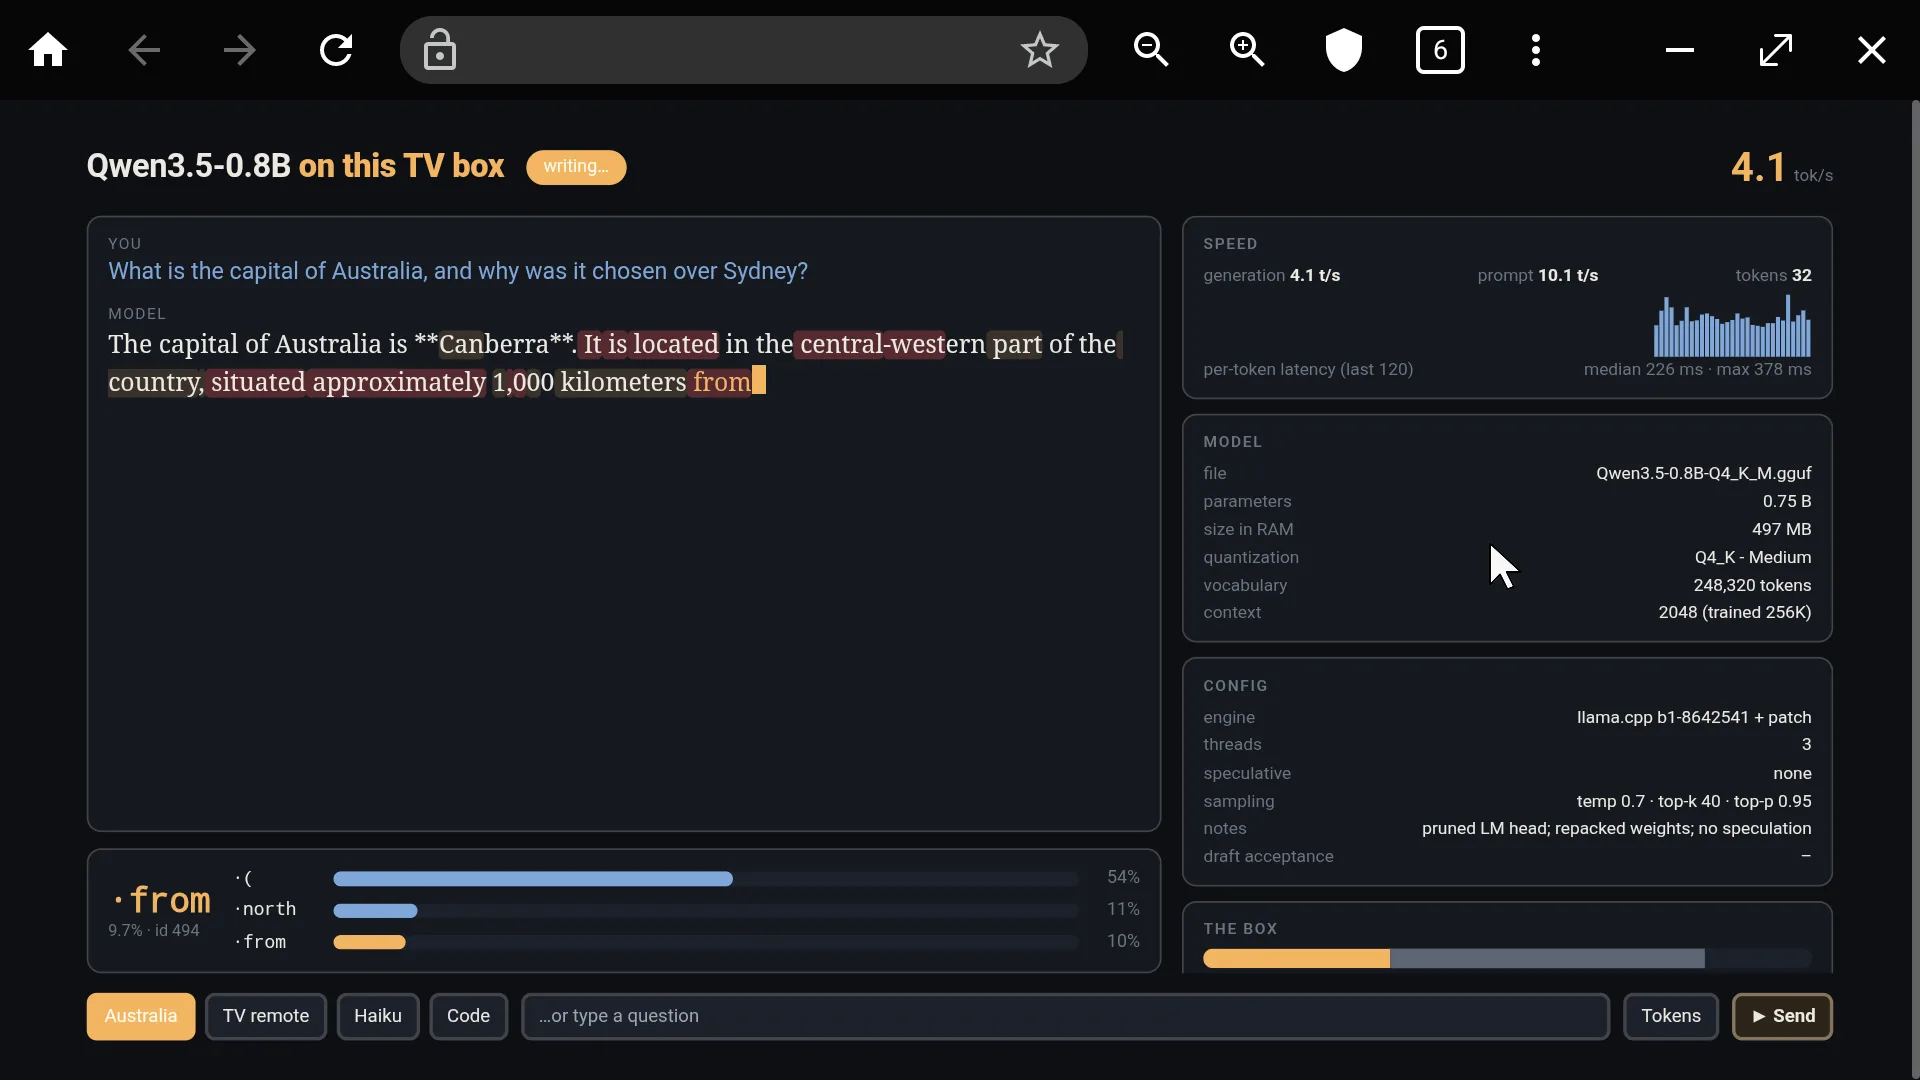
Site officielUn ensemble de correctifs et un carnet de laboratoire pour faire tourner le plus gros modèle de langue possible sur le plus petit matériel que vous possédez. Cas d’utilisation principal : inférence locale sur des boîtiers TV, de vieilles tablettes et des téléphones avec beaucoup plus de stockage flash que de RAM, où une version standard de llama.cpp ne peut pas charger le modèle ou avance au ralenti.
Caractéristiques clés : un système de pagination des experts qui garde les experts populaires en RAM et lit le reste depuis la mémoire flash à la demande; des noyaux écrits pour le Cortex-A55 et l’Apple A7, y compris un noyau à table de correspondance à 1 bit; des têtes de sortie élaguées qui retirent 0,2 à 0,5 Go d’un fichier de modèle; un moteur de diffusion en continu pour les modèles denses plus gros que la RAM; et des fichiers de modèles publiés avec des scripts de reconstruction.
Avantages : les chiffres sont inhabituellement honnêtes, mesurés sur chaque appareil avec des journaux bruts gardés dans le dépôt, et rien n’a besoin d’un réseau une fois les fichiers sur l’appareil. Limites : les fichiers de modèles ont besoin de la version corrigée; la voie iPad exige un jailbreak; et les réglages les plus rapides pour les plus gros modèles entraînent des coûts en qualité que le projet lui-même mesure.
Ce que c’est
smolmaxxing est un projet du compte GitHub hyperionaidev. Le dépôt a ouvert le 4 novembre 2026 et comptait 735 étoiles au moment de la vérification le 15 novembre. Ce n’est pas un produit et il ne se présente pas comme tel. Il contient des correctifs pour llama.cpp, des outils pour reconstruire les fichiers de modèles, des pages de discussion, des journaux de bancs d’essai pour chaque exécution, et un carnet qui consigne 165 expériences dans l’ordre, échecs inclus.
Trois appareils portent des résultats jusqu’à présent. Cet article porte sur les deux qui fonctionnent avec environ 1 Go de mémoire, parce que c’est là que se trouve l’ingénierie intéressante.
| Appareil | Puce | RAM utilisable | Système | Modèle quotidien | Plus gros modèle |
|---|---|---|---|---|---|
| Xiaomi TV Box S (3e génération) | Amlogic S7D, 4 cœurs Cortex-A55 | Environ 1 Go sur 1,9 Go | Android 14, sans root | Qwen3.5-2B à 7,7 tok/s | Ling-mini-2.0 à 5,1 tok/s |
| iPad Air (2013) | Apple A7, 2 cœurs | Environ 700 Mo sur 1 Go | iOS 12.5.7, jailbreaké | Bonsai-1.7B (1 bit) à 24 à 26 tok/s | Ling-mini-2.0 à 2,6 à 4,5 tok/s |
La gamme sur ces deux appareils va de stories260K, un modèle de 260K paramètres qui écrit de courtes histoires à environ 650 tok/s sur le boîtier TV, jusqu’à Ling-mini-2.0 à 16,3B. Un troisième appareil, un téléphone OnePlus Nord CE 2 de 2022 avec environ 3 Go de mémoire libre, joue dans une ligue supérieure, jusqu’à un modèle de 80B. Ses résultats sont couverts dans la section de choix ci-dessous.
Comment ça fonctionne
Les experts vivent sur la mémoire flash, pas en RAM
Un modèle à mélange d’experts contient de nombreux réseaux experts par couche et n’en utilise que quelques-uns pour chaque jeton. Ling-mini-2.0 compte 256 experts par couche à environ 1 Mo chacun, et un jeton sur le boîtier TV en utilise 8. La majeure partie du modèle est inactive à un moment donné, ce qui le rend mal adapté à la RAM et bien adapté à la mémoire flash.
Le système de pagination garde un bassin d’experts en RAM, 43 par couche pour Ling-mini-2.0 sur le boîtier TV, lit ceux qui manquent depuis la mémoire flash quand le routeur les demande, et précharge les experts que la couche suivante choisira probablement. Un petit bonus pour les experts déjà en RAM a réduit les manques de 13 pour cent à environ 2 pour cent, à un coût en qualité que le carnet mesure plutôt qu’il ne cache.
Les modèles denses ont plutôt un moteur de diffusion en continu. Il lit leurs poids à l’avance à la pleine vitesse de la mémoire flash, 278 Mo/s sur le boîtier TV, et libère chaque bloc juste après usage. Un modèle qui tire beaucoup d’octets de poids par jeton ne peut pas dépasser la mémoire flash d’où il les tire.
Des noyaux écrits pour des cœurs faibles
Le boîtier TV tourne sur des cœurs Cortex-A55 et l’iPad sur un Apple A7 sans instructions de produit scalaire, donc le correctif apporte des noyaux adaptés à chaque puce : un noyau à table de correspondance à 1 bit, des formats reconditionnés à 2 bits et ternaires, et des portages des mêmes idées vers le jeu d’instructions plus ancien de l’A7.
L’historique de l’iPad pour Bonsai-1.7B montre ce que ce travail vaut. Le même fichier de modèle tournait à 2,75 tok/s sur llama.cpp standard. Un noyau qui n’a besoin d’aucune multiplication, parce que les poids à 1 bit valent seulement plus ou moins un, l’a porté à 3,45, et le noyau à table de correspondance l’a porté à environ 11. La plus grande étape unique est venue d’une découverte : la tête de sortie, avec 151 669 rangées, n’avait jamais atteint le noyau rapide parce que son nombre de rangées n’est pas un multiple de 32, et elle passait 45 de chaque 72 ms par jeton sur la voie lente. Une fois la tête corrigée, le modèle a atteint 23,7 à 25,8 tok/s.
Moins de modèle à garder en RAM
Les petits modèles consacrent une part surprenante de leur taille au vocabulaire. Le correctif élague la tête de sortie jusqu’aux rangées que le texte réel utilise vraiment, entre environ 49K et 66K rangées, choisies selon la fréquence des jetons en anglais, en code et dans sept autres langues. L’économie est de 0,2 à 0,5 Go par modèle. Le coût est qu’environ 1 pour cent des jetons anglais tombent en dehors des rangées conservées et ne peuvent jamais être produits.
Cet élagage explique pourquoi les fichiers sont liés au correctif. llama.cpp standard ne peut pas charger les têtes élaguées. Les fichiers à mélange d’experts pour iPad sont encore plus étranges : le projet note qu’une autre version les chargera et produira des experts brouillés, ce qui est pire qu’un refus net.
Sur le boîtier TV, un mode appelé headless arrête le lanceur et les services Google pendant qu’un modèle tourne. La RAM libre passe d’environ 1 000 Mo à environ 1 300 Mo, la différence entre Bonsai-8B entièrement en RAM et un débordement vers la mémoire flash.
Les vitesses, et ce qu’elles coûtent
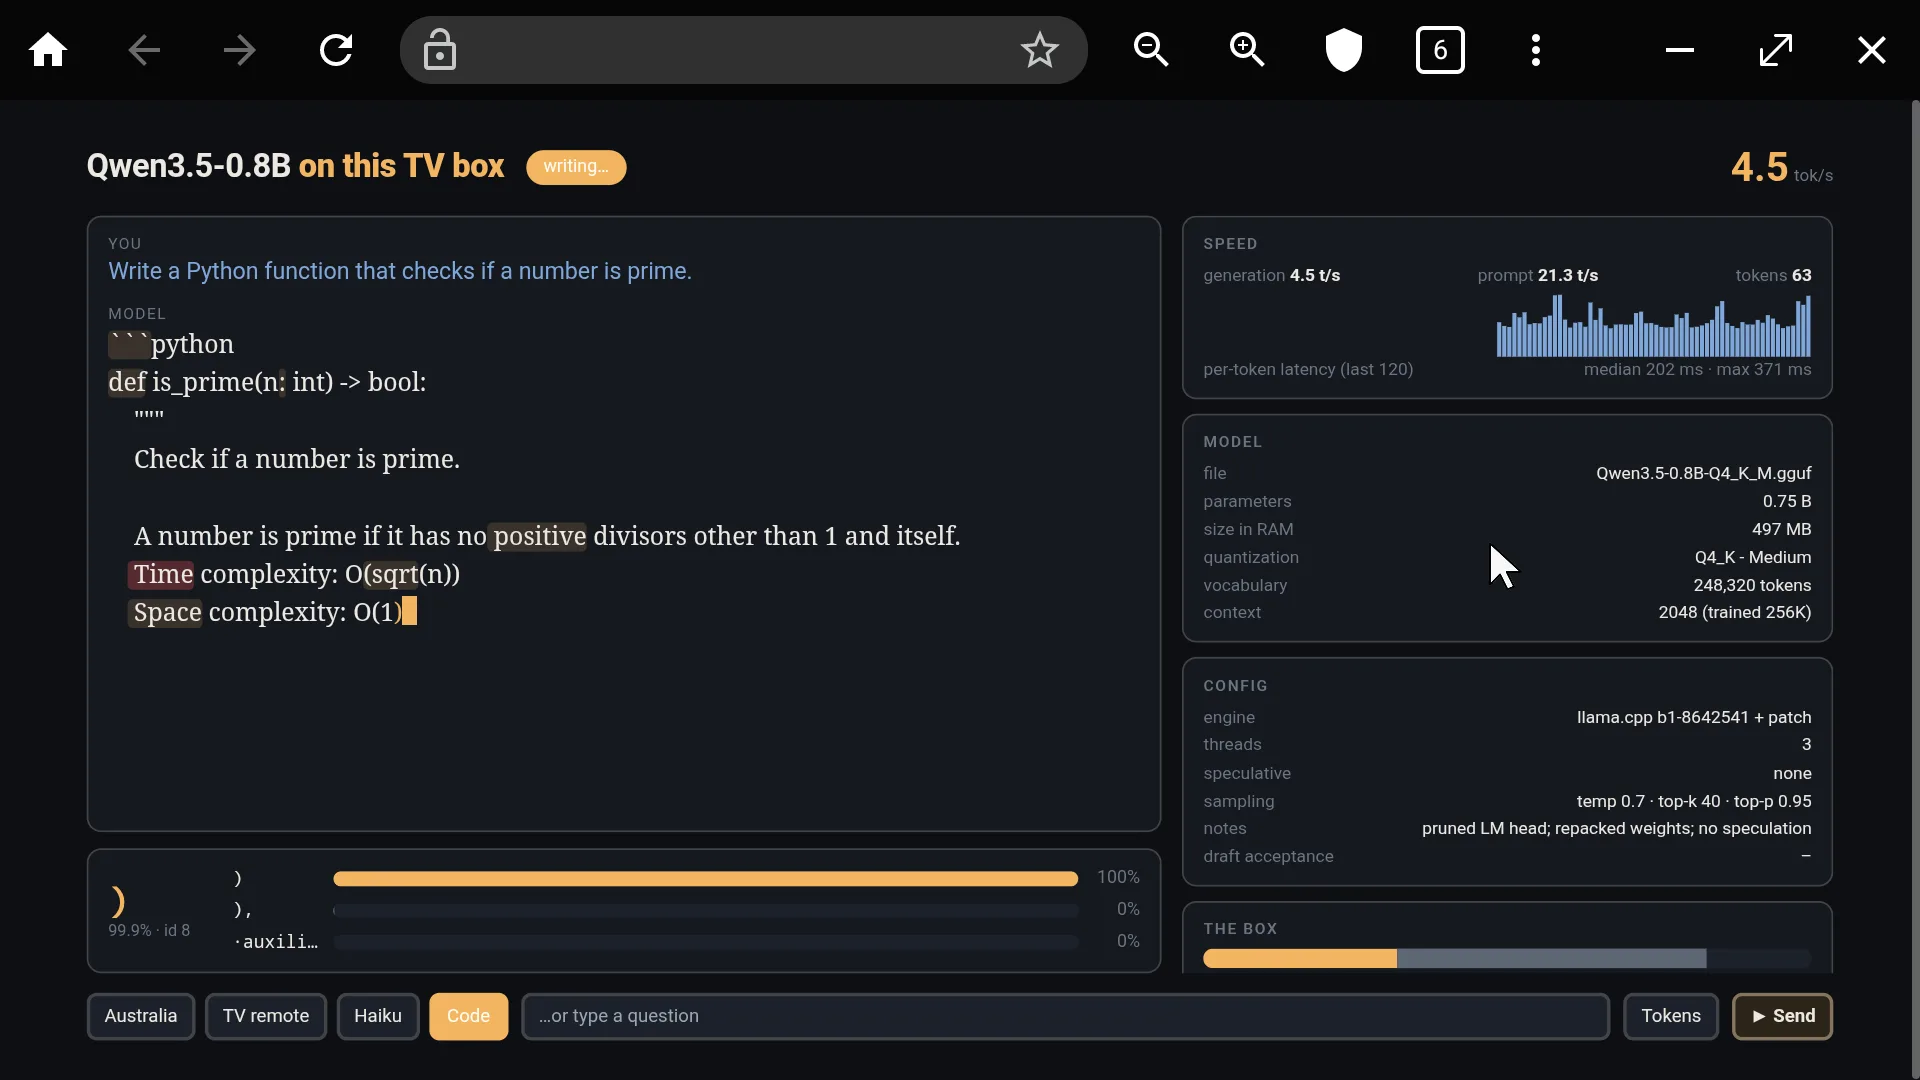
Tous ces chiffres sont les mesures du projet, prises sur les appareils par des demandes de discussion, et le dépôt avertit que le boîtier TV dérive d’environ 10 pour cent au cours d’une journée. Lisez-les comme un relevé soigné du projet, et non comme des résultats de laboratoire de ce magazine.
| Modèle | Boîtier TV | iPad Air |
|---|---|---|
| Ling-mini-2.0, mélange d’experts de 16,3B | 5,1 tok/s | 2,6 tok/s à pleine qualité, jusqu’à environ 4,5 avec biais de routage |
| Moon-Beam-8B-A1B, mélange d’experts de 8B | 7,2 tok/s | Environ 3,5 tok/s |
| Bonsai-8B, dense à 1 bit | 5,2 tok/s | 0,08 tok/s |
| Qwen3.5-9B, dense | 0,27 tok/s | Pas dans les résultats iPad |
Le motif dans ce tableau est la leçon du projet. Les modèles à mélange d’experts tournent à des vitesses utilisables parce que chaque jeton touche une petite partie des poids. Un modèle dense qui diffuse depuis la mémoire flash avance au ralenti, et sur l’iPad le Bonsai-8B dense est plus de quarante fois plus lent que son rival à mélange d’experts.
La vitesse au-delà d’un certain point s’achète avec la qualité, et le carnet évalue chaque réglage. Sur l’iPad, un biais de routage de 0,1 fait passer Ling-mini-2.0 de 2,6 à 3,3 tok/s à un coût de 2,6 pour cent en perplexité, la mesure du projet de la façon dont un modèle prédit un texte fixe. Faire tourner Moon-Beam-8B-A1B avec 4 experts par jeton au lieu de 8 atteint environ 5 tok/s sur l’iPad et coûte 27 pour cent.
Les longues réponses ont révélé un échec que la perplexité ne pouvait pas voir. Les experts à 2 bits obtenaient de bons scores un jeton à la fois et tombaient quand même dans des boucles après environ 250 à 300 mots, dans 12 réponses longues sur 13 lors d’un test du projet. Une pénalité de répétition de 1,15 sur 256 jetons a ramené ce chiffre à 1 sur 13.
Plus gros n’est pas mieux ici non plus. Ling-mini-2.0 fait deux fois la taille de Moon-Beam-8B-A1B, tourne plus lentement que lui sur le boîtier TV, et obtient de moins bons scores par octet sur les deux appareils. Le résultat de 16B prouve ce que le système de pagination peut transporter. Le modèle de 8B est la meilleure machine.
Où il montre ses limites
Les modèles quotidiens sont de petits modèles, avec un jugement de petit modèle. Les notes de l’iPad consignent Bonsai se trompant sur des faits simples, y compris en qualifiant Mercure de planète la plus proche de la Terre lors d’un test, même en répondant bien au test de trois questions du projet et en écrivant du code correct.
La voie iPad est fragile de façons que le dépôt énumère sans broncher. Un processus doit rester sous environ 700 Mo ou iOS commence à tuer des choses. Régler le bassin d’experts à 16 a causé une panique du noyau et un redémarrage pendant le travail du projet. Le jailbreak ne survit pas à un redémarrage, et le chien de garde de la mémoire d’iOS réinitialise même le serveur de discussion de 4B en quelques minutes, donc le modèle que le projet sert depuis l’iPad est celui de 1,7B.
Et il n’y a aucun polissage de produit nulle part là-dedans, par conception. Vous discutez dans un terminal ou dans une page web simple que l’appareil sert lui-même. L’installation, ce sont des scripts, des câbles et de la patience.
Ce qui fonctionne
- Un modèle de 16,3B tourne à un rythme utilisable de 5,1 tok/s sur un boîtier TV avec environ 1 Go de RAM utilisable
- Chaque chiffre a été mesuré sur l'appareil lui-même, avec des journaux bruts et des échecs gardés dans le carnet
- Gratuit et open source sous la licence MIT, avec des fichiers de modèles et des scripts de reconstruction publiés
- Les techniques voyagent au-delà d'un seul boîtier, comme le montrent les résultats sur téléphone avec des modèles de 35B et 80B
Ce qui ne fonctionne pas
- Les fichiers de modèles ont besoin de la version corrigée, et llama.cpp standard ne peut pas charger les têtes élaguées
- Les réglages les plus rapides pour les plus gros modèles entraînent des coûts en qualité mesurés en perplexité
- Les modèles denses plus gros que la RAM avancent au ralenti, à 0,27 tok/s pour un modèle de 9B sur le boîtier TV
- La voie iPad exige un jailbreak qui ne survit pas à un redémarrage, sur un appareil qui tue les processus au-delà d'environ 700 Mo
Lequel choisir
Choisissez la voie boîtier TV si vous avez un boîtier Android bon marché dans un tiroir. C’est le chemin le moins fragile du dépôt, il n’a besoin d’aucun root, et il vous donne deux modèles sensés : Qwen3.5-2B à 7,7 tok/s pour l’usage quotidien, et Ling-mini-2.0 quand vous voulez regarder un modèle de 16B travailler sur du matériel qui n’a aucune raison de le faire tourner.
Choisissez la voie iPad si la tablette de 2013 est l’appareil que vous avez et que vous acceptez les conditions du jailbreak. Bonsai-1.7B à 24 à 26 tok/s est la discussion quotidienne la plus rapide sur n’importe quel appareil de 1 Go dans les résultats du projet, et ce n’est pas serré.
Choisissez la voie téléphone si votre matériel a plus de mémoire. Sur le téléphone du projet, un OnePlus Nord CE 2 de 2022 avec environ 3 Go libres, Qwen3.6-35B-A3B tourne à 4,9 à 5,7 tok/s et Qwen3-Next-80B-A3B à 2,6 à 3,1 tok/s. Les fichiers de modèles pour téléphone sont des fichiers GGUF standard qui se chargent dans n’importe quelle version, même si les vitesses ont besoin du système de pagination du correctif.
Cherchez ailleurs si vous voulez des modèles locaux sur une machine avec de la vraie mémoire. Sur un ordinateur portable moderne, llama.cpp standard et un fichier de modèle normal seront plus rapides, plus simples et meilleurs, et notre couverture de Code local sur le Mac couvre ce bout de l’échelle.
Réflexions finales
Les modèles de cette histoire seront remplacés d’ici quelques mois. La partie durable de smolmaxxing est le relevé : 165 expériences, chacune mesurée sur l’appareil qu’elle prétend décrire, avec les boucles, les paniques et les mauvais tournants gardés dans le même fichier que les réussites.
Il laisse aussi une correction utile à la façon dont on parle du petit matériel. Au-delà d’une certaine taille, le plafond pour un modèle n’est pas son nombre de paramètres. Ce sont les octets qui doivent rester résidents, la vitesse de la mémoire flash derrière eux, et la part du modèle dont chaque jeton a vraiment besoin. Un boîtier TV ne peut pas faire tourner un modèle de 16B, jusqu’à ce que quelqu’un compte ces trois choses assez soigneusement. Alors il le peut.
Sources
- Aperçu, tableau des appareils, techniques et licence : dépôt smolmaxxing, hyperionaidev sur GitHub
- Résultats du boîtier TV, limites et tableau des scores : Appareil 1, Xiaomi TV Box S (3e génération), documentation smolmaxxing
- Résultats iPad, installation et notes d’échec : Appareil 2, iPad Air (2013), documentation smolmaxxing
- Noyaux, économies de mémoire, système de pagination des experts et diffusion en continu : Comment ça fonctionne, documentation smolmaxxing
- Téléchargements de modèles, tailles de fichiers et cibles de reconstruction : Modèles, documentation smolmaxxing
- Leçons, y compris ce qui n’a pas fonctionné : Leçons, documentation smolmaxxing
- Le relevé complet des expériences : EXPERIMENT.md, dépôt smolmaxxing
- Captures d’écran de la page de flux de jetons : projet smolmaxxing
- Illustration principale : Dirty Static, générée dans le style maison
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.