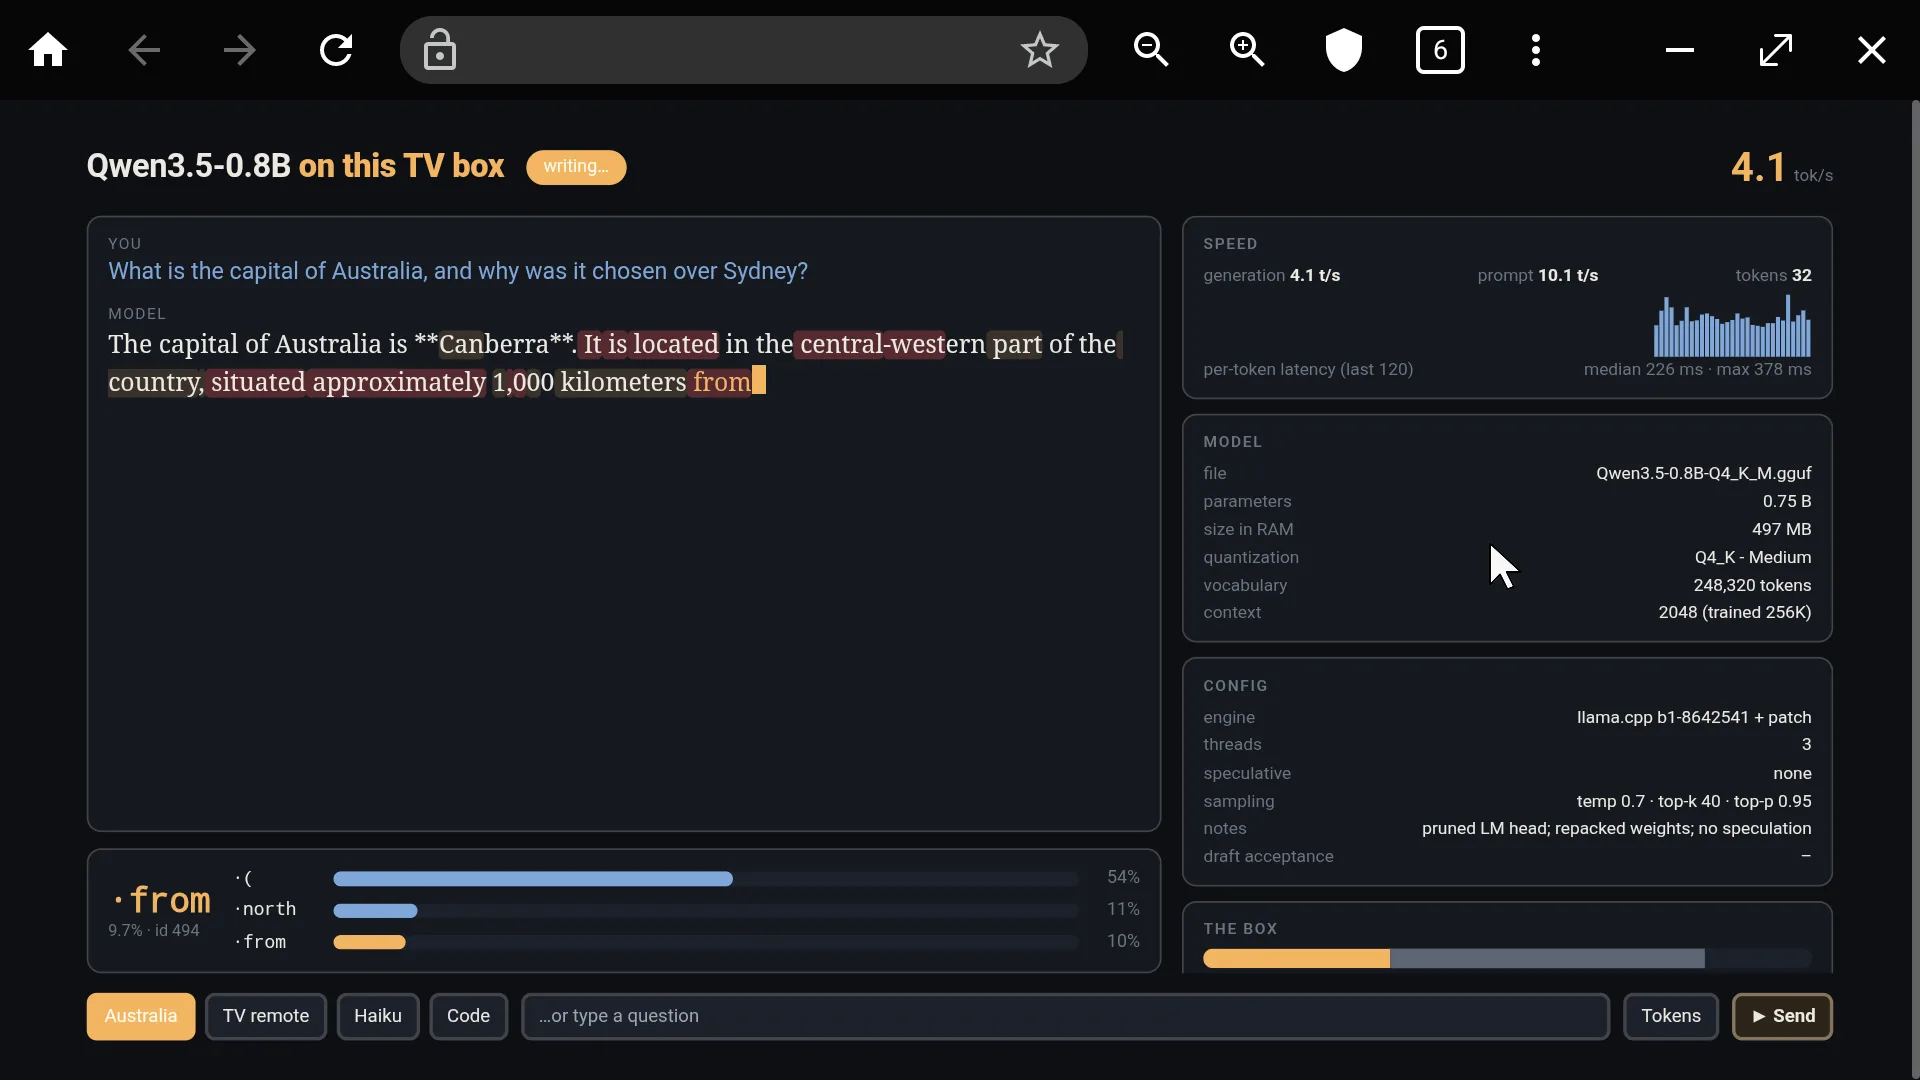
La computadora más barata en la mayoría de los hogares ya tiene una CPU, un gigabyte aproximadamente de RAM y almacenamiento flash que permanece inactivo la mayor parte del día. smolmaxxing se pregunta qué tan grande puede ser un modelo de lenguaje que ese hardware puede ejecutar, y responde la pregunta en el propio hardware. Su resultado principal es Ling-mini-2.0, un modelo con 16.3 mil millones de parámetros, que genera texto a 5.1 tok/s en un Xiaomi TV Box S de 3.ª generación con aproximadamente 1 GB de RAM utilizable. El mismo modelo de 16B también se ejecuta en un iPad Air de 2013 con jailbreak, con aproximadamente 700 MB de memoria utilizable.
Nada de eso funciona de la manera normal. El archivo del modelo para Ling-mini-2.0 ocupa cerca de 6 GB de memoria flash en el TV box una vez que se escribe su caché. Lo que lo hace funcionar es un conjunto de parches que mantienen solo una parte del modelo en memoria en un momento dado y leen el resto desde la memoria flash a medida que cada token lo necesita.
smolmaxxing
Sitio oficialUn conjunto de parches y un cuaderno de laboratorio para ejecutar el modelo de lenguaje más grande que puedas en el hardware más pequeño que tengas. Caso de uso principal: inferencia local en TV boxes, tabletas antiguas y teléfonos con mucho más almacenamiento flash que RAM, donde una compilación estándar de llama.cpp no puede cargar el modelo o funciona muy lento.
Características clave: un paginador de expertos que mantiene los expertos populares en RAM y lee el resto desde la memoria flash bajo demanda; núcleos escritos para el Cortex-A55 y el Apple A7, incluido un núcleo de tabla de búsqueda de 1 bit; cabezales de salida podados que reducen de 0.2 a 0.5 GB de un archivo de modelo; un motor de transmisión para modelos densos más grandes que la RAM; y archivos de modelos publicados con scripts de reconstrucción.
Ventajas: las cifras son inusualmente honestas, medidas en cada dispositivo con registros sin procesar guardados en el repositorio, y nada necesita una red una vez que los archivos están en el dispositivo. Limitaciones: los archivos de modelos necesitan la compilación parcheada; la ruta del iPad necesita jailbreak; y los ajustes más rápidos para los modelos más grandes conllevan costos en calidad que el propio proyecto mide.
Qué es
smolmaxxing es un proyecto de la cuenta de GitHub hyperionaidev. El repositorio se abrió el 4 de noviembre de 2026 y tenía 735 estrellas cuando se revisó el 15 de noviembre. No es un producto y no se presenta como tal. Contiene parches para llama.cpp, herramientas para reconstruir archivos de modelos, páginas de chat, registros de pruebas de rendimiento para cada ejecución, y un cuaderno que registra 165 experimentos en orden, incluidos los fallos.
Hasta ahora, tres dispositivos tienen resultados. Este artículo trata sobre los dos que funcionan con aproximadamente 1 GB de memoria, porque ahí es donde está la ingeniería interesante.
| Dispositivo | Chip | RAM utilizable | Sistema | Modelo diario | Modelo más grande |
|---|---|---|---|---|---|
| Xiaomi TV Box S (3.ª generación) | Amlogic S7D, 4 núcleos Cortex-A55 | Aproximadamente 1 GB de 1.9 GB | Android 14, sin root | Qwen3.5-2B a 7.7 tok/s | Ling-mini-2.0 a 5.1 tok/s |
| iPad Air (2013) | Apple A7, 2 núcleos | Aproximadamente 700 MB de 1 GB | iOS 12.5.7, con jailbreak | Bonsai-1.7B (1 bit) a 24 a 26 tok/s | Ling-mini-2.0 a 2.6 a 4.5 tok/s |
El rango en esos dos dispositivos va desde stories260K, un modelo de 260K parámetros que escribe historias cortas a aproximadamente 650 tok/s en el TV box, hasta el Ling-mini-2.0 de 16.3B. Un tercer dispositivo, un teléfono OnePlus Nord CE 2 de 2022 con aproximadamente 3 GB de memoria libre, juega en una liga mayor, hasta un modelo de 80B. Sus resultados se cubren en la sección de elección más abajo.
Cómo funciona
Los expertos viven en la memoria flash, no en la RAM
Un modelo de mezcla de expertos contiene muchas redes expertas por capa y usa solo unas pocas de ellas para cada token. Ling-mini-2.0 tiene 256 expertos por capa de aproximadamente 1 MB cada uno, y un token en el TV box usa 8 de ellos. La mayor parte del modelo está inactiva en un momento dado, lo que lo hace poco adecuado para la RAM y muy adecuado para la memoria flash.
El paginador mantiene un grupo de expertos en RAM, 43 por capa para Ling-mini-2.0 en el TV box, lee los que faltan desde la memoria flash cuando el enrutador los pide, y precarga los expertos que es probable que la siguiente capa elija. Un pequeño bono para los expertos que ya están en RAM redujo los fallos de 13 por ciento a aproximadamente 2 por ciento, con un costo en calidad que el cuaderno mide en lugar de ocultar.
Los modelos densos obtienen en cambio un motor de transmisión. Lee sus pesos por adelantado respecto al trabajo a la velocidad completa de la memoria flash, 278 MB/s en el TV box, y libera cada bloque justo después de usarlo. Un modelo que extrae muchos bytes de pesos por token no puede superar la velocidad de la memoria flash desde la que los extrae.
Núcleos escritos para núcleos débiles
El TV box funciona con núcleos Cortex-A55 y el iPad con un Apple A7 sin instrucciones de producto escalar, por lo que el parche incluye núcleos adaptados a cada chip: un núcleo de tabla de búsqueda de 1 bit, formatos reempaquetados de 2 bits y ternarios, y adaptaciones de las mismas ideas al conjunto de instrucciones más antiguo del A7.
El historial del iPad para Bonsai-1.7B muestra lo que vale ese trabajo. El mismo archivo de modelo funcionaba a 2.75 tok/s en llama.cpp estándar. Un núcleo que no necesita multiplicación, porque los pesos de 1 bit son solo más o menos uno, lo llevó a 3.45, y el núcleo de tabla de búsqueda lo llevó a aproximadamente 11. El paso individual más grande vino de un descubrimiento: el cabezal de salida, con 151,669 filas, nunca había llegado al núcleo rápido porque su número de filas no es múltiplo de 32, y estaba gastando 45 de cada 72 ms por token en la ruta lenta. Con el cabezal corregido, el modelo alcanzó de 23.7 a 25.8 tok/s.
Menos modelo para mantener en RAM
Los modelos pequeños dedican una parte sorprendente de su tamaño al vocabulario. El parche poda el cabezal de salida hasta las filas que el texto real realmente usa, entre aproximadamente 49K y 66K filas, elegidas por frecuencia de tokens en inglés, código y otros siete idiomas. El ahorro es de 0.2 a 0.5 GB por modelo. El costo es que aproximadamente 1 por ciento de los tokens en inglés quedan fuera de las filas conservadas y nunca pueden producirse.
Esa poda es la razón por la que los archivos están ligados al parche. llama.cpp estándar no puede cargar los cabezales podados. Los archivos de mezcla de expertos del iPad son aún más extraños: el proyecto señala que otra compilación los cargará y producirá expertos desordenados, lo cual es peor que una negativa clara.
En el TV box, un modo llamado headless detiene el lanzador y los servicios de Google mientras se ejecuta un modelo. La RAM libre aumenta de aproximadamente 1,000 MB a aproximadamente 1,300 MB, la diferencia entre que Bonsai-8B quepa por completo en RAM y que se desborde a la memoria flash.
Las velocidades, y lo que cuestan
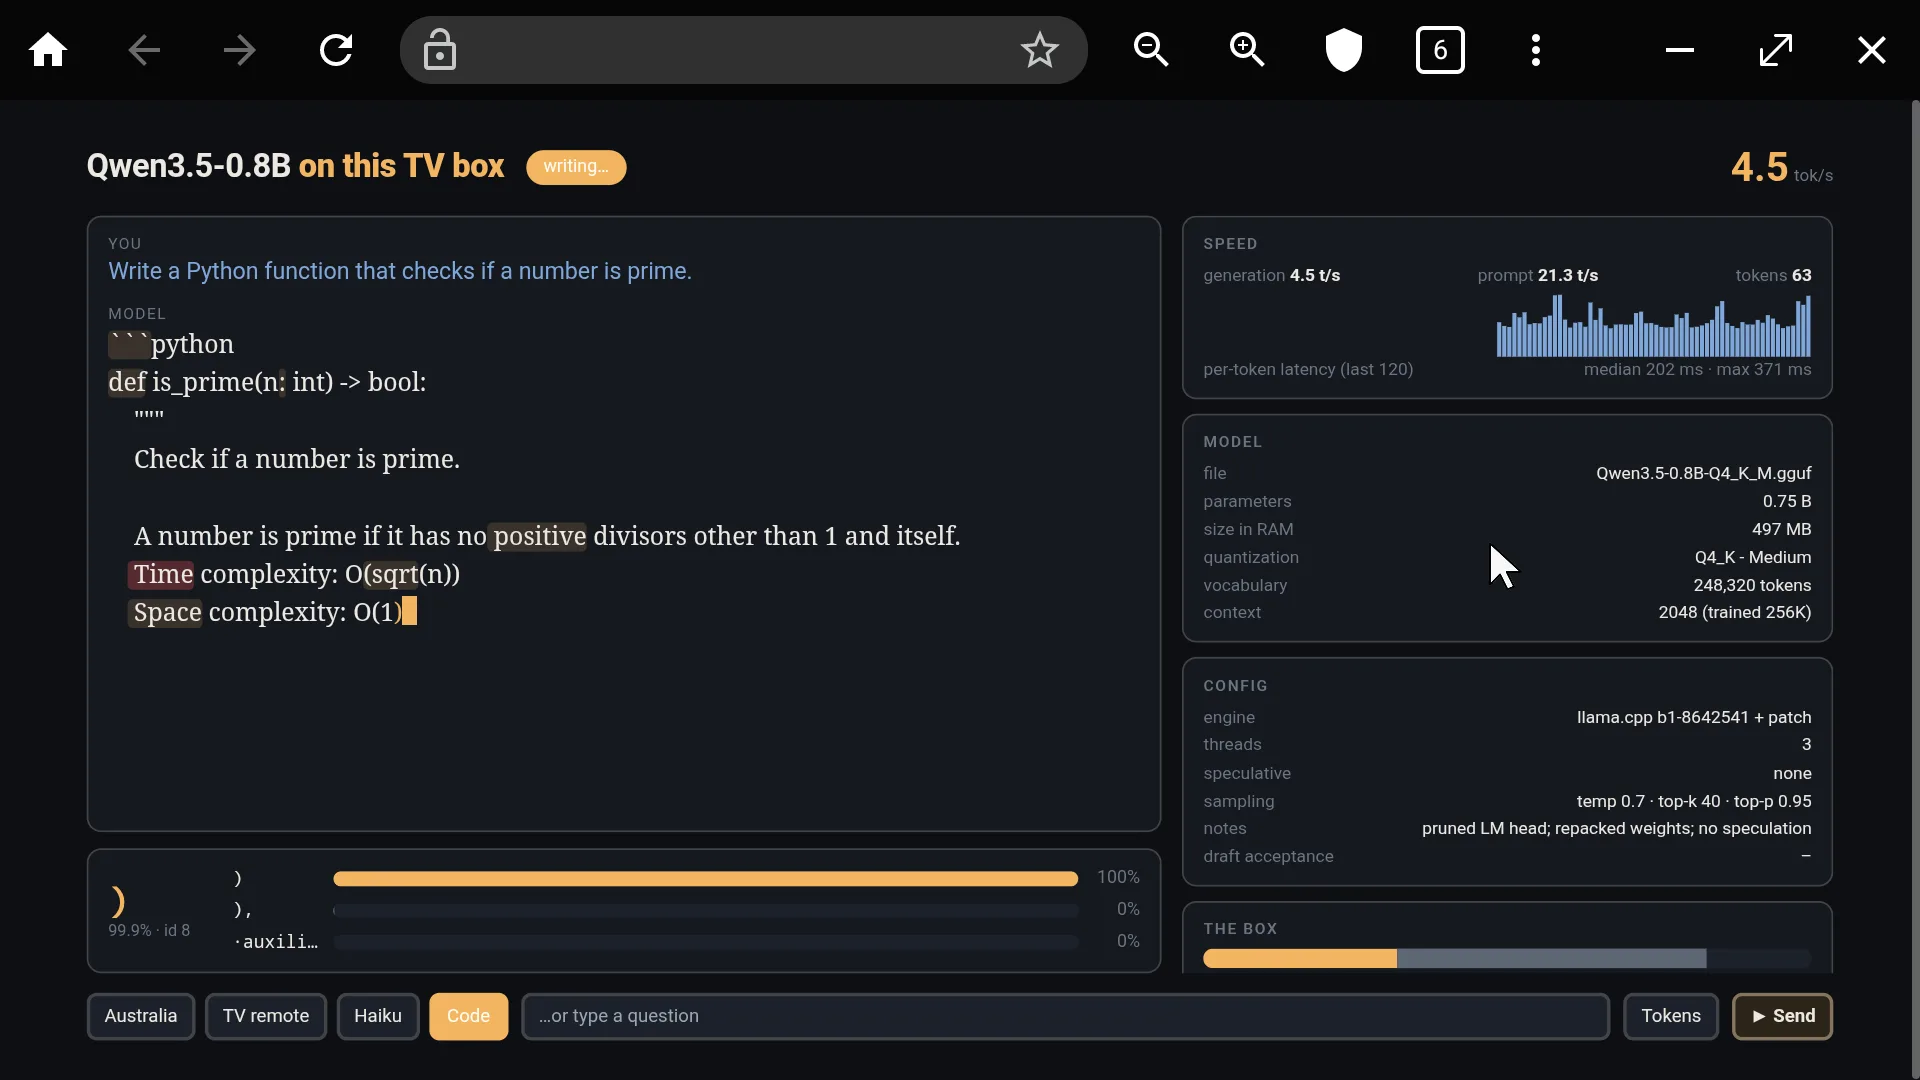
Todas estas cifras son mediciones del proyecto, tomadas en los dispositivos a través de solicitudes de chat, y el repositorio advierte que el TV box varía aproximadamente 10 por ciento a lo largo de un día. Léelas como un registro cuidadoso del proyecto, no como resultados de laboratorio de esta revista.
| Modelo | TV box | iPad Air |
|---|---|---|
| Ling-mini-2.0, mezcla de expertos de 16.3B | 5.1 tok/s | 2.6 tok/s con calidad completa, hasta aproximadamente 4.5 con sesgo de enrutamiento |
| Moon-Beam-8B-A1B, mezcla de expertos de 8B | 7.2 tok/s | Aproximadamente 3.5 tok/s |
| Bonsai-8B, denso de 1 bit | 5.2 tok/s | 0.08 tok/s |
| Qwen3.5-9B, denso | 0.27 tok/s | No está en los resultados del iPad |
El patrón en esa tabla es la lección del proyecto. Los modelos de mezcla de expertos funcionan a velocidades utilizables porque cada token toca una pequeña parte de los pesos. Un modelo denso que se transmite desde la memoria flash avanza muy lento, y en el iPad el Bonsai-8B denso es más de cuarenta veces más lento que su rival de mezcla de expertos.
La velocidad a partir de cierto punto se compra con calidad, y el cuaderno pone precio a cada ajuste. En el iPad, un sesgo de enrutamiento de 0.1 eleva Ling-mini-2.0 de 2.6 a 3.3 tok/s con un costo de 2.6 por ciento en perplejidad, la medida del proyecto de qué tan bien un modelo predice un texto fijo. Ejecutar Moon-Beam-8B-A1B con 4 expertos por token en lugar de 8 alcanza aproximadamente 5 tok/s en el iPad y cuesta 27 por ciento.
Las respuestas largas expusieron un fallo que la perplejidad no podía ver. Los expertos de 2 bits obtuvieron buenos puntajes token por token y aun así cayeron en bucles después de aproximadamente 250 a 300 palabras, en 12 de 13 respuestas largas en una prueba del proyecto. Una penalización por repetición de 1.15 en 256 tokens redujo eso a 1 en 13.
Más grande tampoco es mejor aquí. Ling-mini-2.0 es el doble de tamaño que Moon-Beam-8B-A1B, funciona más lento que él en el TV box, y obtiene peores puntajes por byte en ambos dispositivos. El resultado de 16B prueba lo que el paginador puede transportar. El modelo de 8B es la mejor máquina.
Dónde se queda corto
Los modelos de uso diario son modelos pequeños, con el criterio de modelos pequeños. Las notas del iPad registran que Bonsai se equivoca en datos simples, incluido llamar a Mercurio el planeta más cercano a la Tierra en una prueba, incluso mientras responde bien la prueba de tres preguntas del proyecto y escribe código correcto.
La ruta del iPad es frágil en formas que el repositorio enumera sin inmutarse. Un proceso tiene que mantenerse por debajo de aproximadamente 700 MB o iOS empieza a cerrar cosas. Configurar el grupo de expertos en 16 causó un pánico del núcleo y un reinicio durante el trabajo del proyecto. El jailbreak no sobrevive a un reinicio, y el vigilante de memoria de iOS reinicia incluso el servidor de chat de 4B en minutos, por lo que el modelo que el proyecto sirve desde el iPad es el de 1.7B.
Y no hay pulido de producto en ninguna parte de esto, por diseño. Chateas en una terminal o en una página web sencilla que el propio dispositivo sirve. La configuración es scripts, cables y paciencia.
Lo que funciona
- Un modelo de 16.3B funciona a unos utilizables 5.1 tok/s en un TV box con aproximadamente 1 GB de RAM utilizable
- Cada cifra se midió en el propio dispositivo, con registros sin procesar y fallos guardados en el cuaderno
- Gratuito y de código abierto bajo la Licencia MIT, con archivos de modelos y scripts de reconstrucción publicados
- Las técnicas viajan más allá de un solo dispositivo, como muestran los resultados en teléfonos con modelos de 35B y 80B
Lo que no funciona
- Los archivos de modelos necesitan la compilación parcheada, y llama.cpp estándar no puede cargar los cabezales podados
- Los ajustes más rápidos para los modelos más grandes conllevan costos en calidad medidos en perplejidad
- Los modelos densos más grandes que la RAM avanzan muy lento, a 0.27 tok/s para un modelo de 9B en el TV box
- La ruta del iPad necesita un jailbreak que no sobrevive a un reinicio, en un dispositivo que cierra procesos que superan aproximadamente 700 MB
Cuál deberías elegir
Elige la ruta del TV box si tienes un dispositivo Android barato en un cajón. Es la ruta menos frágil en el repositorio, no necesita root, y te da dos modelos sensatos: Qwen3.5-2B a 7.7 tok/s para uso diario, y Ling-mini-2.0 cuando quieres ver un modelo de 16B funcionar en hardware que no tiene ningún motivo para ejecutar uno.
Elige la ruta del iPad si la tableta de 2013 es el dispositivo que tienes y aceptas las condiciones del jailbreak. Bonsai-1.7B a 24 a 26 tok/s es el chat diario más rápido en cualquier dispositivo de 1 GB en los resultados del proyecto, y no está cerca.
Elige la ruta del teléfono si tu hardware tiene más memoria. En el teléfono del proyecto, un OnePlus Nord CE 2 de 2022 con aproximadamente 3 GB libres, Qwen3.6-35B-A3B funciona a 4.9 a 5.7 tok/s y Qwen3-Next-80B-A3B a 2.6 a 3.1 tok/s. Los archivos de modelos del teléfono son archivos GGUF estándar que se cargan en cualquier compilación, aunque las velocidades necesitan el paginador del parche.
Busca en otro lugar si quieres modelos locales en una máquina con memoria real. En una computadora portátil moderna, llama.cpp estándar y un archivo de modelo normal serán más rápidos, más simples y mejores, y nuestra cobertura de Código local en la Mac cubre ese extremo de la escala.
Reflexiones finales
Los modelos en esta historia serán reemplazados en meses. La parte duradera de smolmaxxing es el registro: 165 experimentos, cada uno medido en el dispositivo que dice describir, con los bucles, los pánicos y los giros equivocados guardados en el mismo archivo que los logros.
También deja una corrección útil a la forma en que se habla del hardware pequeño. Pasado cierto tamaño, el techo para un modelo no es su número de parámetros. Es los bytes que deben permanecer residentes, la velocidad de la memoria flash detrás de ellos, y cuánto del modelo necesita realmente cada token. Un TV box no puede ejecutar un modelo de 16B, hasta que alguien cuenta esas tres cosas con suficiente cuidado. Entonces sí puede.
Fuentes
- Resumen, tabla de dispositivos, técnicas y licencia: repositorio de smolmaxxing, hyperionaidev en GitHub
- Resultados del TV box, límites y tabla de puntajes: Dispositivo 1, Xiaomi TV Box S (3.ª generación), documentación de smolmaxxing
- Resultados del iPad, configuración y notas de fallos: Dispositivo 2, iPad Air (2013), documentación de smolmaxxing
- Núcleos, ahorros de memoria, paginador de expertos y transmisión: Cómo funciona, documentación de smolmaxxing
- Descargas de modelos, tamaños de archivos y objetivos de reconstrucción: Modelos, documentación de smolmaxxing
- Lecciones, incluido lo que no funcionó: Lecciones, documentación de smolmaxxing
- El registro completo de experimentos: EXPERIMENT.md, repositorio de smolmaxxing
- Capturas de pantalla de la página de transmisión de tokens: proyecto smolmaxxing
- Ilustración principal: Dirty Static, generada en estilo interno
FIN DE LA TRANSMISIÓN
Mantén la curiosidad. Cuestiónalo todo.