Demandez à un agent de codage général de réviser un gros changement et trois échecs reviennent sans cesse. Il révise certains fichiers et en saute d’autres en silence. Il signale un vrai défaut mais pose le commentaire à la mauvaise ligne. Et sa qualité varie quand quelqu’un modifie le texte qui le guide, si bien que le même outil semble vif une semaine et brouillon la suivante.
Open Code Review, un outil en ligne de commande d’Alibaba qui se lance avec ocr, est construit autour d’un refus de tenir ces échecs pour normaux. Les étapes qui ne doivent pas mal tourner roulent dans du code ordinaire, avec des règles dures. Le modèle garde le seul travail où il est vraiment bon : lire le code dans son contexte et juger si quelque chose cloche.
Open Code Review
Site officielUn outil de révision de code par IA né comme assistant de révision interne chez Alibaba Group. Cas d’usage principal : réviser des changements Git et des fichiers entiers avec des commentaires posés sur des lignes exactes, dans un terminal, en intégration continue ou dans un agent de codage déjà en place.
Fonctions clés : choix et filtrage précis des fichiers dans le code; regroupement intelligent qui rassemble les fichiers liés en une unité de révision, chaque groupe étant traité par un sous agent en contexte isolé; association des règles par gabarit, avec un jeu de règles inclus qui couvre des classes de défauts comme les fautes de pointeur nul, les fautes de sécurité des fils d’exécution, le XSS et l’injection SQL; modules distincts de positionnement et de réflexion qui vérifient où les commentaires se posent et ce qu’ils disent; un mode balayage pour les fichiers entiers; et une sortie structurée, dont le JSON.
Avantages : le processus de révision est stable par construction, l’outil fonctionne avec des points d’accès compatibles OpenAI et Anthropic, et le projet publie son jeu de données de banc au grand jour. Limites : le rappel est plus bas qu’un agent général par choix, chaque chiffre vedette du banc vient du projet lui même, et vous payez encore les coûts de modèle à chaque révision sauf en délégation.
Ce que c’est
Open Code Review est écrit en Go et s’installe avec une commande npm, avec un script d’installation, des binaires de version et une compilation depuis la source comme autres routes. Il exige Git 2.41 ou plus récent, parce que Git fournit les diffs, la recherche de code et les opérations de dépôt dont l’outil a besoin.
Le projet dit que l’outil a servi d’assistant officiel de révision par IA chez Alibaba Group pendant deux ans avant sa sortie en libre, au service de dizaines de milliers de développeurs et trouvant des millions de défauts. Prenez ces chiffres comme le récit du projet sur sa propre histoire interne. Ils expliquent pourquoi la conception a cette forme, et ils ne peuvent pas se vérifier hors d’Alibaba.
Au quotidien, la forme est simple. Lancez l’outil dans un dépôt et il lit le diff, détermine quels fichiers changés méritent une révision et rend des commentaires structurés liés à des lignes précises. L’agent derrière ces commentaires peut lire un fichier entier, chercher dans la base de code et inspecter d’autres fichiers changés, si bien qu’un commentaire peut reposer sur un contexte hors du diff lui même. Cela compte, parce que bien des défauts réels ne ressemblent à des défauts que quand on voit l’appelant, le fichier frère ou la seconde moitié d’un changement.
L’hybride est tout l’argument
La plupart des outils de révision par IA sont un texte de guidage avec une ceinture d’outils. Open Code Review partage le travail en deux couches et dit clairement quelle couche possède quel travail.
La couche déterministe possède les étapes qui ne doivent pas dériver. Elle décide exactement quels fichiers ont besoin d’une révision et lesquels sont filtrés. Elle regroupe les fichiers liés en une seule unité de révision; l’exemple du projet associe message_en.properties et message_zh.properties, deux fichiers de langue qui appartiennent à la même révision. Elle associe les règles à chaque fichier par un moteur de gabarits plutôt que par de la prose dans un texte de guidage. Et après l’écriture du modèle, des modules distincts traitent le positionnement et la réflexion des commentaires, en vérifiant le lieu et le contenu de chaque commentaire avant qu’il vous arrive.
Chaque groupe roule ensuite comme un sous agent en contexte isolé. Un très gros changement se divise en unités qui peuvent être révisées en même temps, et un fichier immense ne peut pas pousser le reste du changement hors de la fenêtre. C’est la réponse directe au problème du fichier sauté : la couverture est décidée par du code qui compte les fichiers, pas par un modèle qui se fatigue.
La couche agent possède le jugement. Ses textes de guidage sont réglés pour le travail de révision, et son jeu d’outils a été distillé, selon le projet, à partir de traces d’appels d’outils dans des données de production à grande échelle : la fréquence de chaque outil, la fréquence des appels répétés et l’effet des nouveaux outils sur la chaîne. Dire si ce réglage est aussi fort qu’annoncé est difficile à tester de l’extérieur, mais la direction est saine. Un outil bâti pour un seul travail devrait mieux se comporter qu’un outil général à qui on confie ce travail après coup.
Notre portrait de Kilo Desktop faisait un point semblable sur les établis de travail. La valeur durable se trouve dans la structure autour du modèle. Open Code Review applique cette idée à la révision : gardez le modèle, disciplinez tout ce qui l’entoure.
Ce que le banc montre, et ce qu’il ne montre pas
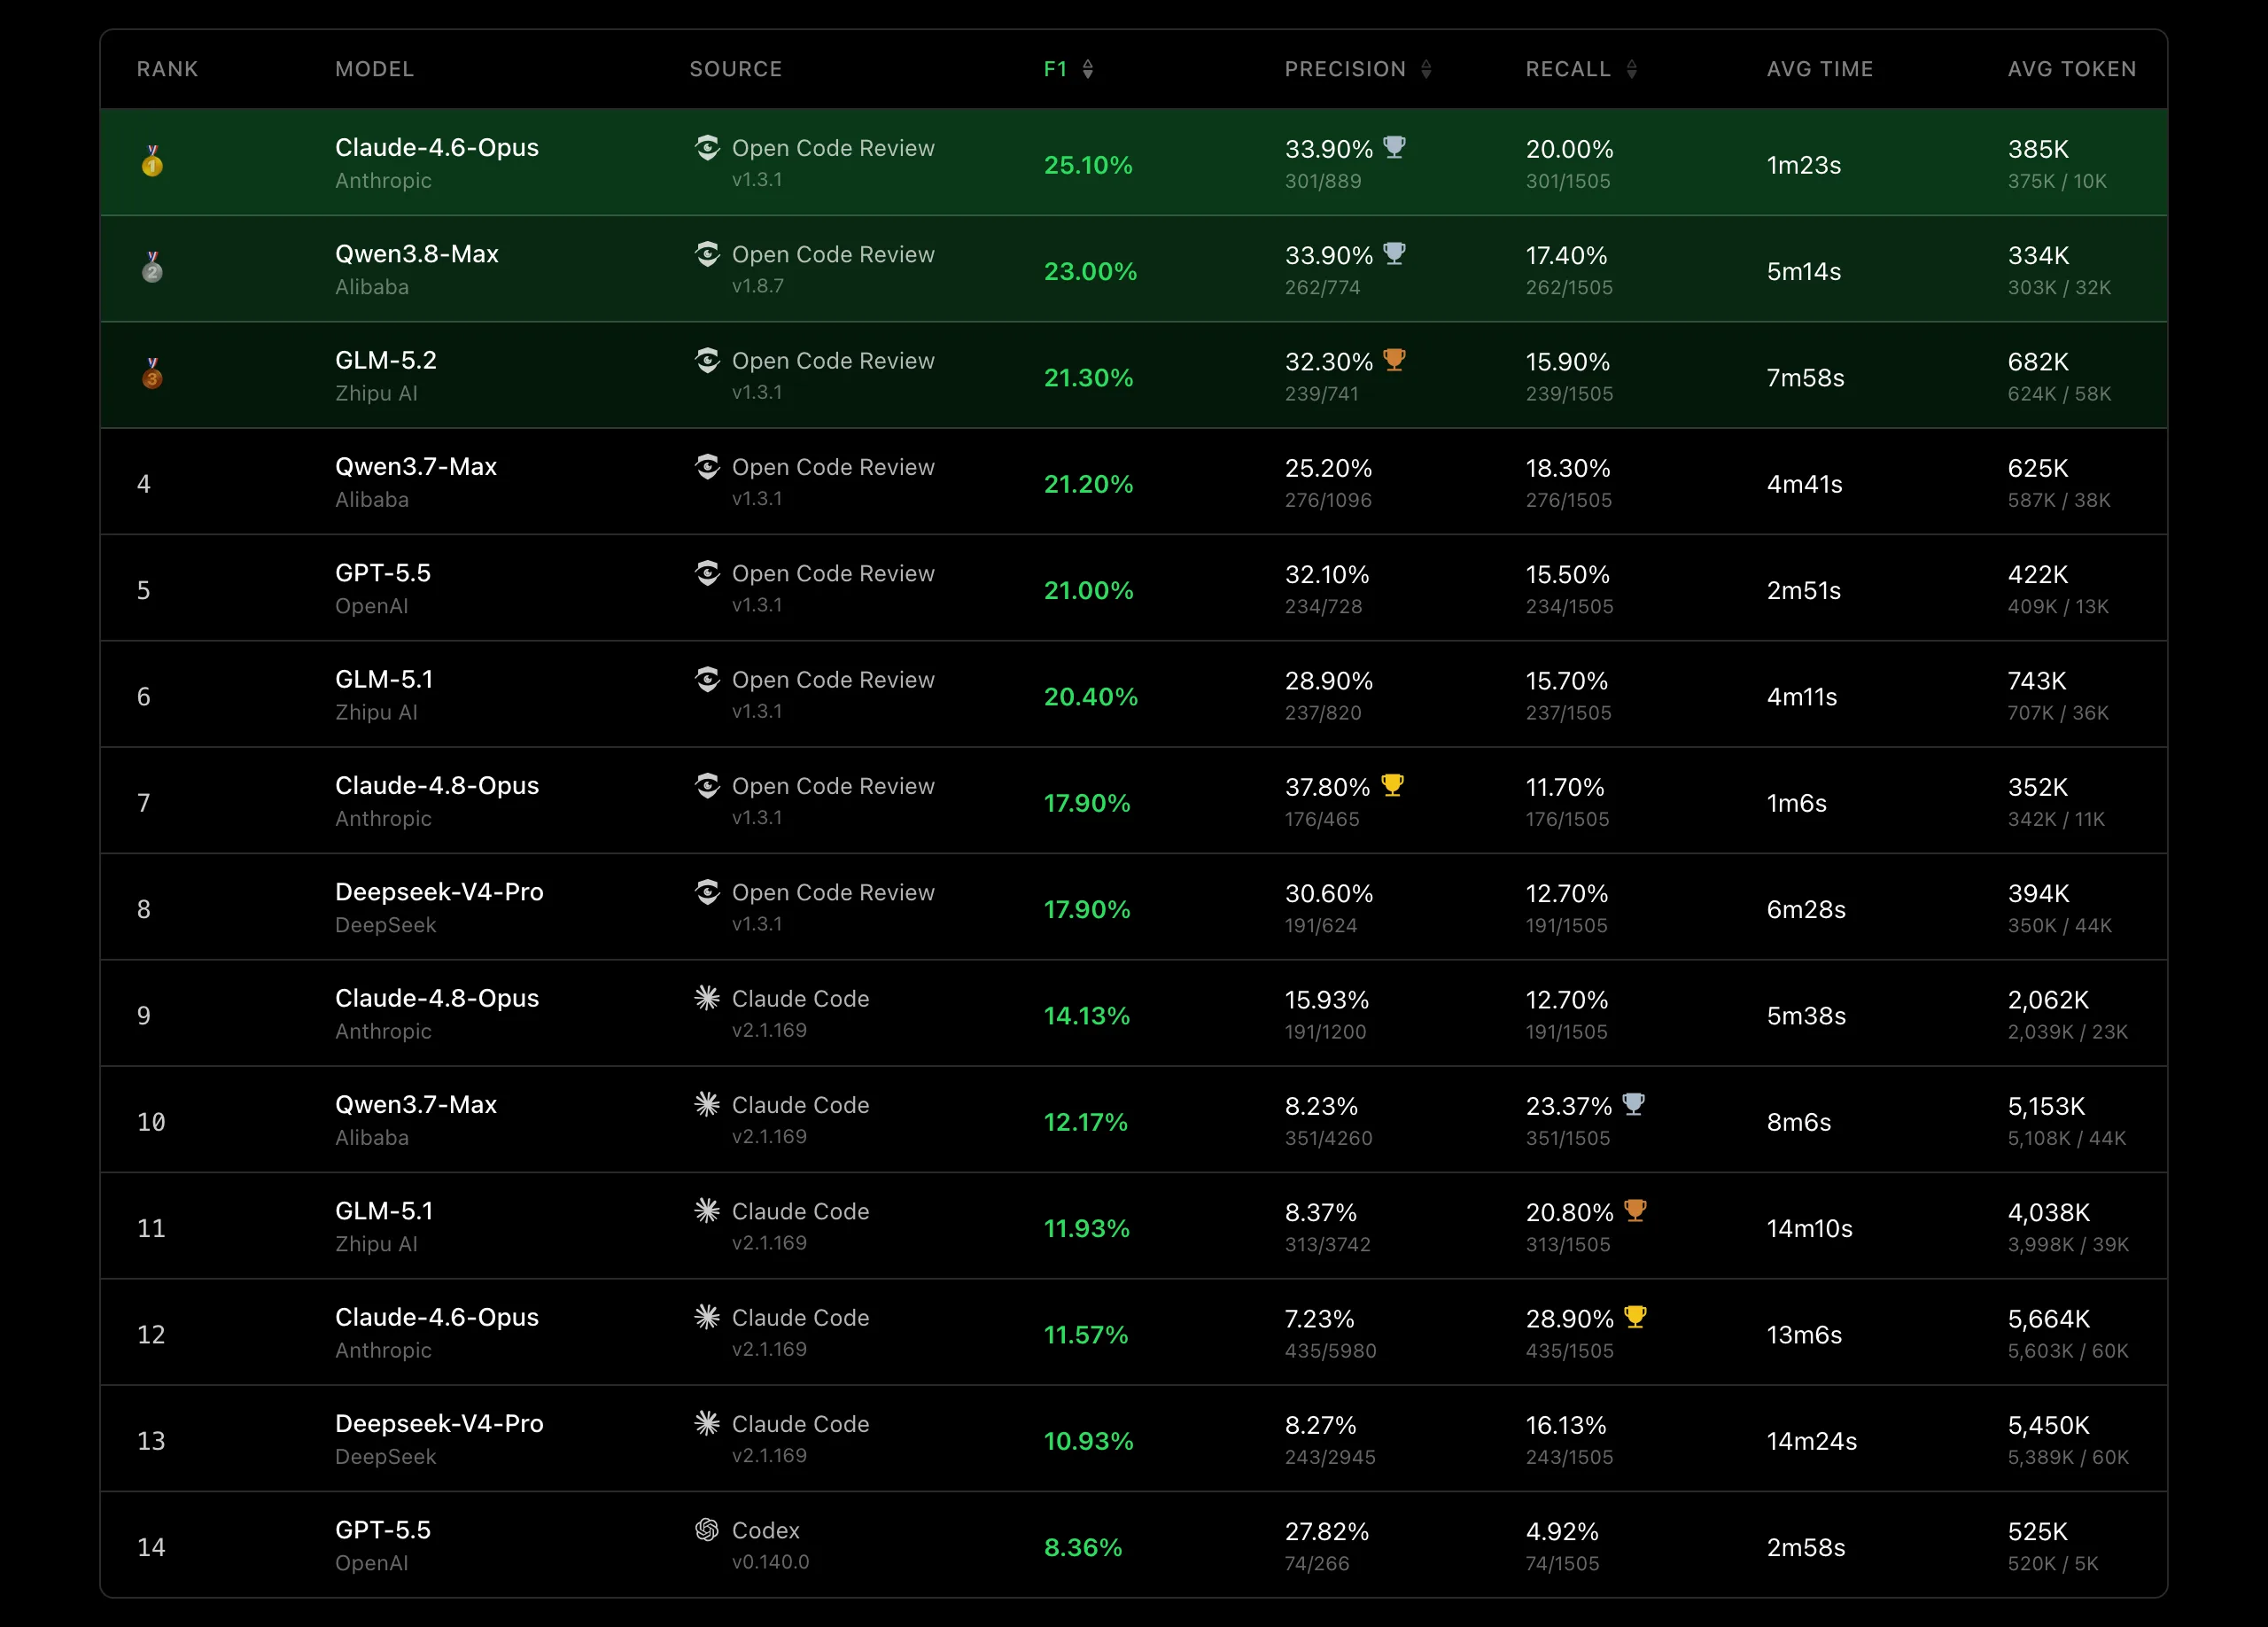
Le projet a bâti son propre banc pour appuyer la conception, nommé AACR-Bench. Il tient 200 demandes de fusion réelles venues de 50 dépôts libres populaires, dans 10 langages de programmation, avec 1 505 problèmes de vérité terrain validés en croisé par plus de 80 ingénieurs seniors. Le jeu de données est publié sur Hugging Face, si bien que chacun peut inspecter ce qui a été mesuré.
Face à un agent général, Claude Code, avec le même modèle sous jacent, le projet annonce une précision et un score F1 nettement plus élevés, des révisions plus rapides et un usage de jetons d’environ un neuvième du passage de l’agent général. La précision est la part des problèmes signalés qui sont de vrais défauts. Le score F1 équilibre la précision face au rappel. Le rappel est la part des vrais défauts qu’un outil trouve, et ici Open Code Review marque plus bas, ce que le projet appelle un échange délibéré : moins de fausses alarmes, au prix de trouver moins des vrais problèmes d’un changement.
Jetons par révision, échelle relative
Usage relatif des jetons annoncé par le projet sur AACR-Bench, même modèle sous jacent. Chiffres du projet, vérifiés le 15 novembre 2026.
Des modes pour le terminal, l’agent et le pipeline
Le mode par défaut révise un changement. Le mode espace de travail couvre le travail indexé, non indexé et non suivi. Un mode par plage de branches révise ce qu’une branche a changé depuis sa séparation de sa base, et un mode par commit révise un seul commit. Les sessions peuvent se lister et se reprendre, ce qui compte quand une grosse révision est coupée en plein cours.
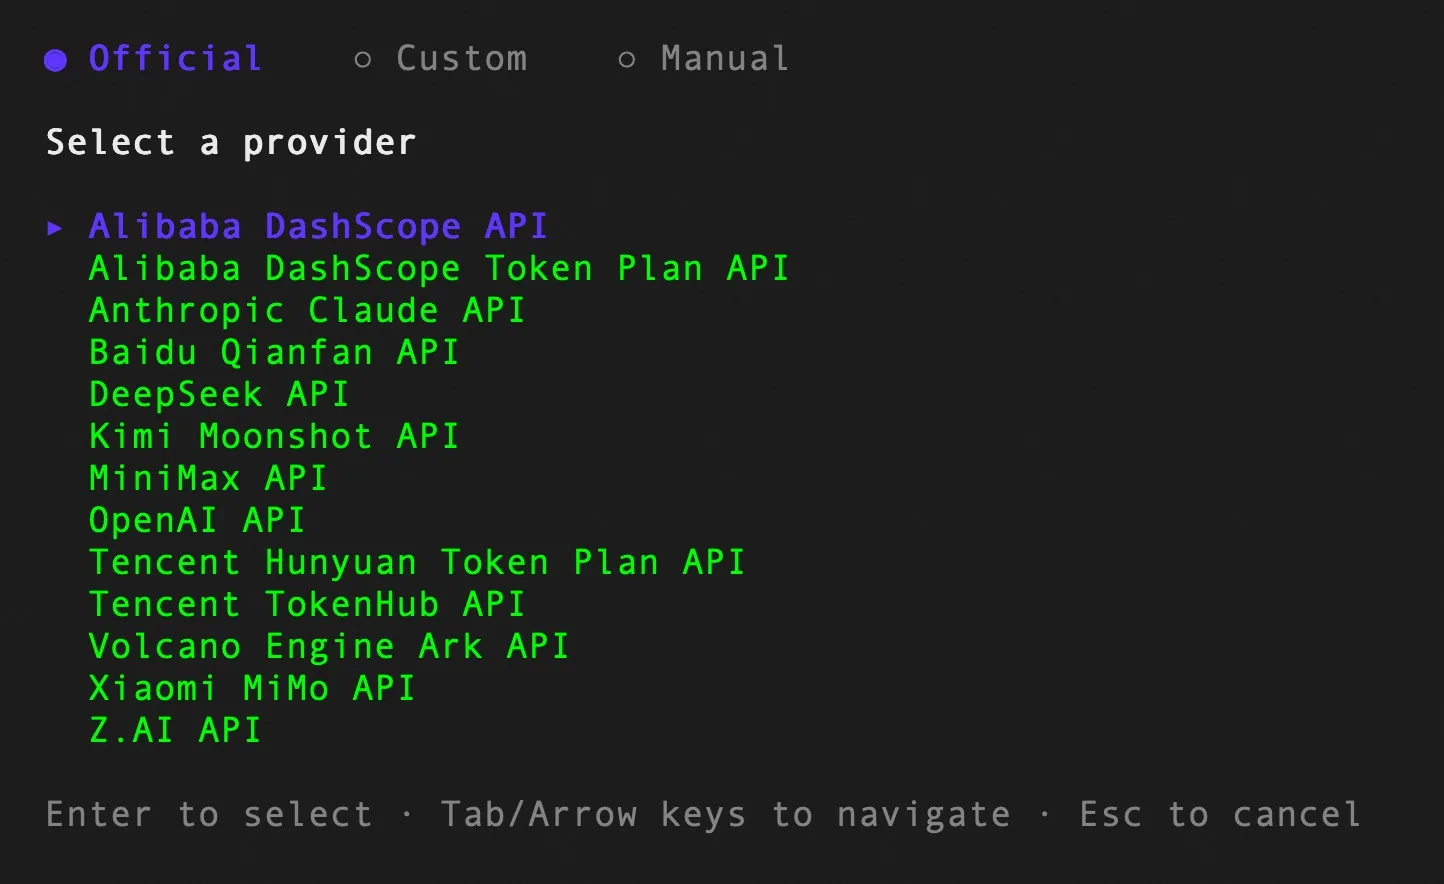
npm install -g @alibaba-group/open-code-review
ocr config provider
ocr config model
ocr review
ocr review --from main --to feature-branch
ocr scan --path internal/agent
Le mode balayage laisse tomber le diff et révise des fichiers entiers. C’est le mode pour une base de code inconnue, un audit d’un dossier ou un dépôt où l’historique des changements ne dit rien d’utile. Les résultats peuvent se sauver en JSON, la forme sur laquelle un agent hôte ou un travail d’intégration continue peut agir sans gratter du texte de terminal.
Le mode délégation est l’autre route d’entrée. Au lieu de configurer un modèle dans l’outil, vous laissez votre agent de codage faire la révision avec son propre modèle, pendant qu’Open Code Review fournit le choix des fichiers et les règles. Aucune clé distincte pour l’outil n’est requise dans ce mode. Des modules et des compétences portent l’outil dans Claude Code, Codex, Cursor, Kimi Code et OpenCode, et la documentation couvre des recettes d’intégration continue pour GitHub Actions, GitLab CI, GitFlic CI et Gerrit. Un visionneur de session permet de parcourir et de rejouer les révisions dans un navigateur et de marquer les commentaires comme corrigés ou ignorés, et les crochets de télémétrie suivent la norme OpenTelemetry.
Cet éventail de points d’entrée est la force pratique du projet. Un développeur solo peut le lancer dans un terminal avant un envoi. Une équipe peut l’épingler en intégration continue pour que chaque demande de fusion reçoive le même premier passage. Une équipe déjà fixée sur un agent de codage peut déléguer, garder son compte de modèle et gagner le choix des fichiers et la discipline des règles. Notre tutoriel sur faire rouler plusieurs agents de codage côte à côte couvre pourquoi ce genre de structure partagée compte quand l’usage des agents cesse d’être une nouveauté.
Ce qui fonctionne
- Couverture, regroupement et association des règles décidés dans le code, si bien que les gros changements ne sont pas survolés
- Commentaires posés et vérifiés par des modules distincts de positionnement et de réflexion
- Modes révision, balayage et délégation qui couvrent le terminal, les audits et les agents hôtes
- Gratuit et libre, avec des points d'accès compatibles OpenAI et Anthropic et un jeu de données de banc public
Ce qui ne fonctionne pas
- Rappel plus bas par choix, si bien que de vrais défauts passeront une révision propre
- Tous les chiffres vedettes du banc sont annoncés par le projet, sans passage indépendant trouvé
- Les coûts de modèle restent les vôtres à chaque révision en mode par défaut
- Les règles incluses varient selon le langage, et certains fichiers de règles de langage n'ont pas de section de sécurité
Lequel choisir
Choisissez Open Code Review si le bruit de révision est votre problème. Si votre réviseur IA actuel inonde une demande de fusion de commentaires que votre équipe a appris à ignorer, un outil réglé pour la précision est la bonne correction. Une courte liste de commentaires surtout réels sera lue. Une longue liste surtout faite de bruit apprend à tout le monde à sauter la liste.
Choisissez le si vous révisez de gros changements. Le regroupement et les sous agents isolés ont été bâtis pour des changements qui débordent une fenêtre de contexte. Les petits changements y gagnent moins, parce qu’un agent général peut tenir un petit changement entier sans aide.
Choisissez la délégation si votre agent est déjà choisi. Les équipes fixées sur Claude Code, Codex ou Cursor gardent leur modèle, leur compte et leurs habitudes, et ajoutent un choix de fichiers et des règles qu’elles n’avaient pas. C’est un changement moins cher que de changer d’agent pour courir après un banc.
Cherchez ailleurs si manquer un défaut coûte plus cher que le tri. Les audits de sécurité et le code critique pour la sûreté exigent le rappel en premier. Dans ces cadres, un réviseur bruyant avec un tri humain, ou cet outil plus un second passage d’un autre réviseur, convient mieux au risque qu’un premier passage silencieux seul. Prenez un résultat propre ici comme un bon signe, jamais comme une preuve.
Cherchez ailleurs si vous voulez un service hébergé sans installation. C’est un outil en ligne de commande que vous installez, configurez et tenez à jour vous même, avec votre propre compte de modèle derrière. Les équipes qui veulent qu’un fournisseur possède tout cela préféreront un produit de révision hébergé et paieront pour ce privilège.
Réflexions finales
Open Code Review est un argument sur la place de l’intelligence dans un outil. Sa réponse est démodée et persuasive : la plus grande part du processus ne devrait pas être intelligente du tout. Compter les fichiers, les grouper, associer les règles et placer les commentaires sont des travaux pour du code qui fait la même chose chaque fois. Le jugement est la ressource rare, et le modèle devrait y passer tout son effort.
Cette discipline achète des révisions plus sobres et une facture de jetons bien plus petite, et elle coûte du rappel, ce que le projet admet en langage clair. Pour la plupart des équipes qui se noient dans le bruit de révision, c’est le bon échange à essayer en premier, et le prix de l’essai est une commande d’installation et une comparaison honnête sur vos propres demandes de fusion.
Sources
- Produit, conception hybride, banc, commandes, modes et intégrations : dépôt Open Code Review, Alibaba, sur GitHub
- Documentation, configuration, délégation, MCP, visionneur de session et guides d’intégration continue : documentation Open Code Review
- Jeu de données du banc : AACR-Bench, publié par le projet sur Hugging Face
- Revue indépendante, dont le trou des fichiers de règles de langage : OpenCodeReview Review, FDE Interviews
- Captures d’écran et graphique du banc : projet Open Code Review
- Illustration principale : Dirty Static, générée dans le style maison
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.