Dirty Static // Le verdict
Une capacité que vous ne pouvez pas obtenir ailleurs sur un bureau, une vitesse que vous pouvez battre pour beaucoup moins d'argent.
Idéal pourLes développeurs et petits laboratoires qui ont besoin de prototyper et d'ajuster des modèles jusqu'à 200B de paramètres en privé, sur leur propre bureau
Ce qui fonctionne
- 128 Go de mémoire unifiée cohérente chargent des modèles jusqu'à 200B de paramètres qu'aucun GPU grand public seul ne peut contenir
- La pile logicielle NVIDIA complète arrive prête : DGX OS, CUDA, microservices NIM et livres de jeux dès le premier jour
- Le réseau ConnectX-7 à 200 Gb/s permet à deux unités de mettre en commun la mémoire et d'atteindre des modèles jusqu'à 405B de paramètres
- Matériel de classe petit et silencieux à 1,2 kilogramme et environ 240 watts, construit pour vivre sur un bureau à temps plein
Ce qui ne fonctionne pas
- La génération de jetons est lente pour son prix : 273 Go/s de bande passante mémoire plafonnent le décodage des modèles denses à un chiffre à 70B
- Le prix de 128 Go a grimpé de 3 999 $ au lancement à environ 6 950 $ en octobre 2026, une hausse d'environ 74 pour cent en un an
- Le nouveau modèle de 64 Go commence à 4 999 $, ce qui est 1 000 $ de plus que ce que le modèle de 128 Go coûtait au lancement
- Linux seulement, fondé sur Arm, et encore inégal aux endroits où la pile logicielle GB10 rencontre des outils construits pour les cartes de centre de données
Test fondé sur la recherche : basé sur des essais publiés, des spécifications et de la documentation, et non sur des essais pratiques.
Il y a un an, le DGX Spark était l’argument le plus facile en IA locale. Une petite boîte or, 128 Go de mémoire que le processeur et le GPU partagent, et des modèles sur votre bureau qui avaient besoin d’une salle de serveurs autrefois. Puis le prix a commencé à bouger. La machine lancée à 3 999 $ en octobre 2025 est montée à 4 699 $ en février 2026, et en octobre 2026 ServeTheHome a rapporté le modèle de 128 Go bougeant vers un niveau d’environ 6 950 $. Ce test concerne l’écart entre ce que le Spark fait uniquement et ce que NVIDIA facture maintenant pour lui.
Ce que c’est
Le DGX Spark est un ordinateur d’IA de bureau construit autour du GB10 Grace Blackwell Superchip, un boîtier à deux matrices que NVIDIA a développé avec MediaTek. Une matrice porte un processeur Arm de 20 cœurs. L’autre porte un GPU Blackwell, et les deux partagent un bassin de mémoire LPDDR5x par l’interconnexion NVLink-C2C. NVIDIA le vend comme un superordinateur d’IA personnel, et la traduction honnête est plus étroite : c’est un appareil de développement et de prototypage pour les gens qui travaillent sur de gros modèles et veulent ce travail local, privé et toujours activé.
Ce n’est pas un PC de jeu et ce n’est pas un poste de travail au sens habituel. Il fait tourner DGX OS, une construction Linux fondée sur Ubuntu, et rien d’autre. Il est livré avec la pile logicielle d’IA de NVIDIA installée, y compris l’outillage CUDA, des conteneurs, des microservices NIM, et une bibliothèque de livres de jeux pour des travaux courants comme servir des modèles avec vLLM et ajuster avec des cadres standard. NVIDIA énonce qu’une unité fait tourner l’inférence sur des modèles jusqu’à 200 milliards de paramètres et ajuste des modèles jusqu’à 70 milliards de paramètres. Ce sont des chiffres d’entreprise pour la capacité, et les tests publiés appuient l’affirmation de capacité tout en se disputant durement sur la vitesse qui vient avec elle.
Fonctions et spécifications
| Part | DGX Spark specification |
|---|---|
| Superpuce | NVIDIA GB10 Grace Blackwell, développée avec MediaTek, procédé de classe TSMC 3 nm |
| Processeur | 20 cœurs Arm : 10 cœurs de performance Cortex-X925 et 10 cœurs d’efficacité Cortex-A725 |
| GPU | Architecture Blackwell, 6 144 cœurs CUDA, cœurs Tensor de cinquième génération avec soutien FP4 |
| Calcul d’IA | Jusqu’à 1 pétaFLOP en FP4 avec parcimonie, selon NVIDIA |
| Mémoire | 128 Go LPDDR5x, cohérente et unifiée entre processeur et GPU, bande passante de 273 Go/s |
| Stockage | Jusqu’à 4 To NVMe M.2, à chiffrement automatique |
| Réseau | ConnectX-7 SmartNIC à 200 Gb/s, 10 GbE, Wi-Fi 7 |
| Ports | 4 USB-C, HDMI |
| Système d’exploitation | NVIDIA DGX OS, fondé sur Ubuntu |
| Taille et poids | 150 x 150 x 50,5 mm, 1,2 kg |
| Puissance | Environ 240 watts d’une prise standard |
| Capacité de modèles | Inférence jusqu’à 200B de paramètres et ajustement jusqu’à 70B sur une unité, selon NVIDIA |
Deux chiffres sur cette fiche font tout le travail. Le premier est 128 Go, le bassin de mémoire qui décide quels modèles tiennent. Le deuxième est 273 Go/s, la bande passante qui décide à quelle vitesse les jetons sortent une fois un modèle chargé. Pour l’échelle, un H100 de centre de données déplace les données à environ 3,35 To/s, plus de douze fois le taux. Chaque force et chaque plainte de ce test remonte à ce jumelage d’un immense bassin et d’un tuyau étroit.
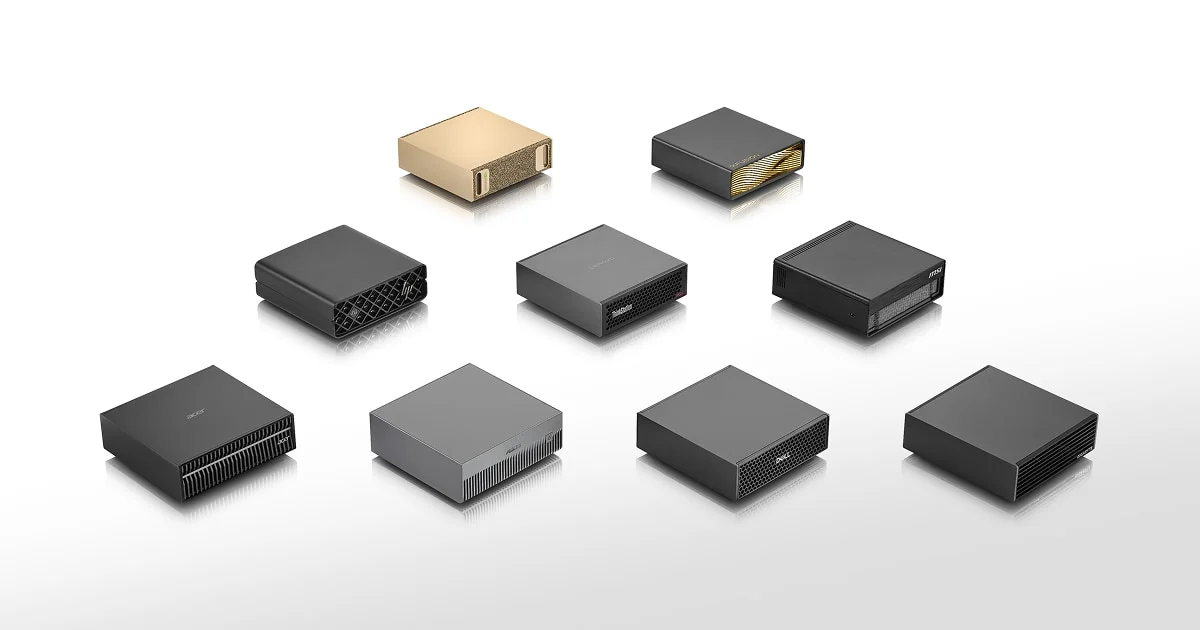
Le réseau mérite sa propre ligne. Le port ConnectX-7 est du matériel que la plupart des bureaux ne portent jamais, et il existe pour que deux Sparks puissent se lier directement et mettre en commun 256 Go de mémoire pour des modèles jusqu’à 405 milliards de paramètres, selon NVIDIA. En octobre 2026, NVIDIA a ajouté de l’outillage de grappe et une configuration de 64 Go, vendue seulement par Acer, ASUS, Dell, Gigabyte, HP et MSI à partir du 23 octobre, commençant à 4 999 $. NVIDIA dit qu’une unité de 64 Go prend en charge des modèles jusqu’à 100 milliards de paramètres, et que deux unités en grappe ont livré jusqu’à 1,7 fois la performance d’une unité dans son propre test Qwen 3.8 27B. Ce résultat de test est une affirmation d’entreprise, pas une mesure indépendante.
Expérience en conditions réelles
Ceci est un test de recherche, construit à partir des tests publiés par LMSYS, Ollama, ServeTheHome et d’autres plutôt que du temps pratique dans notre laboratoire. Le portrait que ces sources dessinent est constant, et il se divise proprement par type de modèle.
Sur les modèles parcimonieux, le Spark paraît fort. Ollama a mesuré sa propre construction de version sur le Spark et a enregistré le modèle gpt-oss de 120 milliards de paramètres, une conception mélange d’experts qui lit seulement une partie de ses poids par jeton, à environ 41 jetons par seconde de génération avec un traitement d’invites au dessus de 1 100 jetons par seconde. LMSYS, le groupe derrière le classement Chatbot Arena, a apporté le soutien SGLang pour gpt-oss au Spark et a rapporté environ 50 jetons par seconde sur le modèle 120B et environ 70 sur le modèle 20B. Pour un agent de codage local ou un assistant privé, c’est une vitesse pleinement utilisable sur des modèles qui ne peuvent simplement pas se charger sur un GPU normal.
Sur les modèles denses, la facture de bande passante arrive. LMSYS a mesuré le modèle gpt-oss 20B sous Ollama à 2 053 jetons par seconde de traitement d’invites et 49,7 jetons par seconde de génération. La même suite a placé le modèle dense Llama 3.1 70B à 2,7 jetons par seconde, plus lent que la plupart des gens lisent. Les résultats publiés pour les modèles denses de classe 32B siègent près de 10 jetons par seconde. Le motif ne change jamais : le traitement d’invites est rapide, le débit par lots est respectable, et une personne attendant sur un modèle dense sent chaque de ces 273 gigaoctets par seconde.
Vitesse de génération de jetons, jetons par seconde (plus haut est mieux)
Décodage à flux unique tiré de suites publiées. GPT-OSS 20B sous Ollama selon LMSYS; gpt-oss 120B selon les tests de version Ollama; Llama 3.1 70B selon LMSYS. Le type de modèle change le résultat plus que tout réglage.
L’histoire du logiciel est le contrepoids. Les testeurs et les équipes de bancs d’essai atterrissent sans cesse sur le même point : la pile fonctionne. DGX OS arrive avec pilotes, conteneurs et cadres en place, l’outillage Linux standard pour Ollama et llama.cpp s’installe de la façon ordinaire, et NVIDIA entretient des livres de jeux pour les travaux que les acheteurs font vraiment tourner. La friction qui reste est réelle mais précise. Le GPU GB10 utilise une variante d’architecture de classe grand public qui manque certaines fonctions de cœurs Tensor des cartes Blackwell de centre de données, et les cadres et noyaux précoces ont montré un soutien inégal que les mises à jour de micrologiciel et de logiciel ont en partie fermé pendant 2026. Budgétisez du temps pour cette classe de surprise si votre flux de travail s’appuie sur des versions fraîches.
Ce qui fonctionne
La capacité est le titre et elle tient. Un seul Spark charge et fait tourner un modèle de classe 120B ou 200B localement, sans compte en nuage, sans facture par jeton, et sans données quittant la salle. Pour le travail réglementé, le code privé et la recherche non publiée, cette propriété seule justifie un matériel qui paraît trop cher sur une fiche.
Le format est la deuxième vraie victoire. C’est de l’outillage de lignée de centre de données dans une boîte de 1,2 kilogramme qui tire environ 240 watts et siège sur un bureau sans drame. Une grappe de deux unités tient dans une boîte à chaussures et met en commun 256 Go. Rien dans le marché PC n’égale cette densité de mémoire d’IA utilisable par litre.
La troisième victoire est la rampe. Parce que le Spark fait tourner la même pile centrée sur CUDA que les gros systèmes DGX, le travail prototypé sur un bureau bouge vers du matériel de centre de données loué ou possédé sans réécriture. Des équipes à des lieux comme Stanford ont utilisé des Sparks exactement ainsi, prototypant des pipelines complets localement avant de les mettre à l’échelle vers des grappes. Ce chemin, du bureau au centre de données sur une pile, est le produit que NVIDIA vend vraiment.
Ce qui ne fonctionne pas
La vitesse par dollar est pauvre, et elle a empiré à mesure que le prix montait. Une RTX 5090 génère des jetons environ quatre fois plus vite qu’un Spark sur le modèle 20B que les deux peuvent faire tourner, et un PC fondé sur une 5090 coûte moins qu’un Spark maintenant. Le Spark gagne seulement là où la 5090 ne peut pas concurrencer du tout, ce qui est au delà de 32 Go de modèle. Les acheteurs dont les modèles tiennent dans un GPU grand public obtiennent beaucoup plus de vitesse pour beaucoup moins d’argent ailleurs.
Prix du DGX Spark 128 Go, USD
Prix de lancement de la Founders Edition en octobre 2025; NVIDIA a relevé le PDSF en février 2026 en citant des limites d'offre de mémoire; le niveau d'octobre 2026 est tel que rapporté par ServeTheHome, avec des prix partenaires variables selon le fournisseur.
Le chemin de prix est la partie la plus dure de ce test à défendre. Une hausse d’environ 74 pour cent en un an, blâmée sur les coûts de mémoire, a transformé un achat étiré en une décision d’approvisionnement. Le nouveau modèle de 64 Go rend le cadrage pire : à 4 999 $, il coûte 1 000 $ de plus que le modèle de 128 Go au lancement tout en offrant la moitié de la mémoire qui est tout l’intérêt de la plateforme. ServeTheHome a appelé 4 999 $ pour une machine de 64 Go assez élevé et 6 950 $ pour la machine de 128 Go élevé. C’est un résumé juste de la réaction du marché.
Enfin, la plateforme demande un engagement. Elle est Linux seulement et fondée sur Arm, alors le logiciel Windows et les habitudes x86 restent derrière. Le stockage et la mémoire sont fixés à l’achat. Et la logique de revente et de mise à niveau d’un PC normal ne s’applique pas : quand vous dépassez un Spark, vous achetez un deuxième Spark ou vous quittez la plateforme.
Concurrence
| Option | Memory | Memory bandwidth | Price (USD) | The trade |
|---|---|---|---|---|
| NVIDIA DGX Spark 128GB | 128GB unified | 273 GB/s | About $6,950 | La pile NVIDIA complète et la grappe ConnectX-7, à un prix abrupt et montant |
| NVIDIA DGX Spark 64GB | 64GB unified | 273 GB/s | From $4,999 | Même puce et pile, la moitié de la capacité qui définit la plateforme |
| RTX 5090 PC | 32GB GDDR7 | About 1.79 TB/s | Varies, typically less than a Spark | Environ quatre fois la vitesse de jetons sur les modèles qui tiennent, et aucun chemin au delà de 32 Go |
| AMD Ryzen AI Halo (Strix Halo) | 128GB unified | 256 GB/s | $3,999 | Même classe de capacité pour beaucoup moins d’argent, sur une pile logicielle plus jeune sans CUDA |
| Apple Mac Studio | 96GB to 512GB unified, by configuration | Up to 819 GB/s on M3 Ultra configurations | From $3,999 at M3 Ultra launch | Beaucoup plus de bande passante et un bureau poli, mais macOS et aucune pile NVIDIA |
| Rented H100 class cloud GPU | 80GB HBM and up | About 3.35 TB/s | Hourly, varies by provider | Vraie vitesse de centre de données sans matériel à posséder, facturée pour toujours et hors site |
Le tableau montre le Spark serré des deux côtés. En dessous de lui, les systèmes Strix Halo et le Framework Desktop offrent 128 Go de mémoire unifiée pour des milliers de moins, et ils continuent de s’améliorer. Au dessus de lui, les GPU en nuage offrent un ordre de grandeur de bande passante de plus sans coût en capital. Le Spark tient le milieu sur deux actifs qu’aucun côté n’égale aujourd’hui : la pile logicielle CUDA et DGX mature dans une boîte aussi petite, et la grappe à 200 Gb/s intégrée de l’usine.
Verdict final
Achetez le DGX Spark si votre travail a besoin de modèles entre environ 70B et 200B de paramètres tournant localement, en privé et chaque jour, et si votre chemin mène vers du matériel de centre de données NVIDIA plus tard. Pour cet acheteur, la capacité et la pile valent de l’argent, les limites de vitesse sont des quantités connues, et les solutions de rechange abandonnent chacune quelque chose qui compte. Achetez le au niveau partenaire si vous pouvez trouver un prix sous le niveau supérieur, et favorisez le modèle de 128 Go, parce que la mémoire est tout l’argument pour cette machine.
Évitez le si vos modèles tiennent dans 32 Go, si vous servez de nombreux utilisateurs à la fois, ou si le prix compte plus que la provenance. Un système RTX 5090 est plus rapide à tout ce qu’il peut charger. Une boîte Strix Halo contient presque autant pour beaucoup moins. Le nuage vous loue douze fois la bande passante à l’heure. Il y a un an, à 3 999 $, le Spark était une recommandation facile pour les constructeurs d’IA locale. À environ 6 950 $, c’est un outil de spécialiste avec un prix de spécialiste, excellent à exactement un travail et honnête sur aucune de ses limites dans la brochure. Le travail est réel. La facture aussi.
Ceci est un test de recherche. Il tire de la documentation de produit NVIDIA et de son annonce DGX Spark 64 Go d’octobre 2026, des suites de bancs d’essai publiées par LMSYS et Ollama, et des reportages de prix de ServeTheHome, vérifiés en octobre 2026. Aucun test pratique n’a été effectué.
Sources
- NVIDIA: DGX Spark product page
- NVIDIA via ServeTheHome: DGX Spark 64GB launched and big 128GB GB10 price increases
- LMSYS: Optimizing GPT-OSS on NVIDIA DGX Spark
- Ollama: NVIDIA DGX Spark performance
- GPU Smith: NVIDIA DGX Spark review, price, specs and performance
- Product images: NVIDIA
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.

