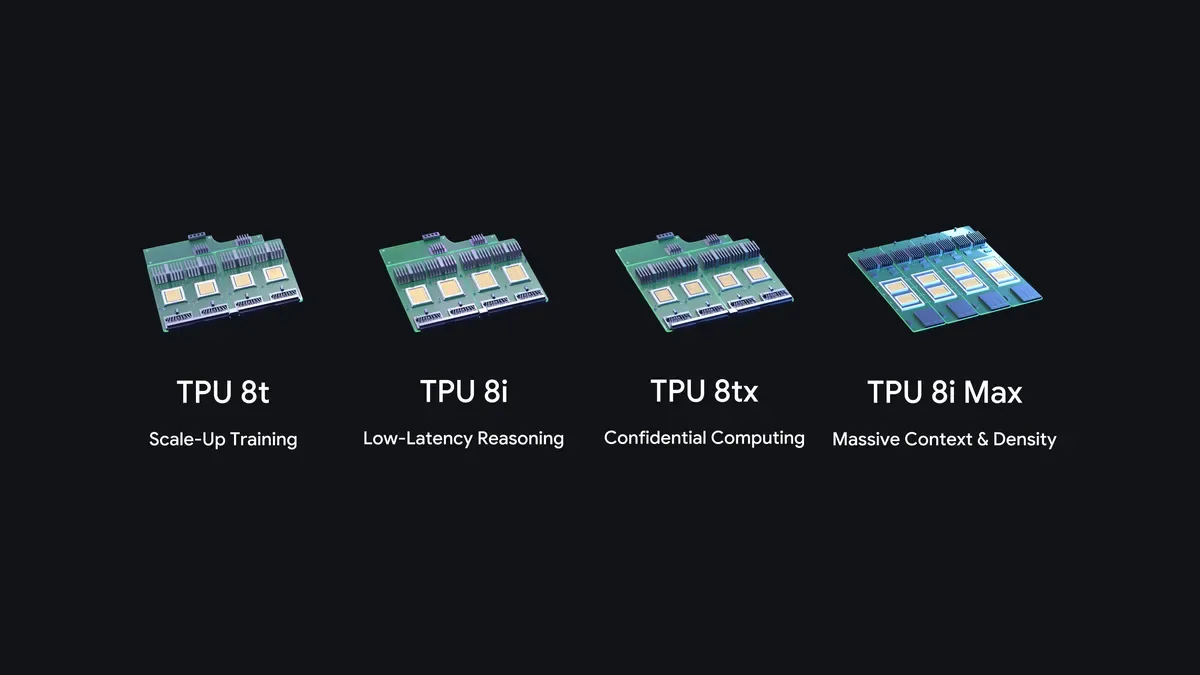
Google a élargi sa famille de processeurs tenseurs, les Tensor Processing Unit, de huitième génération le 9 novembre, en ajoutant le TPU 8tx pour l’inférence sécurisée et confidentielle et le TPU 8i Max pour les fenêtres de contexte massives. Un Tensor Processing Unit, ou TPU, est une puce que Google conçoit lui même pour les travaux d’IA. Ces deux nouveaux systèmes portent à quatre le nombre de systèmes TPU lancés en une seule année, ce qui est une première selon Google.
Aucun des deux systèmes n’est une toute nouvelle puce. Google les a tous deux construits à partir de silicium présenté en avril lors de Google Cloud Next, le TPU 8t pour l’entraînement à grande échelle et le TPU 8i pour le raisonnement en temps réel. La nouveauté ici tient à la façon dont Google reconditionne ce silicium autour de deux problèmes que les clients ne cessent de nommer : protéger les données sensibles pendant qu’un modèle les utilise, et fournir à un modèle beaucoup plus de contexte sans ralentissement.
L’annonce
Le TPU 8tx est le pari sur la sécurité. Les données sont normalement chiffrées lorsqu’elles sont stockées et lorsqu’elles circulent sur un réseau, mais elles doivent être déverrouillées en mémoire pendant qu’un ordinateur travaille dessus. Google affirme que le TPU 8tx intègre la protection dans la couche matérielle, en gardant les données sensibles et les poids du modèle protégés et isolés même pendant leur utilisation active.
Le système utilise le même silicium que le TPU 8t et l’associe à des hôtes CPU AMD EPYC de cinquième génération. AMD a déclaré le 9 novembre que sa technologie Secure Encrypted Virtualization aide à étendre cette protection du CPU hôte aux accélérateurs connectés, et a qualifié le TPU 8tx de premier système TPU infonuagique doté d’un informatique confidentielle imposée par le matériel. Cette affirmation de primauté vient d’AMD et de Google, et non d’un audit externe publié au moment du lancement.
Google affirme aussi que le TPU 8tx adopte le réseau Boardfly qu’il a construit pour le TPU 8i, avec une latence jusqu’à deux fois plus faible que celle du TPU 8t et une pénalité de performance presque nulle. Il faut lire cela comme une affirmation de l’entreprise. Aucun test indépendant de l’un ou l’autre des nouveaux systèmes n’est apparu dans la couverture du lancement, et Google n’a publié aucun tableau de référence qu’un acheteur pourrait vérifier sur sa propre charge de travail.
Le TPU 8i Max est le pari sur la mémoire. Une fenêtre de contexte est la quantité de matériel qu’un modèle peut garder à l’esprit pendant une seule demande, comme une base de code entière ou des heures de vidéo. Google a pris deux puces TPU 8i et les a combinées dans un seul boîtier. L’entreprise affirme que le résultat double la puissance de calcul, double la SRAM et double la bande passante de la mémoire à large bande par rapport au TPU 8i, et loge deux fois plus de silicium dans la même empreinte de bâti.
Détails importants
| Système | Travail | Base |
|---|---|---|
| TPU 8t | Entraînement à grande échelle | Présenté en avril 2026 |
| TPU 8i | Raisonnement en temps réel | Présenté en avril 2026 |
| TPU 8tx | Inférence confidentielle, entraînement à plus petite échelle | Silicium du TPU 8t, hôtes AMD EPYC de cinquième génération, réseau Boardfly |
| TPU 8i Max | Fenêtres de contexte massives, densité de calcul la plus élevée par bâti | Deux puces TPU 8i dans un seul boîtier |
Google a remis dans le même billet les chiffres de la famille datant d’avril. L’entreprise affirme que le TPU 8t offre jusqu’à 2,7 fois de meilleures performances d’entraînement que la génération précédente, et que le TPU 8i offre un rapport prix performance en inférence supérieur de 80 pour cent. Les deux chiffres sont des comparaisons de Google avec sa propre génération précédente, énoncées dans sa propre annonce.
Le lancement comprenait aussi des nouvelles logicielles autour des puces. Google a dit que TorchTPU, mis en code source ouvert le mois dernier, permet au code PyTorch et aux modèles Hugging Face de fonctionner sur les TPU sans réécriture du code. L’entreprise a dit que TPU Sync, maintenant en code source ouvert, répartit les grands caches de paires clé valeur hors de la puce et affirme réduire de plus de 90 pour cent la latence des transferts de cache et le délai avant le premier jeton, selon sa propre description. Cloud Pathways et le découpage dynamique sur Google Kubernetes Engine ont été décrits comme généralement disponibles. Ces affirmations logicielles comptent, parce qu’une puce qu’une équipe ne peut pas programmer facilement est une puce qu’elle n’achètera pas.
Google affirme que les TPU servent maintenant près de 100 clients, dont des laboratoires de pointe, des sociétés de négociation, des détaillants et des universités. L’entreprise n’en a nommé aucun dans cette annonce. Nous avons déjà suivi Google en train de construire des parties plus étranges de cette même pile, dans Google Suncatcher, et le schéma se maintient : l’ambition est réelle, la preuve par les clients est plus mince que le détail matériel.
La suite
Les faits confirmés s’arrêtent tôt, et les lecteurs devraient remarquer à quel endroit. L’annonce de Google du 9 novembre n’indique aucun prix et aucune date de sortie précise pour l’un ou l’autre système. Des reportages de Bloomberg, cités dans la couverture spécialisée du lancement, ont dit que les deux systèmes seront disponibles l’an prochain. Google lui même n’a pas mis cette date dans son propre billet, il faut donc traiter l’an prochain comme une information rapportée, et non annoncée.
Les questions ouvertes sont celles qu’un acheteur poserait en premier. Combien coûtera chaque système à l’heure, dans quelles régions fonctionnera t il, et quelle preuve un client réglementé obtiendra t il que le mode confidentiel fonctionne comme décrit ? AMD décrit des vérifications matérielles de l’identité de l’accélérateur et de sa configuration de sécurité, mais aucune des deux entreprises n’a publié au lancement une conception complète qu’une équipe de sécurité pourrait examiner.
La conclusion est plus étroite que le titre annonçant quatre systèmes en un an. Google ne vend plus une seule forme de TPU en demandant à chaque charge de travail de s’y adapter. L’entreprise divise la gamme par travail : entraîner, raisonner, protéger et se souvenir. Que cette division arrache des clients à Nvidia dépendra des deux chiffres que Google n’a pas donnés lundi, le prix et une date.
Faits vérifiés le 10 novembre 2026, à partir des annonces de Google et d’AMD datées du 9 novembre 2026.
Sources
- Google, Introducing TPU 8tx and TPU 8i Max, 9 novembre 2026 : https://blog.google/innovation-and-ai/infrastructure-and-cloud/global-network/tpu-8i-max-and-8tx/
- AMD Newsroom, AMD EPYC Expands Its Leadership at the Foundation of AI, 9 novembre 2026 : https://newsroom.amd.com/news/amd-epyc-expands-leadership-foundation-ai/
- SiliconANGLE, Google advances agentic AI custom silicon expanding TPU family with 8tx and 8i Max, 9 novembre 2026 : https://siliconangle.com/2026/11/09/google-advances-agentic-ai-custom-silicon-expanding-tpu-family-with-8tx-and-8i-max/
- Image de la famille : Google
FIN DE LA TRANSMISSION
Restez curieux. Remettez tout en question.

